Redis 和 Caffeine 的区别是什么?
一则或许对你有用的小广告
欢迎加入小哈的星球,你将获得:专属的实战项目(4个项目都能学) / 1v1 提问 / 简历修改 / Java 学习路线 / 社群讨论 / 学习打卡 / 每月赠书
《Spring AI 项目实战(问答机器人、RAG 智能客服、联网搜索)》已完结,基于
Spring AI + Spring Boot 3.x + JDK 21...,查看介绍《从零手撸:仿小红书(微服务架构)》 已完结,基于
Spring Cloud Alibaba + Spring Boot 3.x + JDK 17...,查看介绍;演示链接:http://116.62.199.48:7070/《从零手撸:前后端分离博客项目(全栈开发)》 2 期已完结,演示链接:http://116.62.199.48/
新开坑项目:《从零手撸:秒杀系统高并发优化实战》 正在更新中...,查看介绍
截止目前,星球内专栏累计输出 150w+ 字,讲解图 5110+ 张,还在持续爆肝中.. 后续还会上新更多项目,已有 4700+ 小伙伴加入学习,欢迎点击围观
面试考察点
-
缓存体系认知:面试官想看的不只是你能不能区分这两个组件,更想看你脑子里的缓存体系立不立体,本地缓存、分布式缓存各解决什么问题,什么场景选谁。
-
架构视角:两者不是竞品,是不同层面的组件。能不能讲清楚 “进程内” 和 “独立中间件” 的架构差异,考的就是你的架构功底。
-
实战经验:加分项是多级缓存。如果你能主动聊到 “Caffeine + Redis 组合拳” 以及本地缓存的一致性难题,面试官眼睛会亮。
核心答案
先甩结论:Redis 是独立部署的分布式缓存中间件,Caffeine 是嵌入 JVM 进程的本地缓存库。一个是跨网络的公共服务,一个是揣在应用自己兜里的口袋。两者不是二选一的关系,生产上更多是搭档。
| 对比维度 | Redis | Caffeine |
|---|---|---|
| 部署形态 | 独立进程,网络访问 | 嵌入应用 JVM,进程内调用 |
| 访问开销 | 毫秒级,有网络 RTT | 纳秒级,方法调用直达 |
| 数据结构 | String、Hash、List、Set、ZSet 等丰富类型 | 纯 key-value,类似 ConcurrentMap |
| 容量上限 | 独立机器内存,可以很大 | 受 JVM 堆内存限制 |
| 多实例共享 | 天然共享,数据一致 | 各实例独立一份,有一致性问题 |
| 附加能力 | 持久化、主从、集群、发布订阅、Lua | 淘汰算法、过期策略、命中率统计 |
| 典型场景 | 分布式系统共享缓存 | 单实例热点数据加速 |
记一句话:Redis 强在 “共享”,Caffeine 强在 “快”。
深度解析
一、架构形态的根本差异
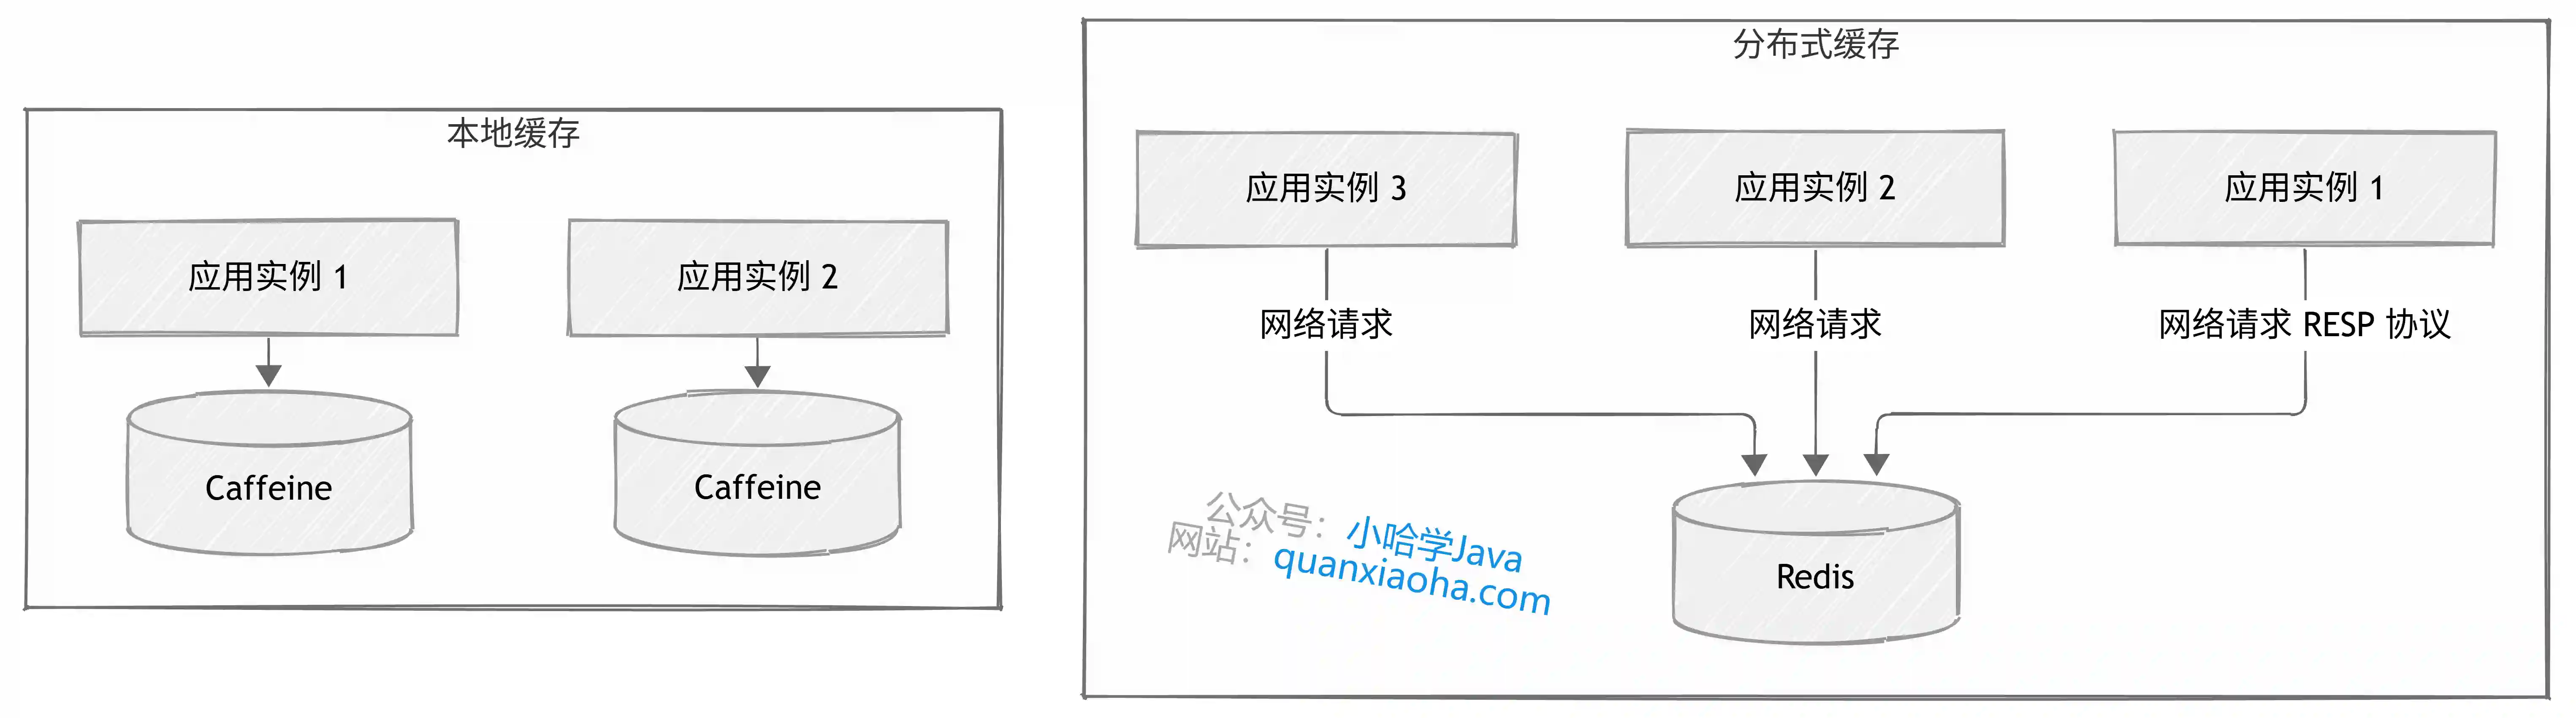
上图是两者最本质的区别,分两层来看:
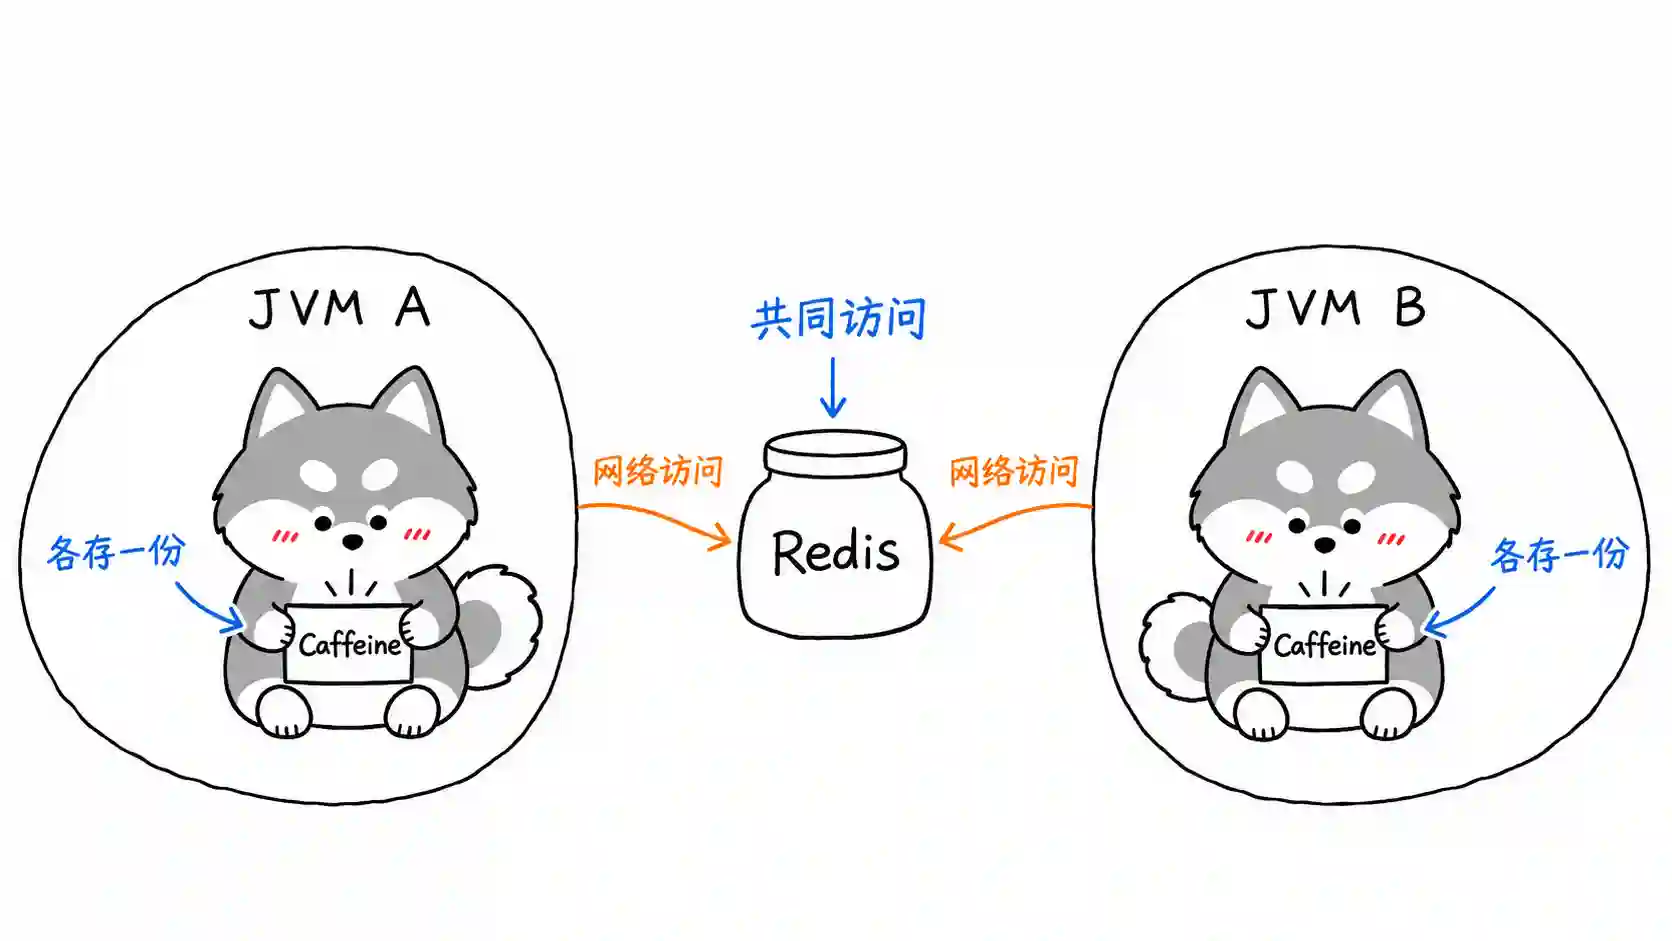
- Redis 是独立进程:应用和 Redis 之间隔着网络,每次读写都是一次网络往返(单机 Redis 轻松 10 万 QPS,但网络 RTT 躲不掉)。好处是三个应用实例访问的是同一份数据,天然共享。
- Caffeine 是一个 Jar 包:编译进你的应用,缓存就在自家 JVM 堆里,读写就是一次方法调用,连序列化都省了。代价是每个实例各存一份,谁也看不见谁。
二、性能差距不在一个量级
本地缓存读一次是纳秒到微秒级,Redis 再快也得算上网络往返,局域网内一次往返通常 0.5ms 起步。别小看这个差距,高并发热点场景下 QPS 一上来,网络 IO 的开销会被放大一千倍,直接成为瓶颈。
不过 Caffeine 快归快,有个硬伤:数据在 JVM 堆里,容量和 GC 都有压力。塞太多对象,Full GC 会教你做人。所以本地缓存一般只放少量极热点数据,容量上限一定得设。
三、淘汰算法:W-TinyLFU 是 Caffeine 的招牌
面试官听到你聊淘汰算法,就知道你真用过。
- Redis 默认策略下靠过期删除(惰性 + 定期),内存满时触发淘汰,支持 8 种策略(
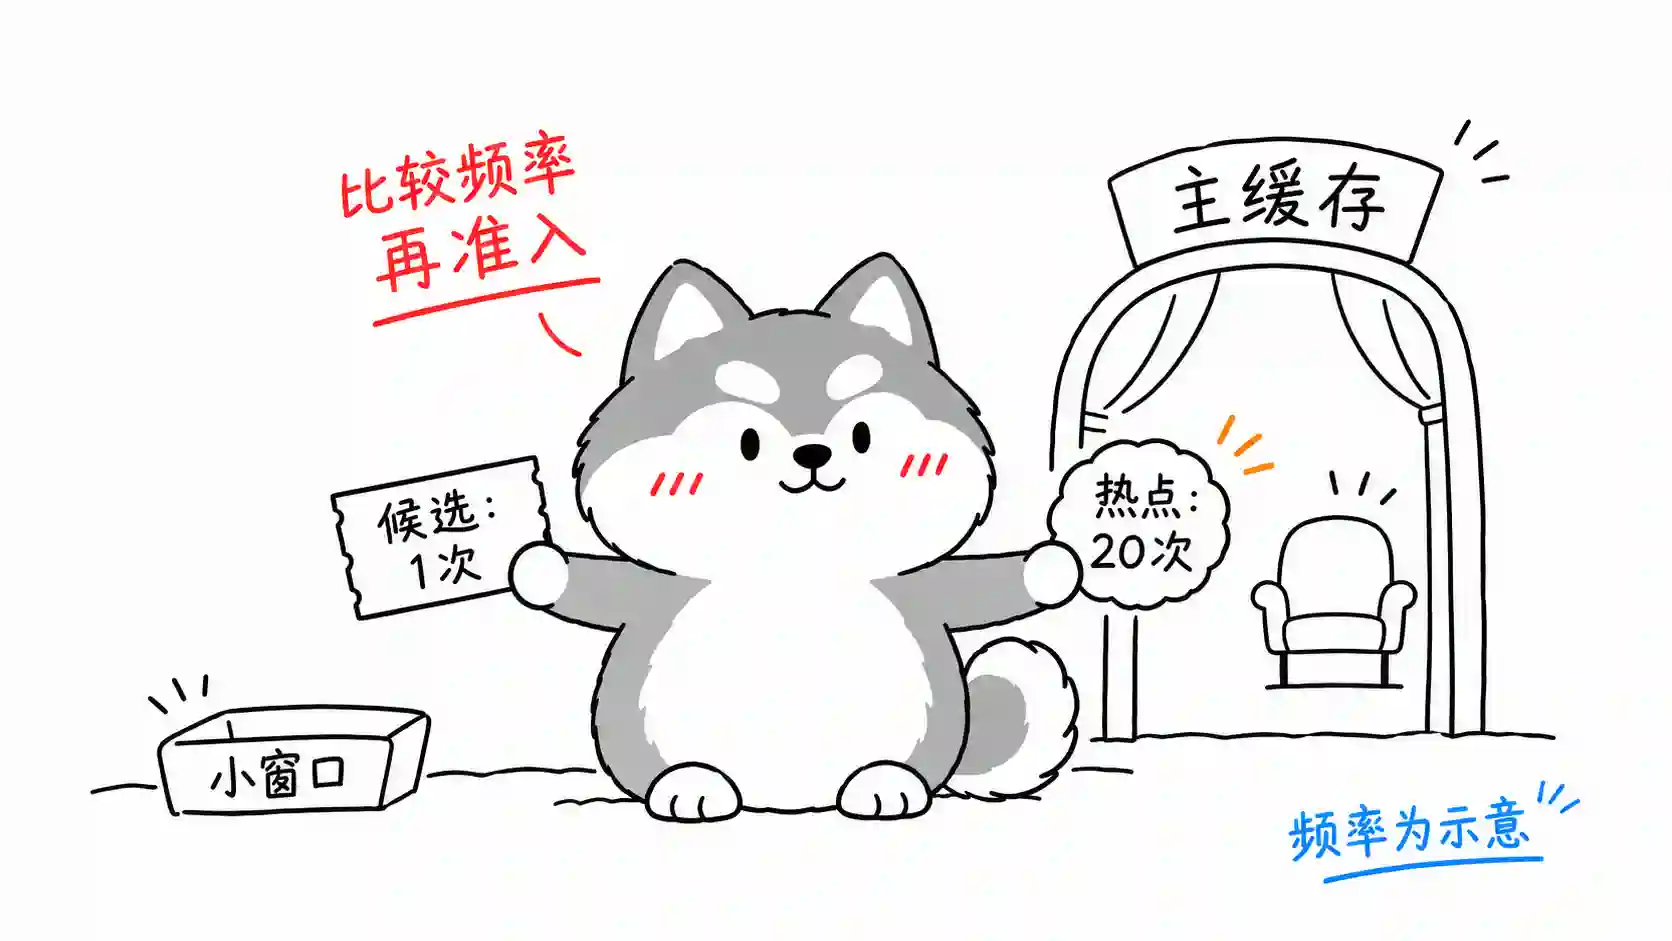
noeviction、allkeys-lru、allkeys-lfu等,LFU 是 4.0 引入的)。 - Caffeine 用的是自研的 W-TinyLFU 算法。简单说,新数据先进一个小的 LRU 窗口,窗口满了往主区域挤的时候,TinyLFU 拿 Count-Min Sketch 统计的访问频率做门槛——新数据的频率高过被淘汰的候选者,才准进;频率统计还会周期性减半,让老热度慢慢褪去。这样既防得住偶发的批量扫描把热点全冲掉,又留得住长期热点,命中率比传统 LRU 高不少。
四、分布式环境下的经典难题:本地缓存一致性
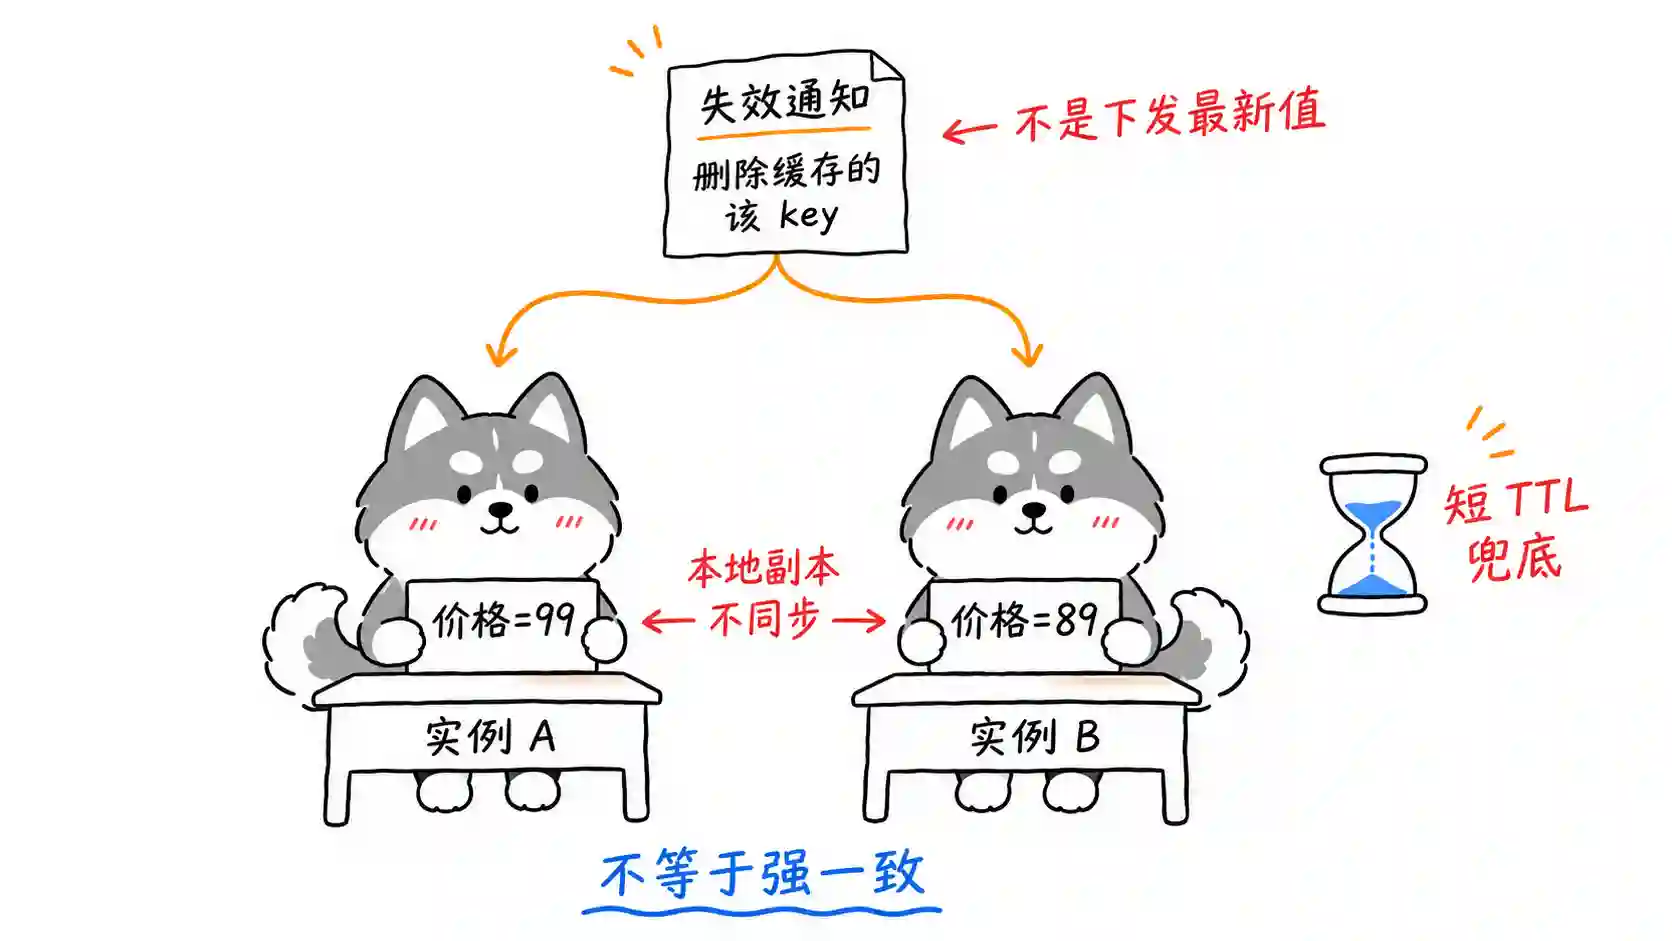
Caffeine 单机用着爽,但服务一旦多实例部署,问题就来了:实例 A 更新了自己的本地缓存,实例 B 还揣着旧数据,用户两次请求打到不同实例,看到的数据来回跳。
常见解法:
- 消息广播失效:数据变更时通过 Redis 的发布订阅、或者 MQ 广播一条失效消息,各实例收到后清掉对应 key;
- 短过期时间兜底:本地缓存 TTL 设得很短(比如几秒),就算广播丢了,最多脏一小会儿;
- 只缓存几乎不变的数据:配置、字典类数据,变更频率低,问题自然小。
五、生产最佳实践:多级缓存
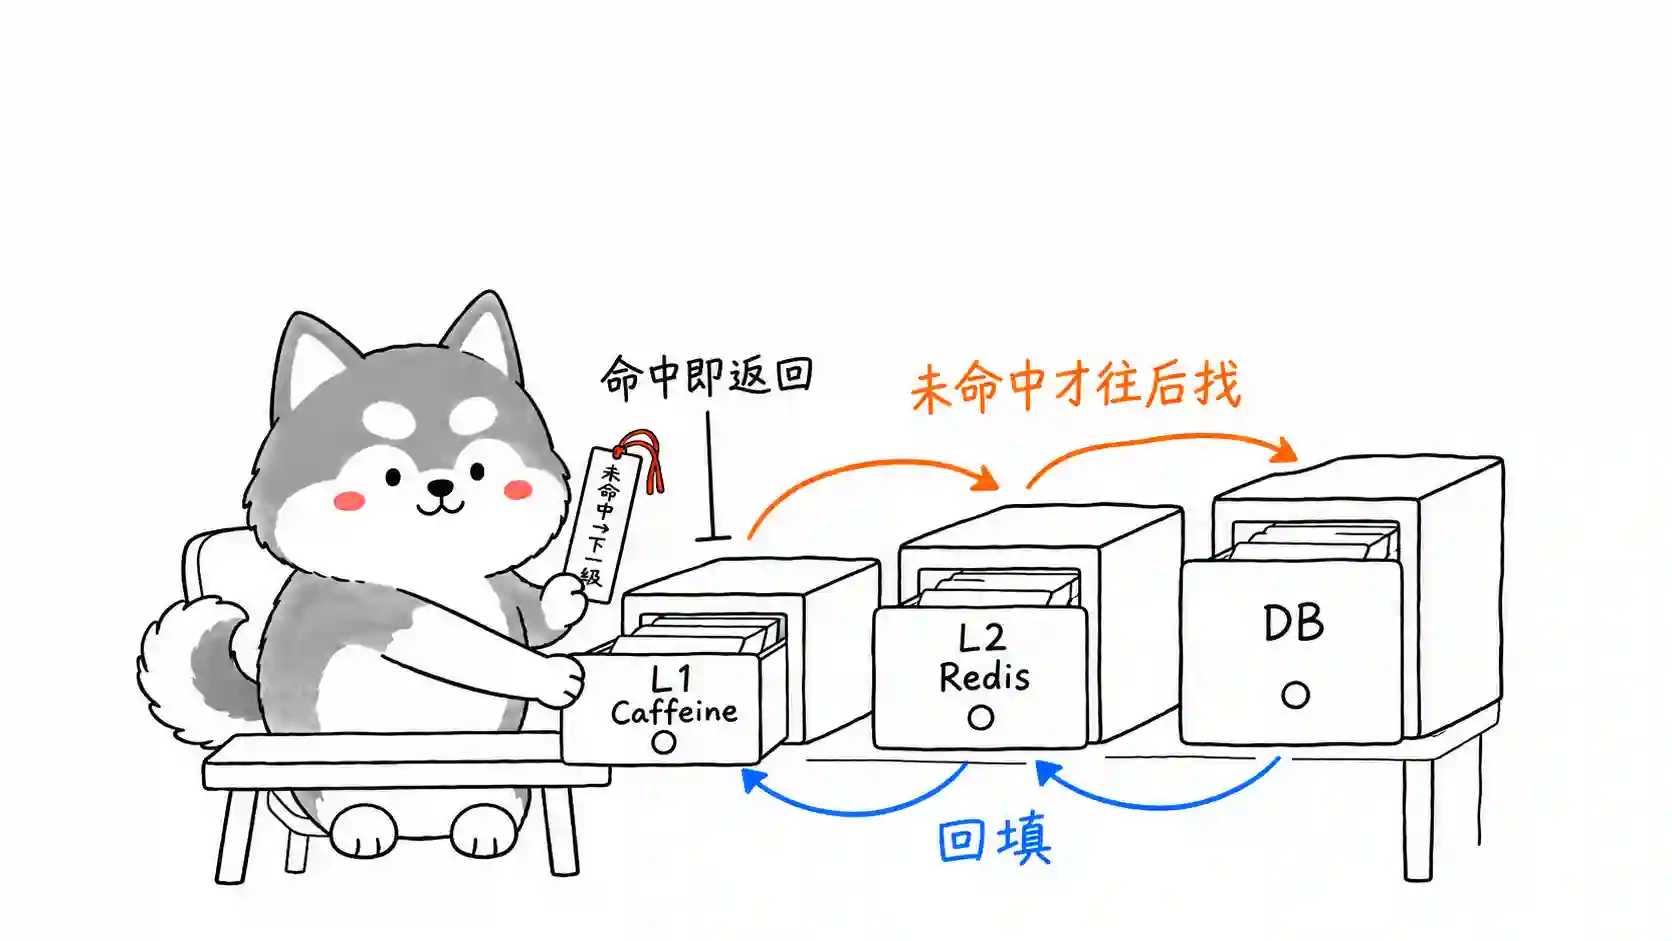
真实项目里这俩经常搭档出场,经典链路长这样:
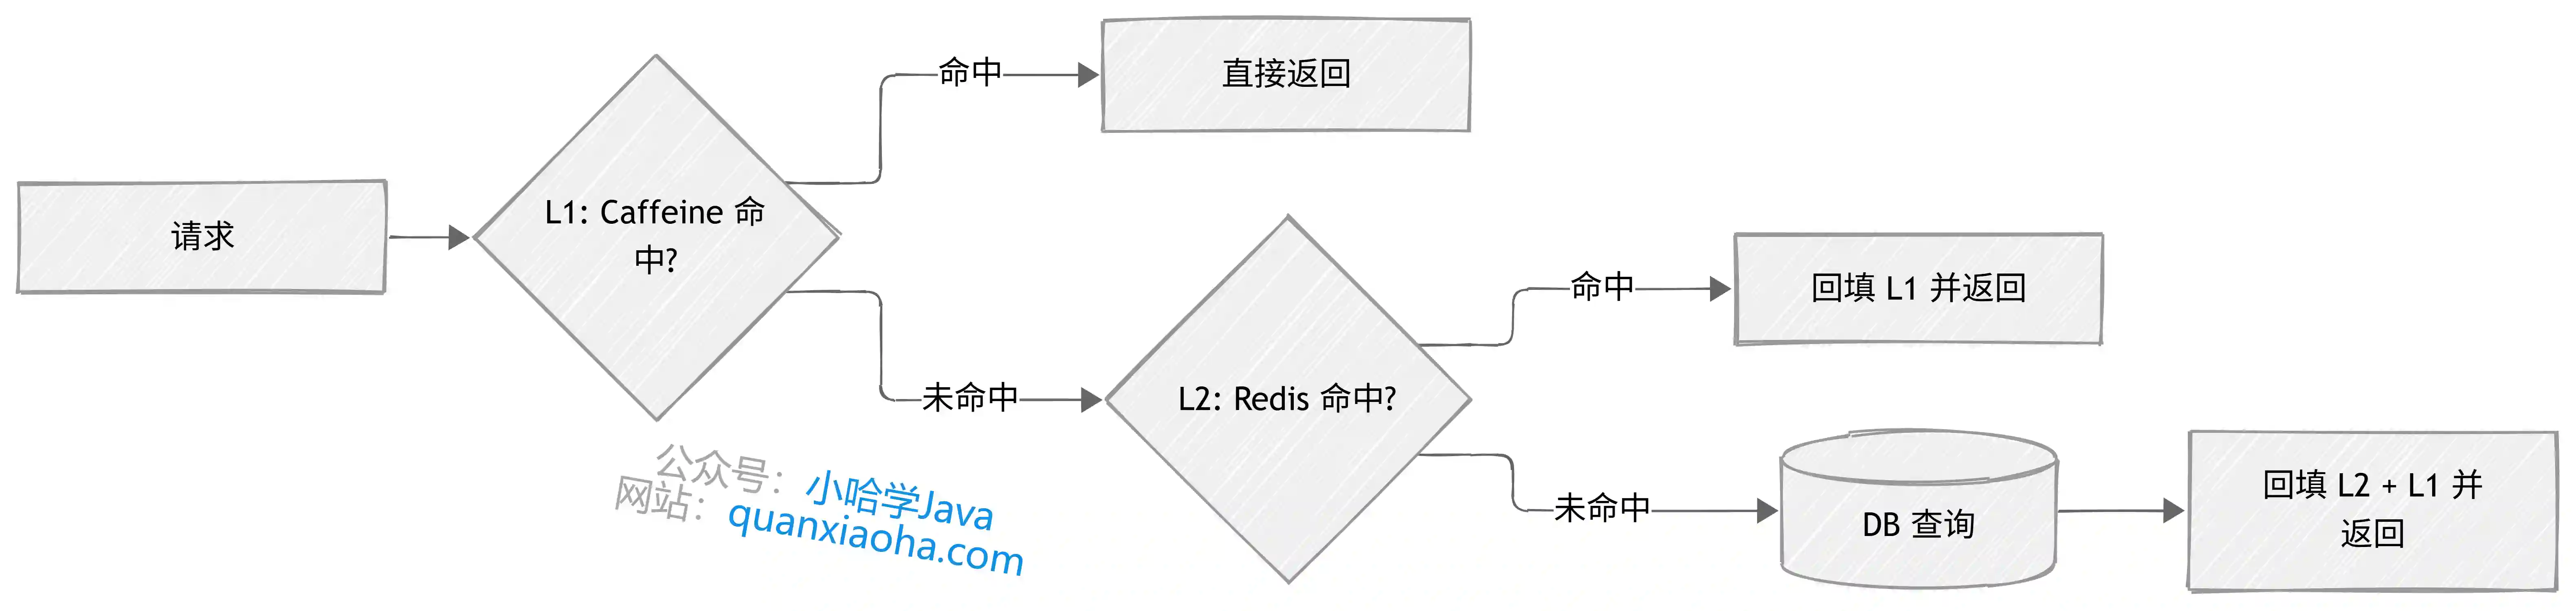
流程说明:
- L1 用 Caffeine 扛住最热的那部分流量,纳秒级响应,把绝大多数请求拦在本地;
- L2 用 Redis 做共享缓存,未命中 DB 才放行;
- 两层容量和 TTL 要拉开梯度:L1 容量小、TTL 短;L2 容量大、TTL 长。
Spring 侧落地很省事,spring-cache 两个都适配,@Cacheable 注解切个实现就行:
// 手动方式更直观,感受一下 Caffeine 的 API
Cache<String, User> cache = Caffeine.newBuilder()
        .maximumSize(10_000)          // 容量上限,防止撑爆堆
        .expireAfterWrite(5, TimeUnit.SECONDS)  // 短 TTL 兜底一致性
        .recordStats()                // 开启命中率统计
        .build();

User user = cache.get(userId, id -> queryFromRedis(id));  // 未命中自动加载
面试高频追问
- 本地缓存更新了,其他节点怎么感知? —— 上文第四节的广播失效 + 短 TTL 组合拳,这是标准答案。
- Caffeine 的 W-TinyLFU 比 LRU 好在哪? —— 防扫描污染:一次性批量访问不会把真正的热点挤出去。
- 什么数据适合放本地缓存? —— 读多写少、体量小、一致性要求不苛刻的热点数据(如首页配置、商品类目)。
- Guava Cache 和 Caffeine 什么关系? —— 同一作者,Caffeine 是 Guava Cache 的精神续作,性能和命中率全面胜出,新项目无脑选 Caffeine。
常见面试变体
- “本地缓存和分布式缓存的区别?”(本质同题,换了个问法)
- “为什么有了 Redis 还要本地缓存?”
- “设计一个多级缓存架构,怎么保证缓存一致性?”
记忆口诀
Redis 共享跨网络,Caffeine 进程快如电;热点本地兜,共享 Redis 管,两级一组合,DB 压力减一半。
总结
一句话:Redis 是独立部署的分布式缓存,赢在共享和大容量;Caffeine 是 JVM 进程内本地缓存,赢在纳秒级速度和 W-TinyLFU 的高命中率。生产环境两者不是单选题,经典的 “Caffeine + Redis” 多级缓存才是标准答案,配上广播失效和短 TTL 解决一致性问题,这套组合讲出来,这道题就稳稳拿下了。