Kafka 高水位了解过吗?为什么 Kafka 需要 LeaderEpoch?
一则或许对你有用的小广告
欢迎加入小哈的星球,你将获得:专属的实战项目(4个项目都能学) / 1v1 提问 / 简历修改 / Java 学习路线 / 社群讨论 / 学习打卡 / 每月赠书
《Spring AI 项目实战(问答机器人、RAG 智能客服、联网搜索)》已完结,基于
Spring AI + Spring Boot 3.x + JDK 21...,查看介绍《从零手撸:仿小红书(微服务架构)》 已完结,基于
Spring Cloud Alibaba + Spring Boot 3.x + JDK 17...,查看介绍;演示链接:http://116.62.199.48:7070/《从零手撸:前后端分离博客项目(全栈开发)》 2 期已完结,演示链接:http://116.62.199.48/
新开坑项目:《从零手撸:秒杀系统高并发优化实战》 正在更新中...,查看介绍
截止目前,星球内专栏累计输出 150w+ 字,讲解图 5110+ 张,还在持续爆肝中.. 后续还会上新更多项目,已有 4700+ 小伙伴加入学习,欢迎点击围观
面试考察点
-
副本机制理解深度:HW 和 LEO 是 Kafka 副本同步的核心概念,面试官想看的是你能不能把 Leader/Follower 之间怎么同步、怎么算“已提交”讲成一条线,光背两个名词是不够的。
-
故障场景推演能力:基于 HW 的旧截断机制有数据丢失和日志分叉两个经典事故场景,能不能把这两个场景一步步推演出来,最见功力。
-
版本演进敏感度:LeaderEpoch 是 Kafka 0.11 引入的(KIP-101),知道旧机制的病根和新机制的解法,说明你对 Kafka 一致性的演进有关注,这是加分项。
核心答案
先甩结论:
- 高水位(HW,High Watermark) 定义了消息的可见性边界:消费者只能拉取到 HW 之前的消息,HW 之后的消息即使已经写到 Leader 日志里,也对消费者不可见。对 Leader 来说,HW = ISR 中所有副本 LEO 的最小值。
- LEO(Log End Offset) 是日志末端位移,也就是下一条待写入消息的 offset。任意时刻 HW ≤ LEO。
- 旧版 Kafka 用 HW 作为副本截断的依据,存在两个经典问题:副本恢复时可能丢数据,还可能造成各副本日志不一致(分叉)。
- Kafka 0.11 引入 LeaderEpoch(KIP-101):每个 Partition 维护一个单调递增的 epoch,每次 Leader 换届就 +1。Follower 恢复后不再按本地 HW 盲目截断,而是先拿着 epoch 去问 Leader“这个 epoch 对应的日志末端在哪”,再决定截断还是继续同步。一句话:用精确的日志位置取代有延迟的 HW 做截断依据,既不丢数据,也不分叉。
深度解析
一、先把 HW 和 LEO 这对概念捋直
先看图:
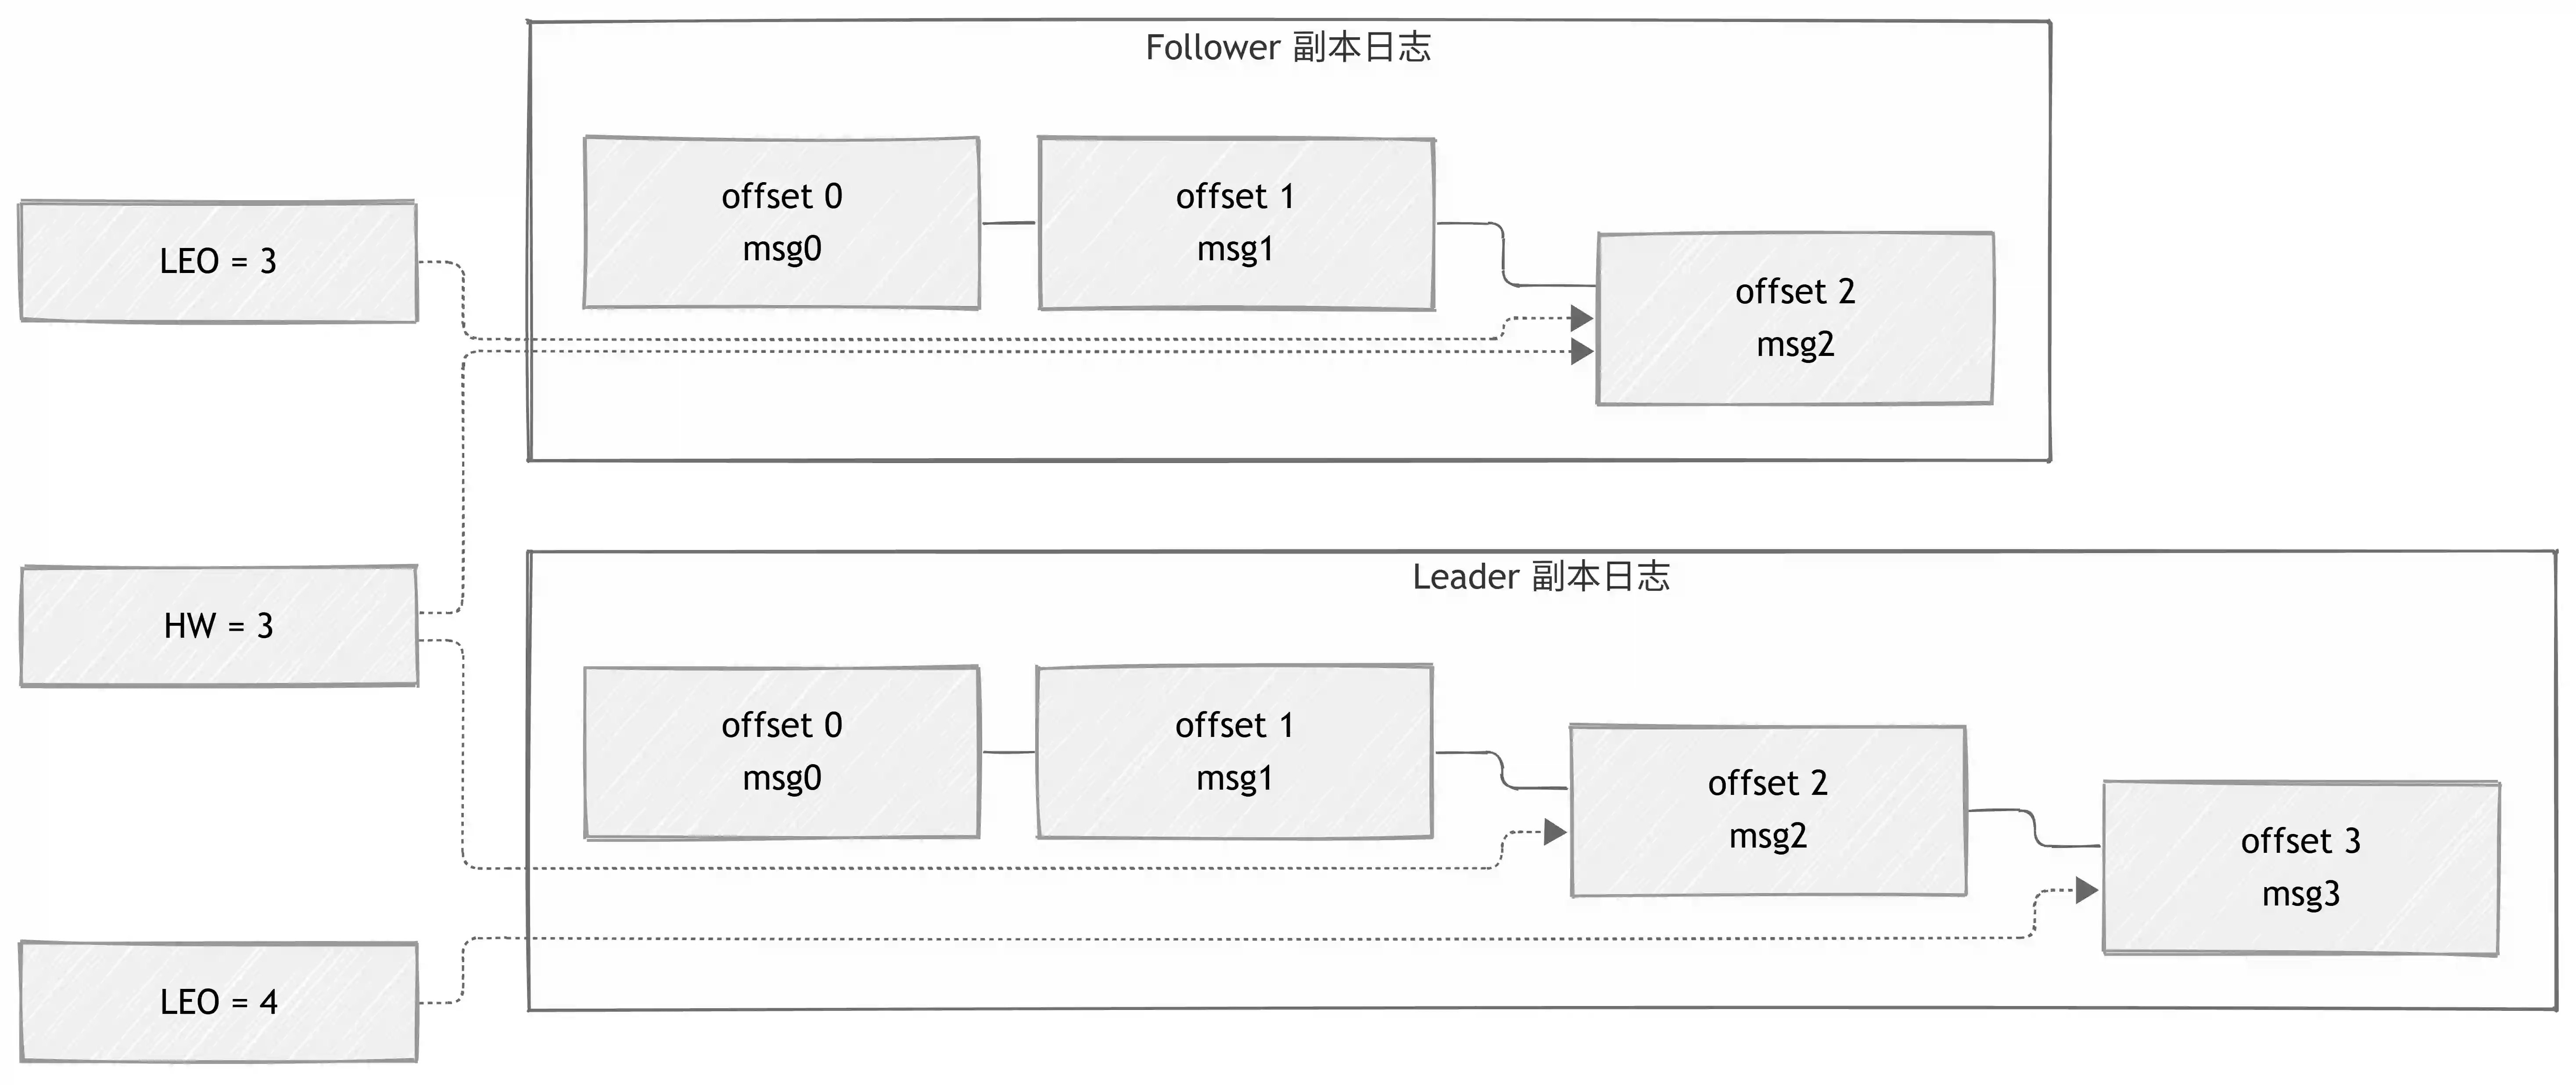
对照上图,几个关键点:
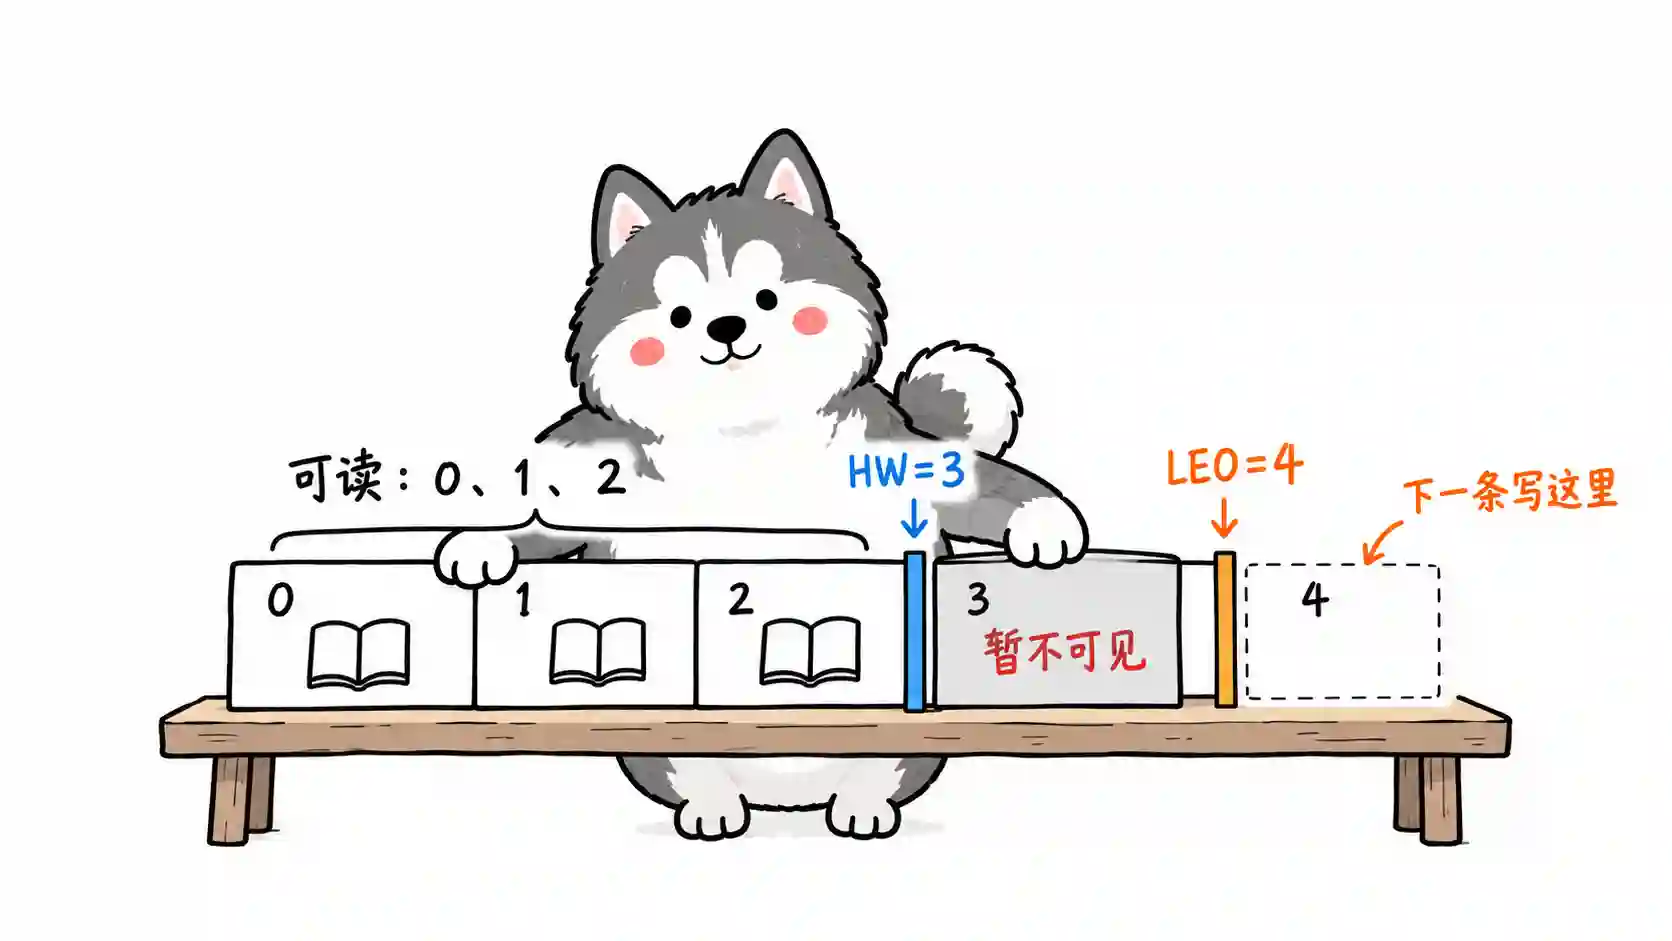
- LEO:日志末端位移。Leader 的 LEO 是 4,表示下一条消息会写到 offset 3 之后(即 offset 4 的位置上);Follower 的 LEO 是 3,说明它还落后一条消息。
- HW:高水位。消费者最多只能消费到 HW 之前,也就是 offset 0、1、2 这三条。offset 3 那条虽然已经在 Leader 日志里了,但 Follower 还没同步到,属于“未提交”状态,消费者看不见。
- HW 怎么算:Leader 会跟踪所有 ISR 副本的 LEO,取最小值。Follower 的 LEO 是 3,所以 HW 就是 3。这就是“一条消息要被 ISR 里所有副本都收到,消费者才能看到”的由来,也是
acks=all语义的底层支撑。
这里有个容易被追问的细节:Follower 怎么更新自己的 HW?答案是取“自己的 LEO”和“Leader 在 Fetch 响应里返回的 HW”两者的较小值。记住这个,后面推演事故场景会用到。
二、HW 更新天生慢半拍
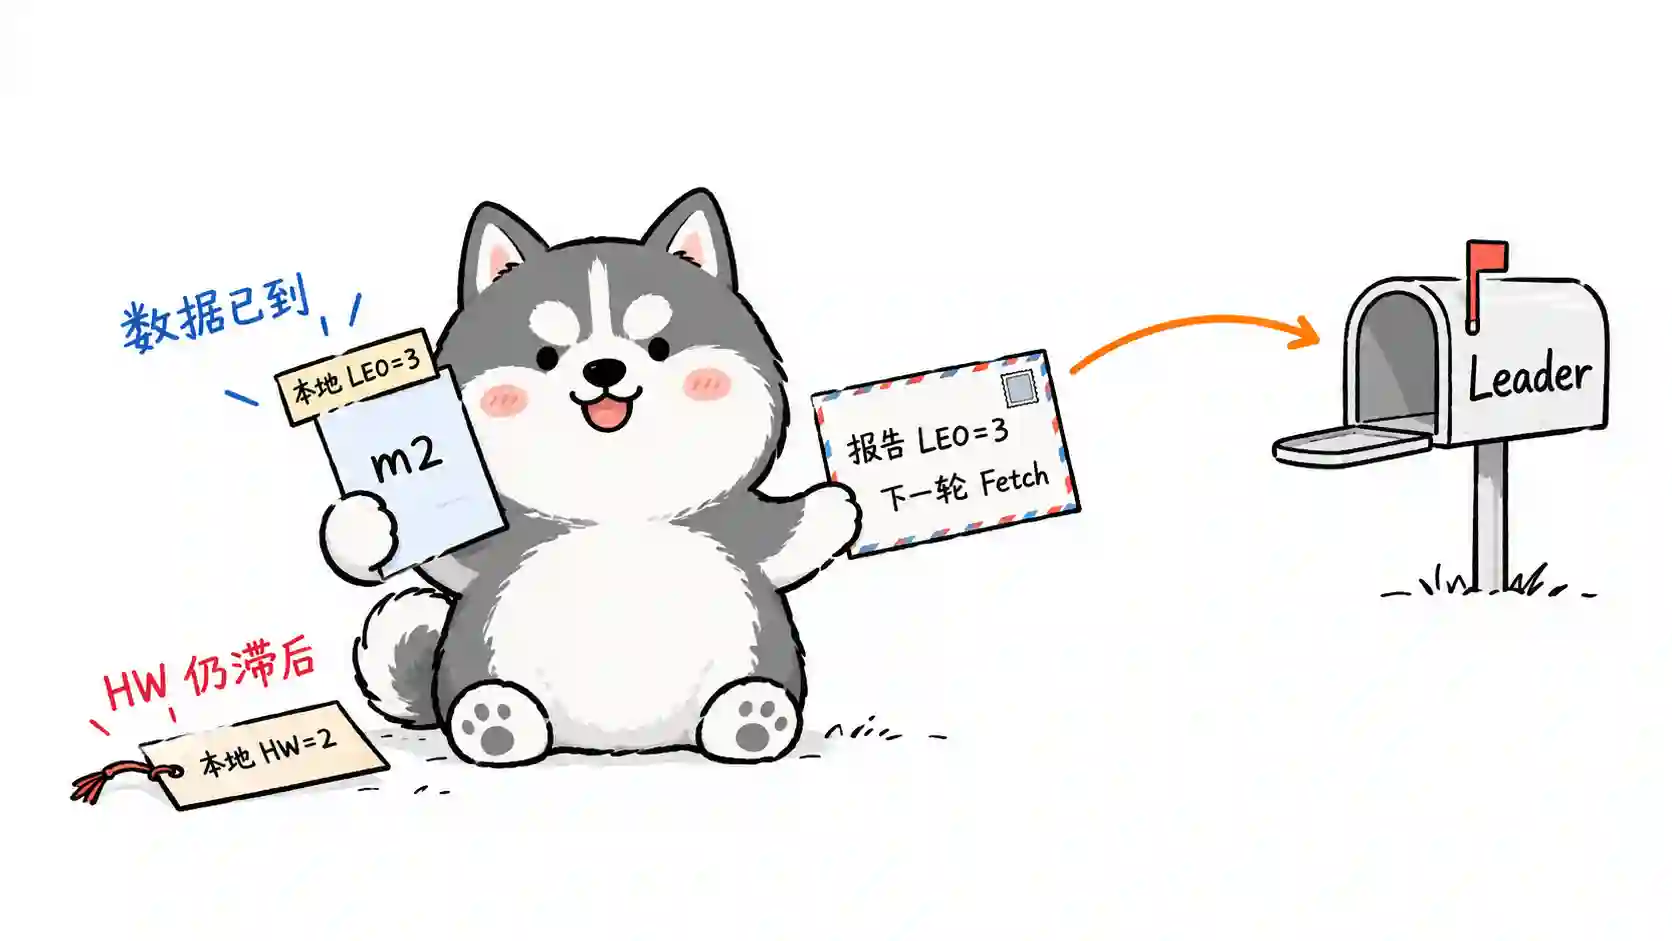
旧版本(0.11 之前)的 HW 更新机制有个要命的特点:它依赖 Follower 下一轮 Fetch 才能反映上一轮的进度。
流程大概是这样:
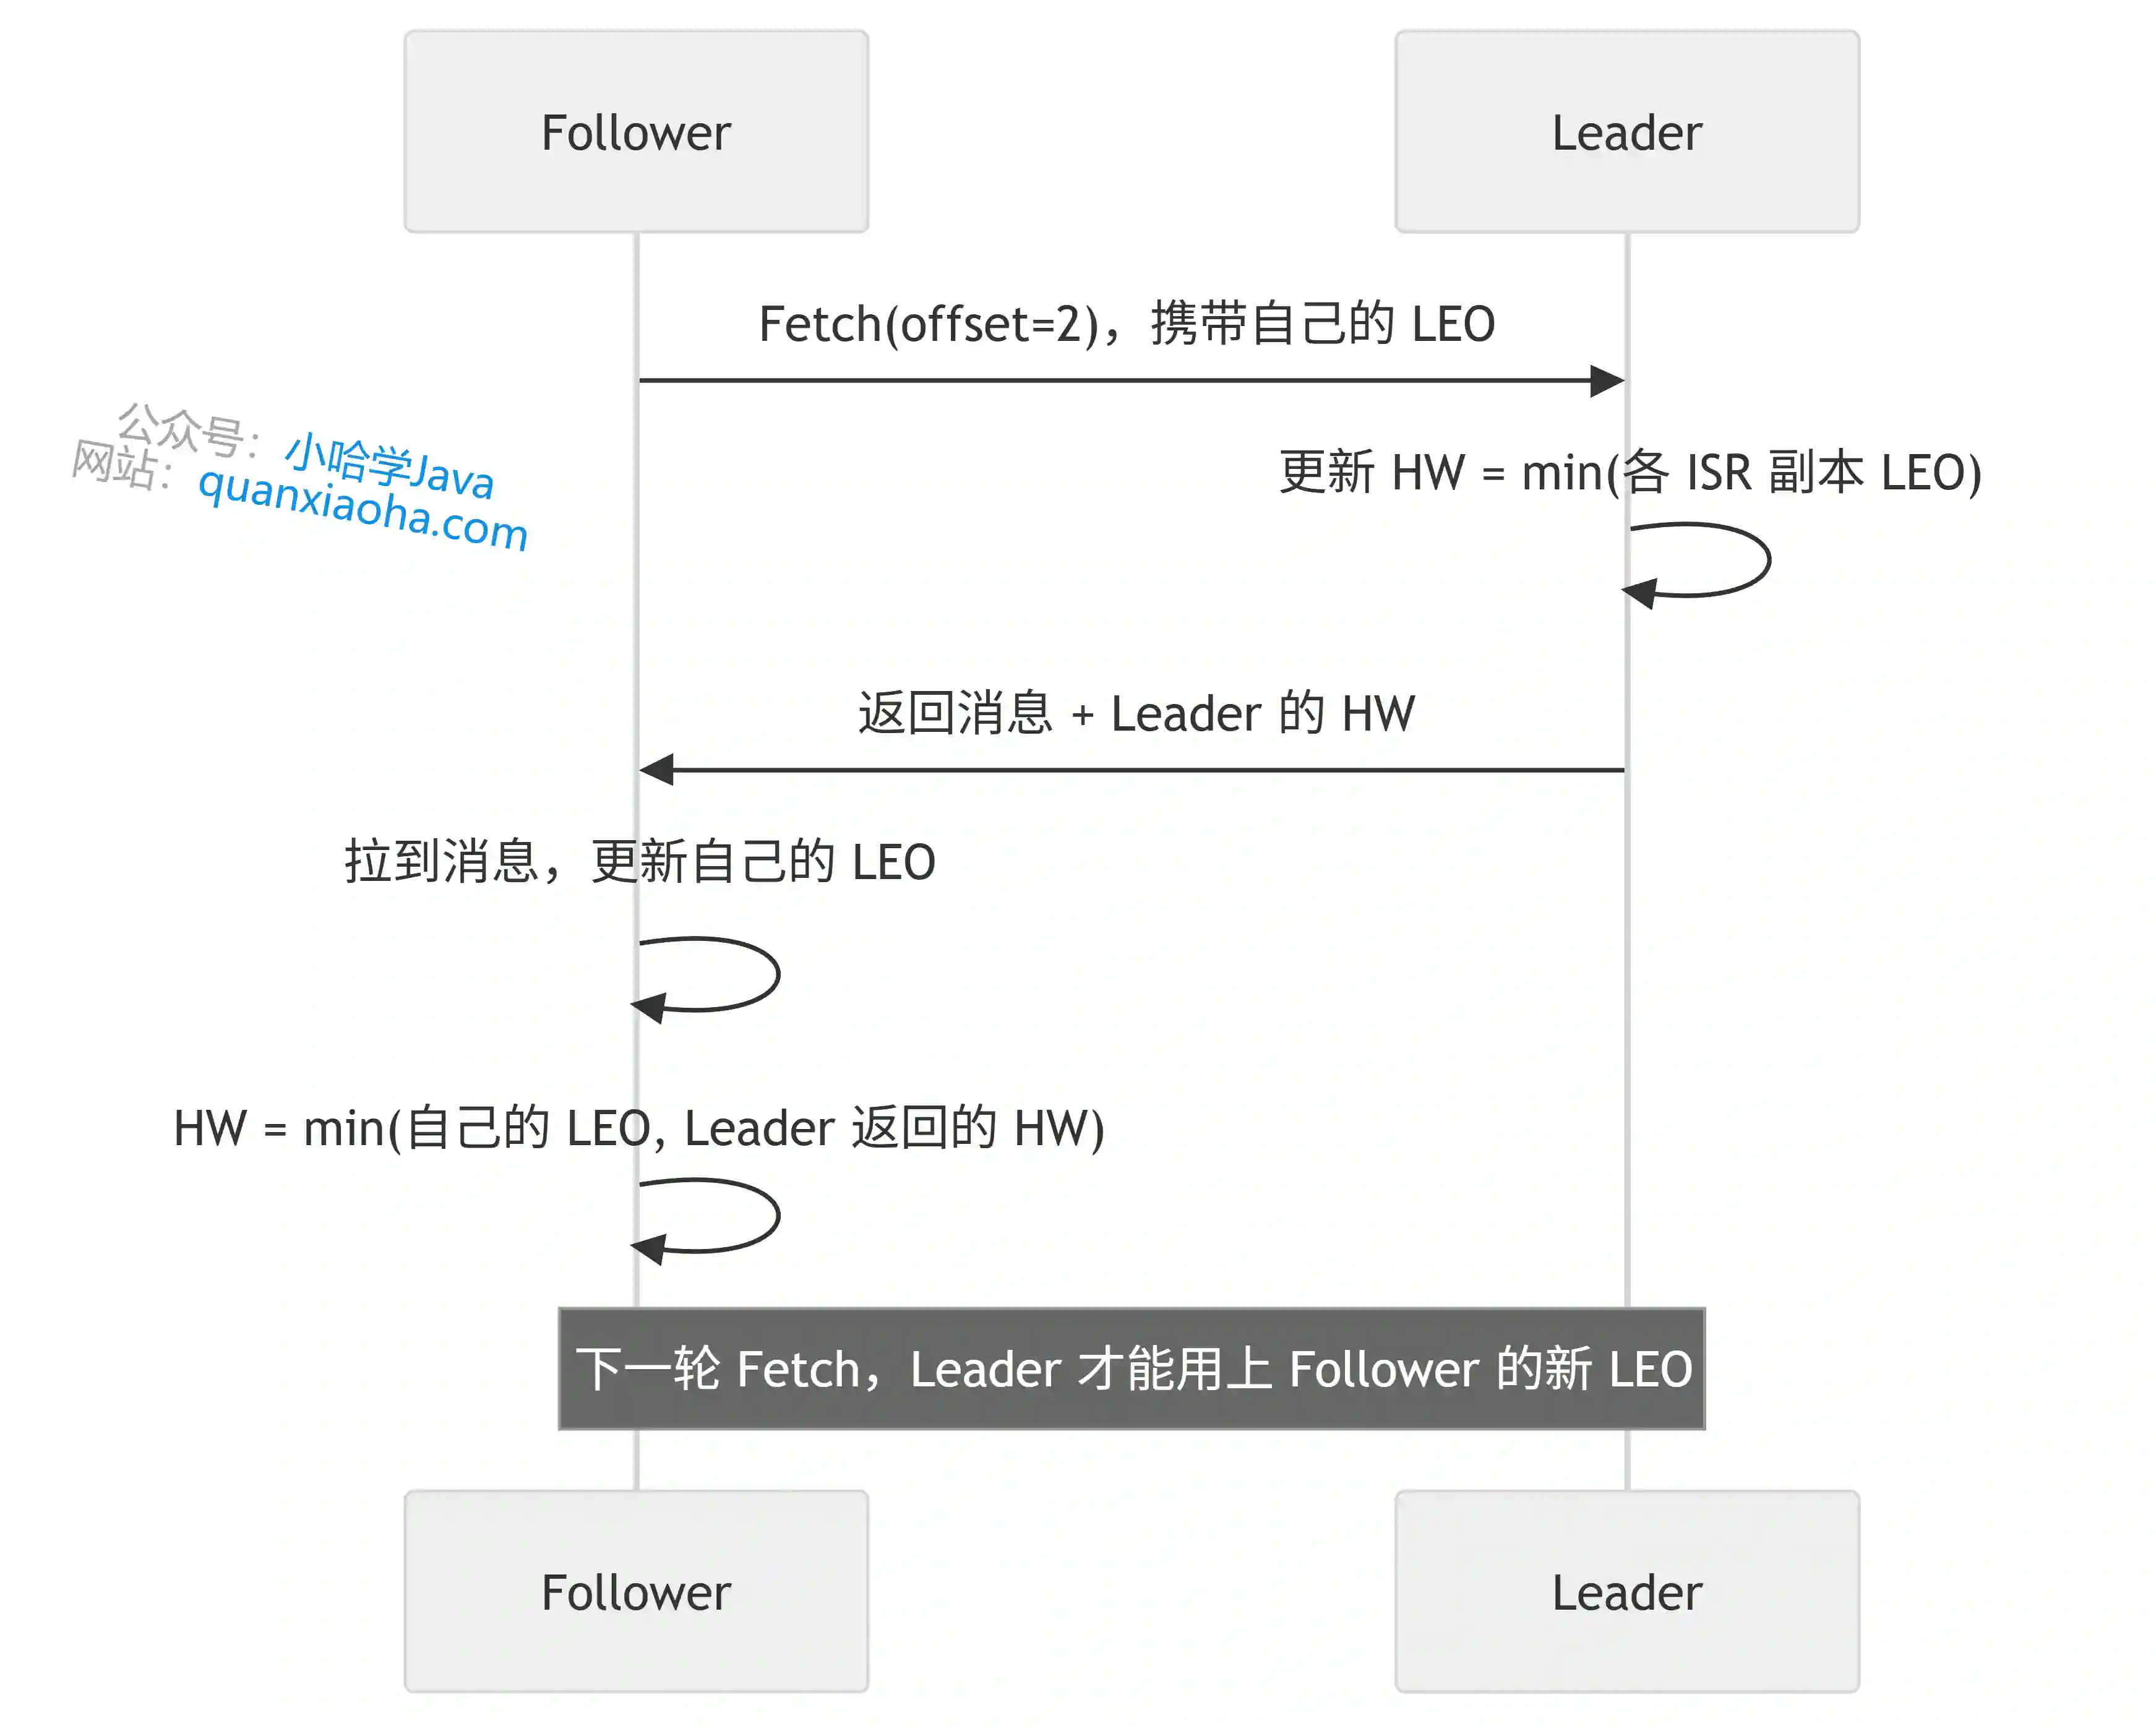
看最后那句注释:Follower 这一轮拉到了消息、LEO 前进了,但 Leader 的 HW 要等到下一轮 Fetch 请求进来才能更新。中间有个时间差。平时这个时间差无所谓,一轮 Fetch 就是几十毫秒的事。可一旦赶上宕机和重启,事故就来了。
三、两个经典事故场景
这两个场景是这道题的重头戏,面试官就等着你把它们推演出来。两副本场景,acks=1、min.insync.replicas=1,慢慢看。
场景一:数据丢失
初始状态:Leader A 的 LEO=2、HW=2,Follower B 的 LEO=2、HW=2,消息 m0、m1 已同步。
- 生产者写入 m2(写到 offset 2),A 的 LEO 变成 3。因为
acks=1,A 立刻返回成功,生产者认为这条消息稳了。 - B 还没来得及拉取 m2,此刻 B 的 LEO 还是 2。
- A 宕机,B 被选为新 Leader,B 的 HW=2。
- A 恢复,变回 Follower。它一对照:我的 LEO=3,比 HW=2 大,offset 2 那条是“未提交”的,按规则截断,m2 被删掉。
结果:生产者明明收到了 ack,m2 却永远消失了。丢数据,就是这么丢的。
场景二:日志分叉(数据不一致)
初始状态:A 是 Leader,LEO=3、HW=2;B 是 Follower,LEO=2、HW=2。
- A、B 同时宕机。注意 A 的日志里有 offset=2 的 m2,B 没有,但俩人的 HW 都是 2。
- B 先恢复,当选新 Leader(epoch 前进),接受生产者写入,在 offset=2 写入了新消息 m3,B 的 LEO=3。
- A 恢复,变回 Follower,发现 LEO=3 > HW=2,照旧截断,把自己原来的 m2 删了,然后从 offset=2 开始同步 B 的 m3。到目前为止还算“correct”。
- 但如果第 3 步 A 还没来得及同步,B 又宕机了,A 重新当选 Leader,接受写入,在 offset=2 写入 m4。
最终结局:B 的日志里 offset=2 是 m3,A 的日志里是 m4,两条不同的消息占着同一个 offset,HW 还都一样,谁也发现不了这个分叉。这就是日志离散(divergence),后面消费者可能从不同副本读到不同的数据,排查起来想撞墙。
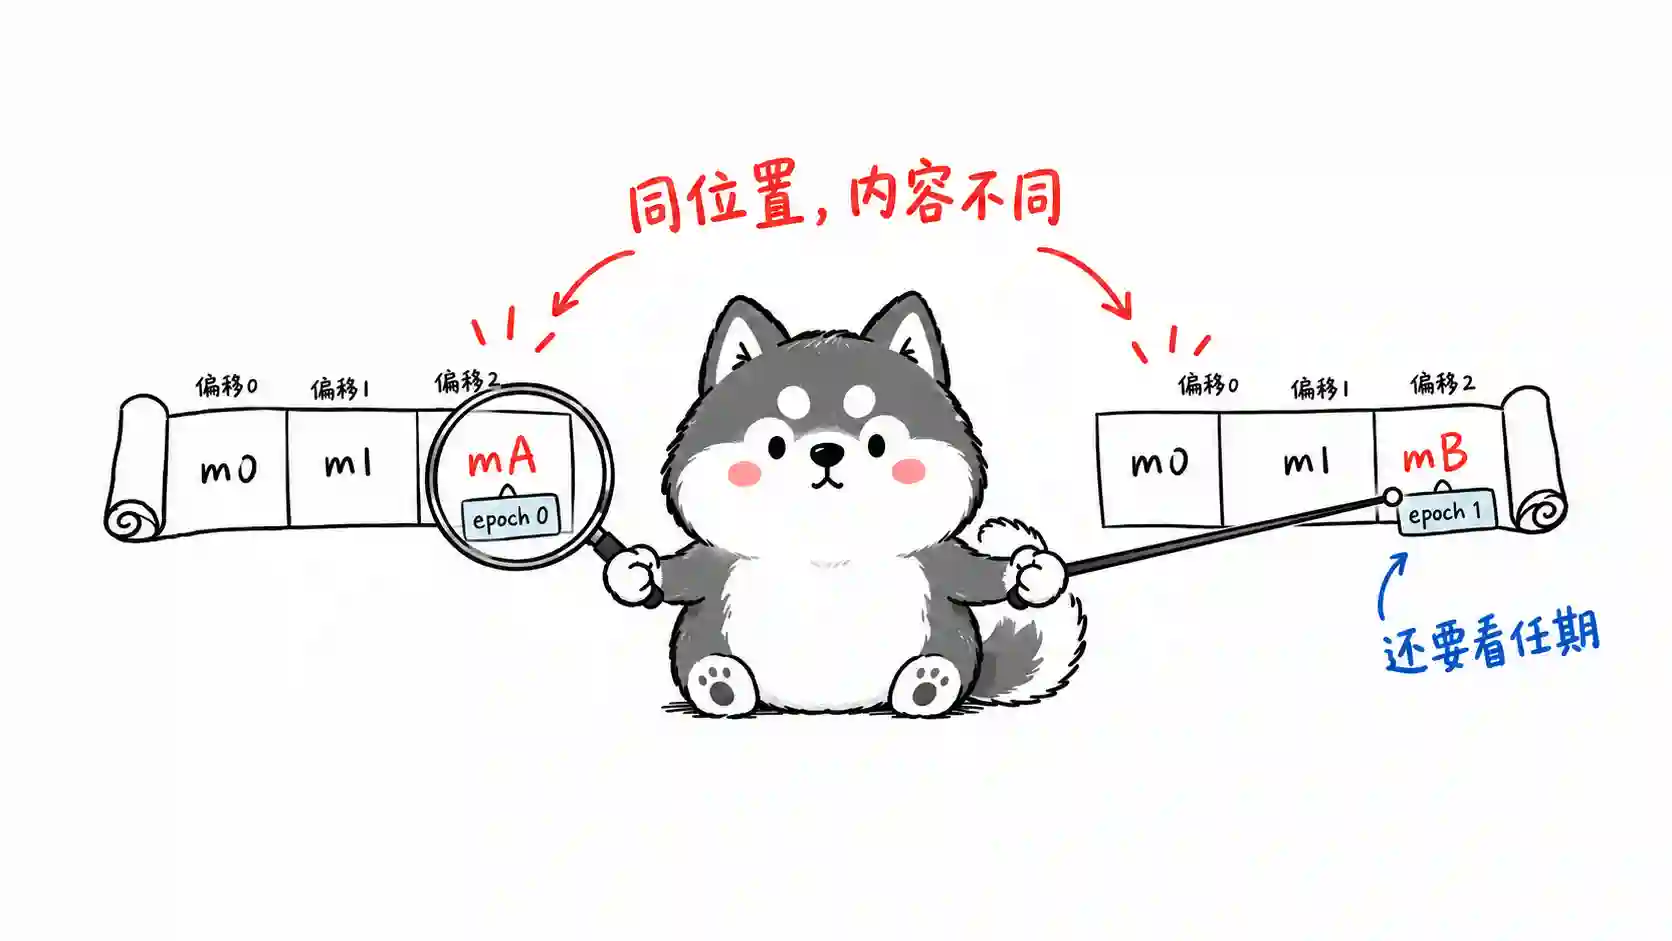
两个场景的病根是同一个:HW 是个带延迟的“滞后值”,拿它当截断依据,恢复时就可能删掉实际已经提交的消息,或者保留不该保留的位置。
四、LeaderEpoch 怎么救场
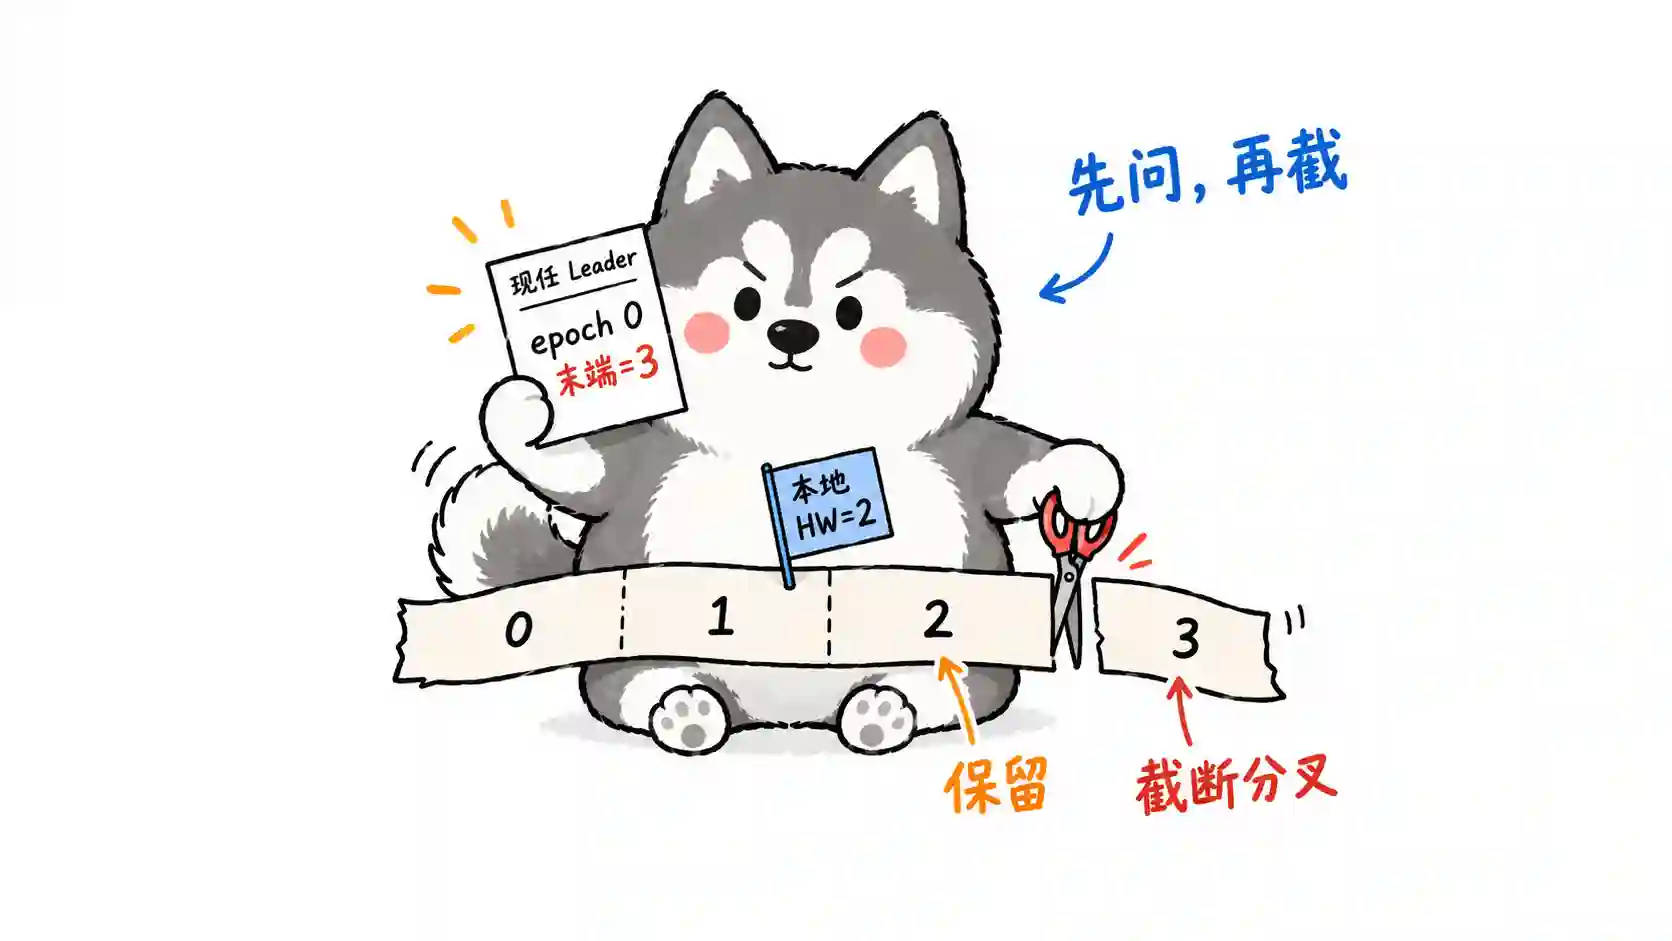
Kafka 0.11 的 KIP-101 引入 LeaderEpoch,思路一句话:截断前别自己瞎猜,先去问现任 Leader。
LeaderEpoch 的定义很简单:一个 (epoch, startOffset) 二元组。epoch 单调递增,每次 Leader 换届就 +1;startOffset 记录这个 epoch 的 Leader 开始写入的位置。每个 Broker 会在日志目录下为每个 Partition 维护这个映射关系(leader-epoch-checkpoint 文件),内存里也有一份。
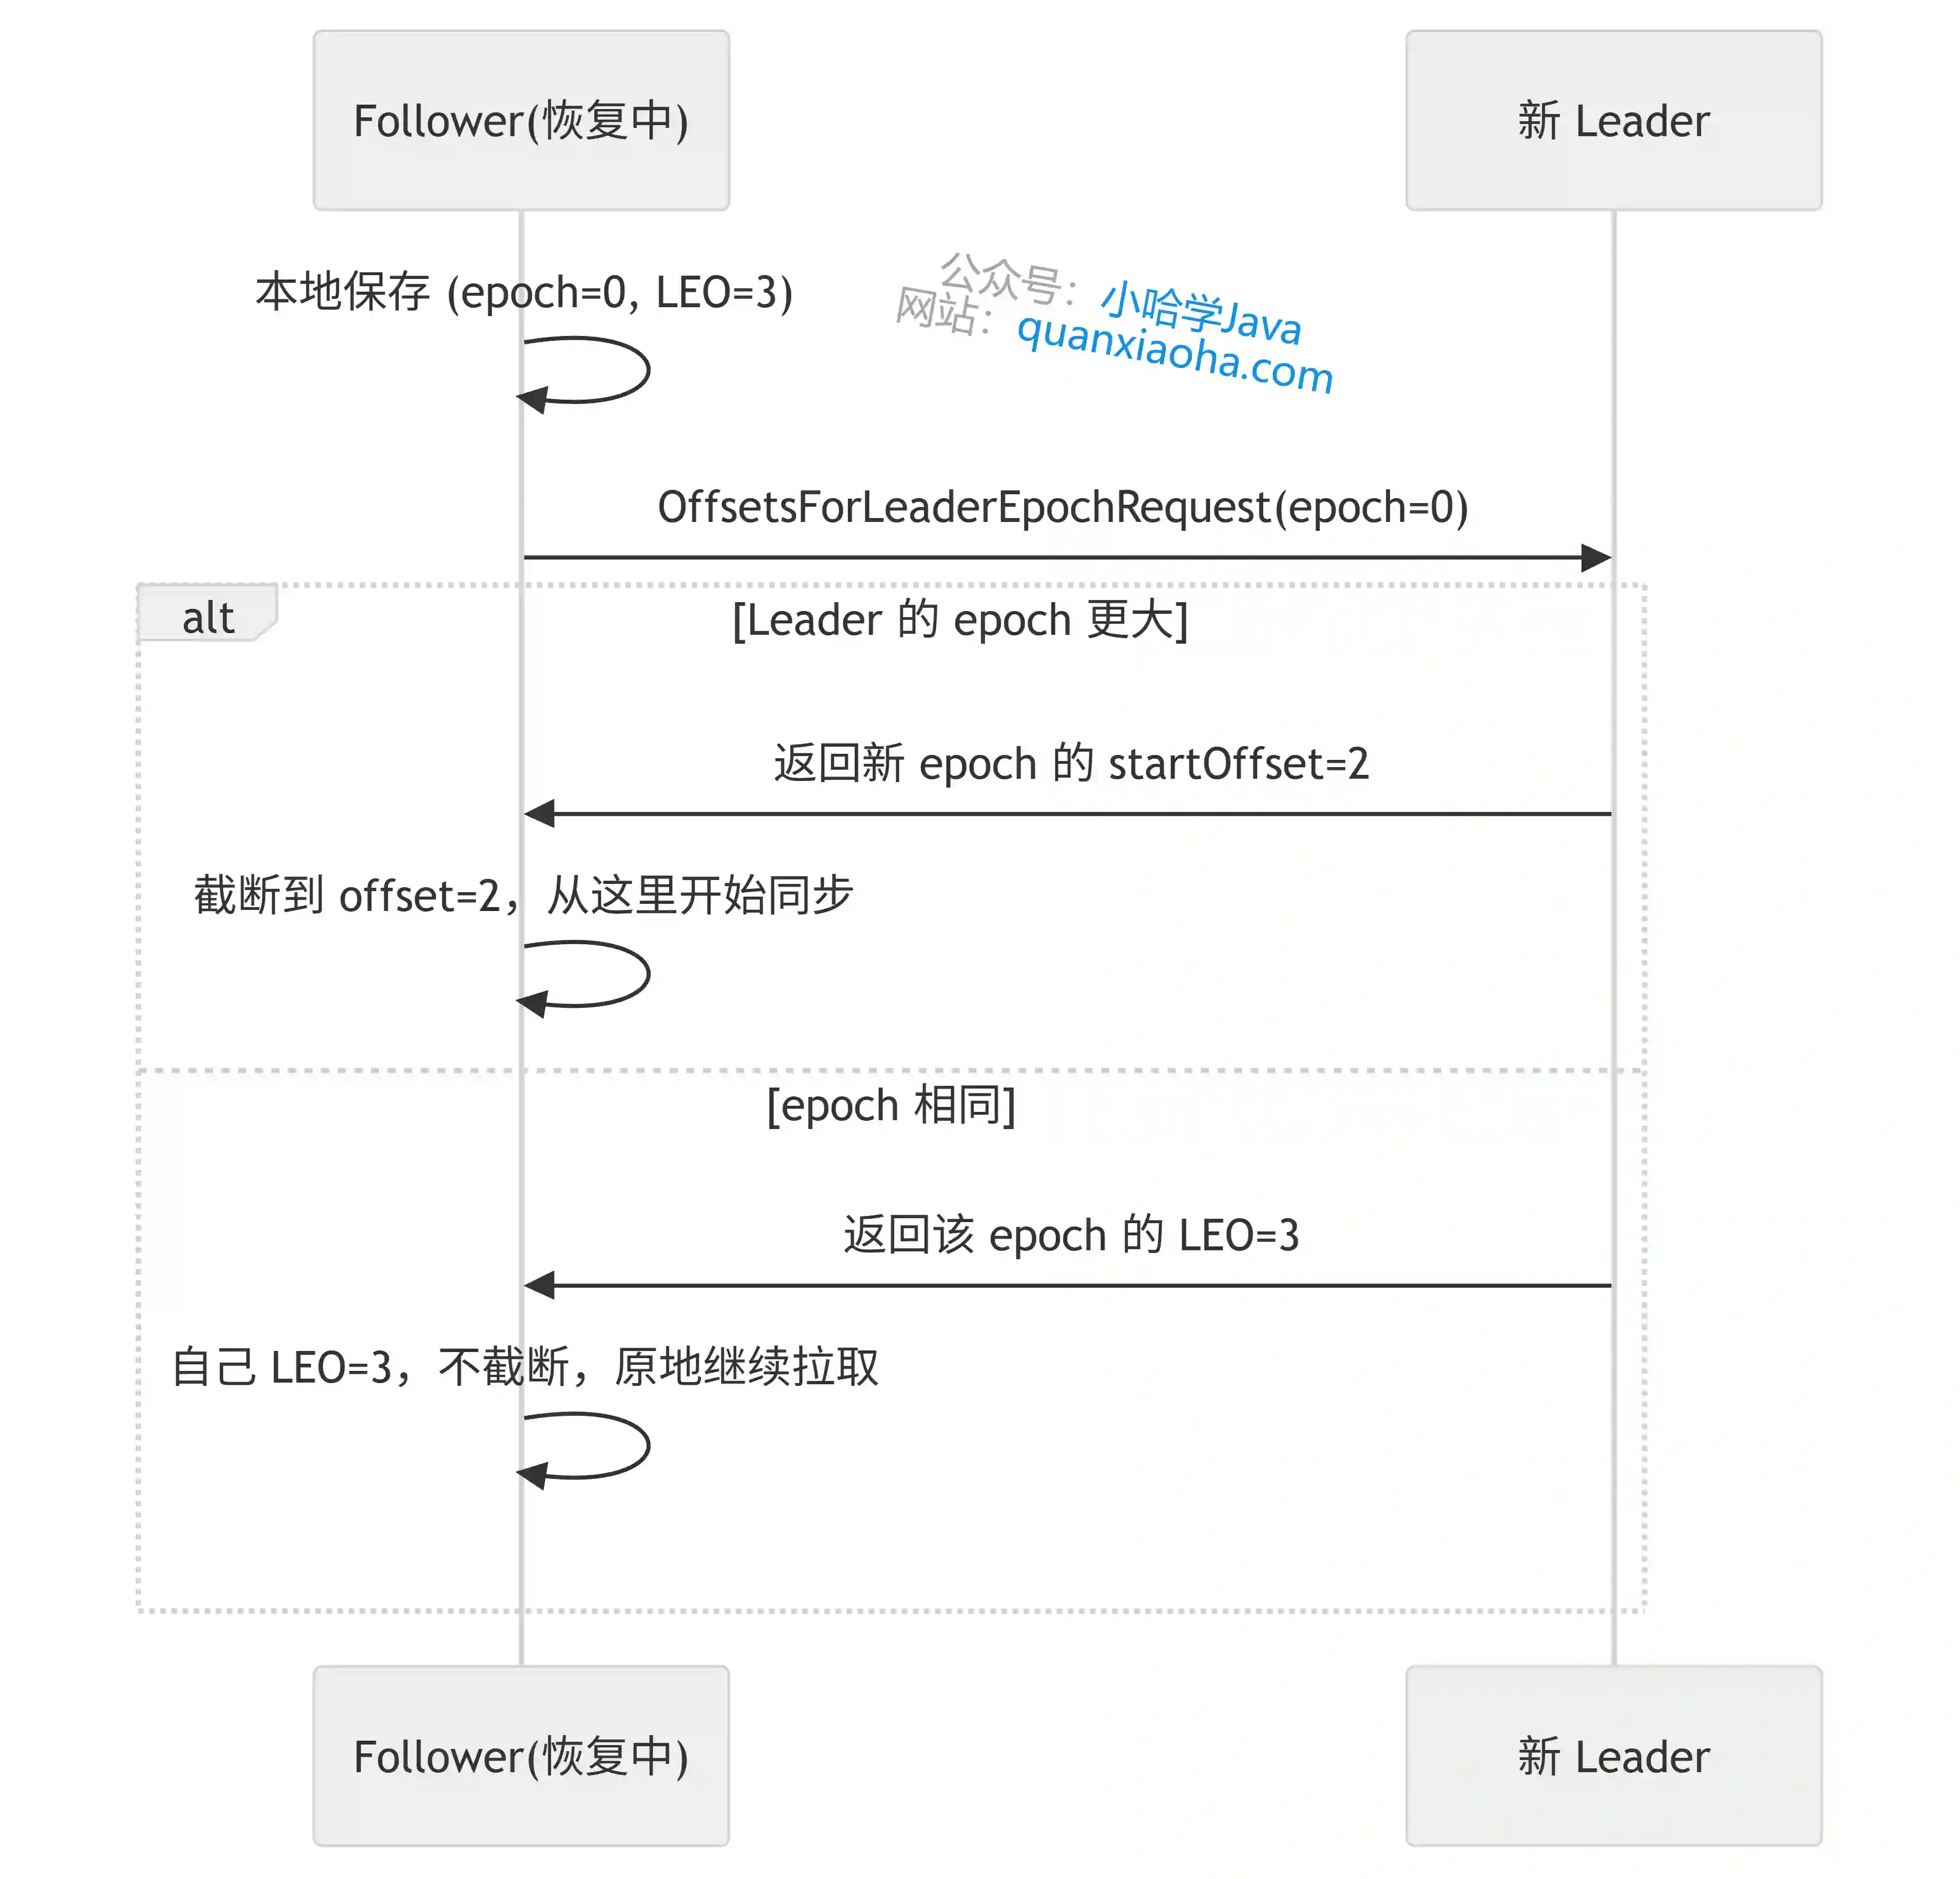
Follower 恢复后(或者收到 Fetch 响应发现 epoch 变了)的流程变成这样:
文字版拆解:
- Follower 带着自己记录的 epoch 去问 Leader:“我这个 epoch 对应的日志写到哪了?”
- 如果 Leader 手里是更大的 epoch:说明中间换过主,Leader 会返回新 epoch 的 startOffset(也就是上一个 epoch 的实际末端位置)。Follower 截断到这个位置再同步。这个位置是 Leader 亲口说的权威值,不是本地那个滞后的 HW。
- 如果 epoch 一致:Leader 返回当前 epoch 的 LEO。Follower 拿自己的 LEO 一比:比人家小就继续拉取,注意,这里哪怕自己的 LEO 超过了 HW 也不会被截断,只要没超过 Leader 的 LEO,这些消息都是安全的,留着接着用。
回头再看场景一:A 恢复后先去问 B(新 Leader),B 说“epoch 1 从 offset=2 开始”。A 一看自己 epoch 0 的消息只写到 offset=2,没有多余数据,m2 在 B 那根本没存在过,认了,不丢不补。等等,那 m2 不是还是丢了吗?对,这个场景里 m2 确实没救回来,但注意:LeaderEpoch 保证的是副本之间不丢不分叉。而“生产者收到 ack 但消息丢了”这件事,旧机制下是副本协议本身买单;新机制下,生产端的语义由 acks=all + min.insync.replicas>=2 来兜底,两者配合才叫完整。面试里能把这个层次说清,直接上一个档位。
再看场景二:A 恢复后发现 Leader 的 epoch 比自己大,直接按新 Leader 给的 startOffset 截断,从权威位置重新同步,B 后续再宕机也无所谓,大家的 epoch 链条把每一次换届都记得明明白白,分叉根本藏不住。
对比一下就更清楚了:
| 维度 | 基于 HW 截断(旧) | 基于 LeaderEpoch(新) |
|---|---|---|
| 截断依据 | 本地 HW(滞后值) | Leader 返回的权威日志位置 |
| 数据丢失 | 可能删掉已提交消息 | 不会,位置由 Leader 确认 |
| 日志分叉 | 可能发生 | epoch 链保证单调追溯,不会 |
| 换届感知 | 无感知,只认 offset | epoch+1,每次换届都有记录 |
五、顺着聊两句生产配置
这块面试官经常顺嘴一问:
unclean.leader.election.enable:是否允许非 ISR 副本当 Leader。0.11 起默认从true改成false(KIP-106),就是宁可牺牲可用性也不冒丢数据的风险。金融、计费这类场景务必保持false。acks=all+min.insync.replicas=2(三副本集群):消息至少被两个副本收到才算提交,配合 LeaderEpoch,丢数据的三道口子基本全堵上了。- 消费端位移提交别开自动提交,和 HW 可见性配合好了,重复消费才有解。
面试高频追问
-
追问一:消费者能消费到哪条消息,和 HW 什么关系? 消费者只能消费到 HW 之前(不含 HW)的消息。这就是为什么消息写到 Leader 后消费者不一定马上能看到,得等 ISR 全同步,HW 推过去才行。
-
追问二:LEO 什么时候推进? Leader 是写一条推一次;Follower 是从 Leader 拉到消息就推。HW 则由 Leader 在每轮 Fetch 时汇总最小 LEO 推进。
-
追问三:LeaderEpoch 文件存在哪,Follower 什么时候会发 OffsetsForLeaderEpoch 请求? 每个 Partition 的日志目录下有
leader-epoch-checkpoint文件持久化 epoch 条目;Follower 重启恢复后,以及 Fetch 响应中发现 Leader 的 epoch 变大了,都会触发这个请求。 -
追问四:有了 LeaderEpoch,为什么还需要 HW? 两码事。HW 管的是消费者可见性和“已提交”语义;LeaderEpoch 管的是副本截断的正确性。是替换了 HW 的“截断职责”,不是替换 HW 本身。
常见面试变体
- 变体一:“Kafka 什么情况下会丢消息?”——把场景一和
unclean.leader.election.enable串起来答,HW 截断丢数据是必提的点。 - 变体二:“Kafka 的 ISR、HW、LEO 分别是什么关系?”
- 变体三:“Kafka 怎么保证副本一致性?”——ISR 同步 + LeaderEpoch 截断 + epoch 单调这条链。
记忆口诀
HW 管可见,LEO 管写入;截断问 Leader,epoch 说了算。 旧机制“恢复看 HW,慢半拍丢数据”;新机制“先问再截,不丢不分叉”。
总结
HW 定义消费者可见边界,取 ISR 最小 LEO;但它更新有延迟,旧版拿它做截断依据会丢数据、会日志分叉。Kafka 0.11 用 LeaderEpoch 把“截断”这个动作改成先问 Leader 拿权威位置,副本一致性的问题才算真正解决。答题时把两个事故场景推演清楚,再点出 LeaderEpoch 的询问机制,这道题就稳稳拿下了。