什么是 Kafka 的重平衡机制?
一则或许对你有用的小广告
欢迎加入小哈的星球,你将获得:专属的实战项目(4个项目都能学) / 1v1 提问 / 简历修改 / Java 学习路线 / 社群讨论 / 学习打卡 / 每月赠书
《Spring AI 项目实战(问答机器人、RAG 智能客服、联网搜索)》已完结,基于
Spring AI + Spring Boot 3.x + JDK 21...,查看介绍《从零手撸:仿小红书(微服务架构)》 已完结,基于
Spring Cloud Alibaba + Spring Boot 3.x + JDK 17...,查看介绍;演示链接:http://116.62.199.48:7070/《从零手撸:前后端分离博客项目(全栈开发)》 2 期已完结,演示链接:http://116.62.199.48/
新开坑项目:《从零手撸:秒杀系统高并发优化实战》 正在更新中...,查看介绍
截止目前,星球内专栏累计输出 150w+ 字,讲解图 5110+ 张,还在持续爆肝中.. 后续还会上新更多项目,已有 4700+ 小伙伴加入学习,欢迎点击围观
面试考察点
-
基础掌握度:光知道重平衡这个词还不够,面试官更想看你能不能讲清楚它的触发条件、执行流程,还有它在消费者组模型里扮演的角色。
-
原理深度:重平衡背后有一套完整的协调机制:
Group Coordinator、JoinGroup、SyncGroup,还有 Leader 消费者制定分配方案的设计。能不能讲到这一层,是 “用过 Kafka” 和 “懂 Kafka” 的分水岭。 -
生产实践意识:重平衡是消费端最大的性能杀手之一。面试官很想知道:你有没有在实际项目里遇到过重平衡风暴?知不知道怎么通过参数调优、静态成员关系来减少重平衡?答得出这些,基本就是加分项。
核心答案
先说结论:重平衡(Rebalance)是指消费者组内的分区所有权重新分配的过程。当消费者成员发生变化、订阅的主题调整,或者主题分区数增减时,Kafka 会把分区重新分配给组内的消费者,保证每个分区始终只被组内的一个消费者消费。
整个重平衡由两方协作完成:
| 角色 | 所在位置 | 职责 |
|---|---|---|
Group Coordinator |
Broker 端 | 感知成员变化,发起重平衡,下发分配方案 |
| 消费者(含 Leader 消费者) | 客户端 | 普通成员参与投票;Leader 成员制定分区分配方案 |
重平衡最大的问题是:执行期间整个消费者组停止消费,也就是所谓的 STW。所以生产环境优化的核心思路就一句话——能不重平衡,就别重平衡。
深度解析
一、先搞清楚背景:分区独占消费模型
消费者组有一套铁律:一个分区在同一时刻,只能被组内的一个消费者消费;反过来,一个消费者可以消费多个分区。重平衡维护的正是这条 “分区 → 消费者” 的映射关系。
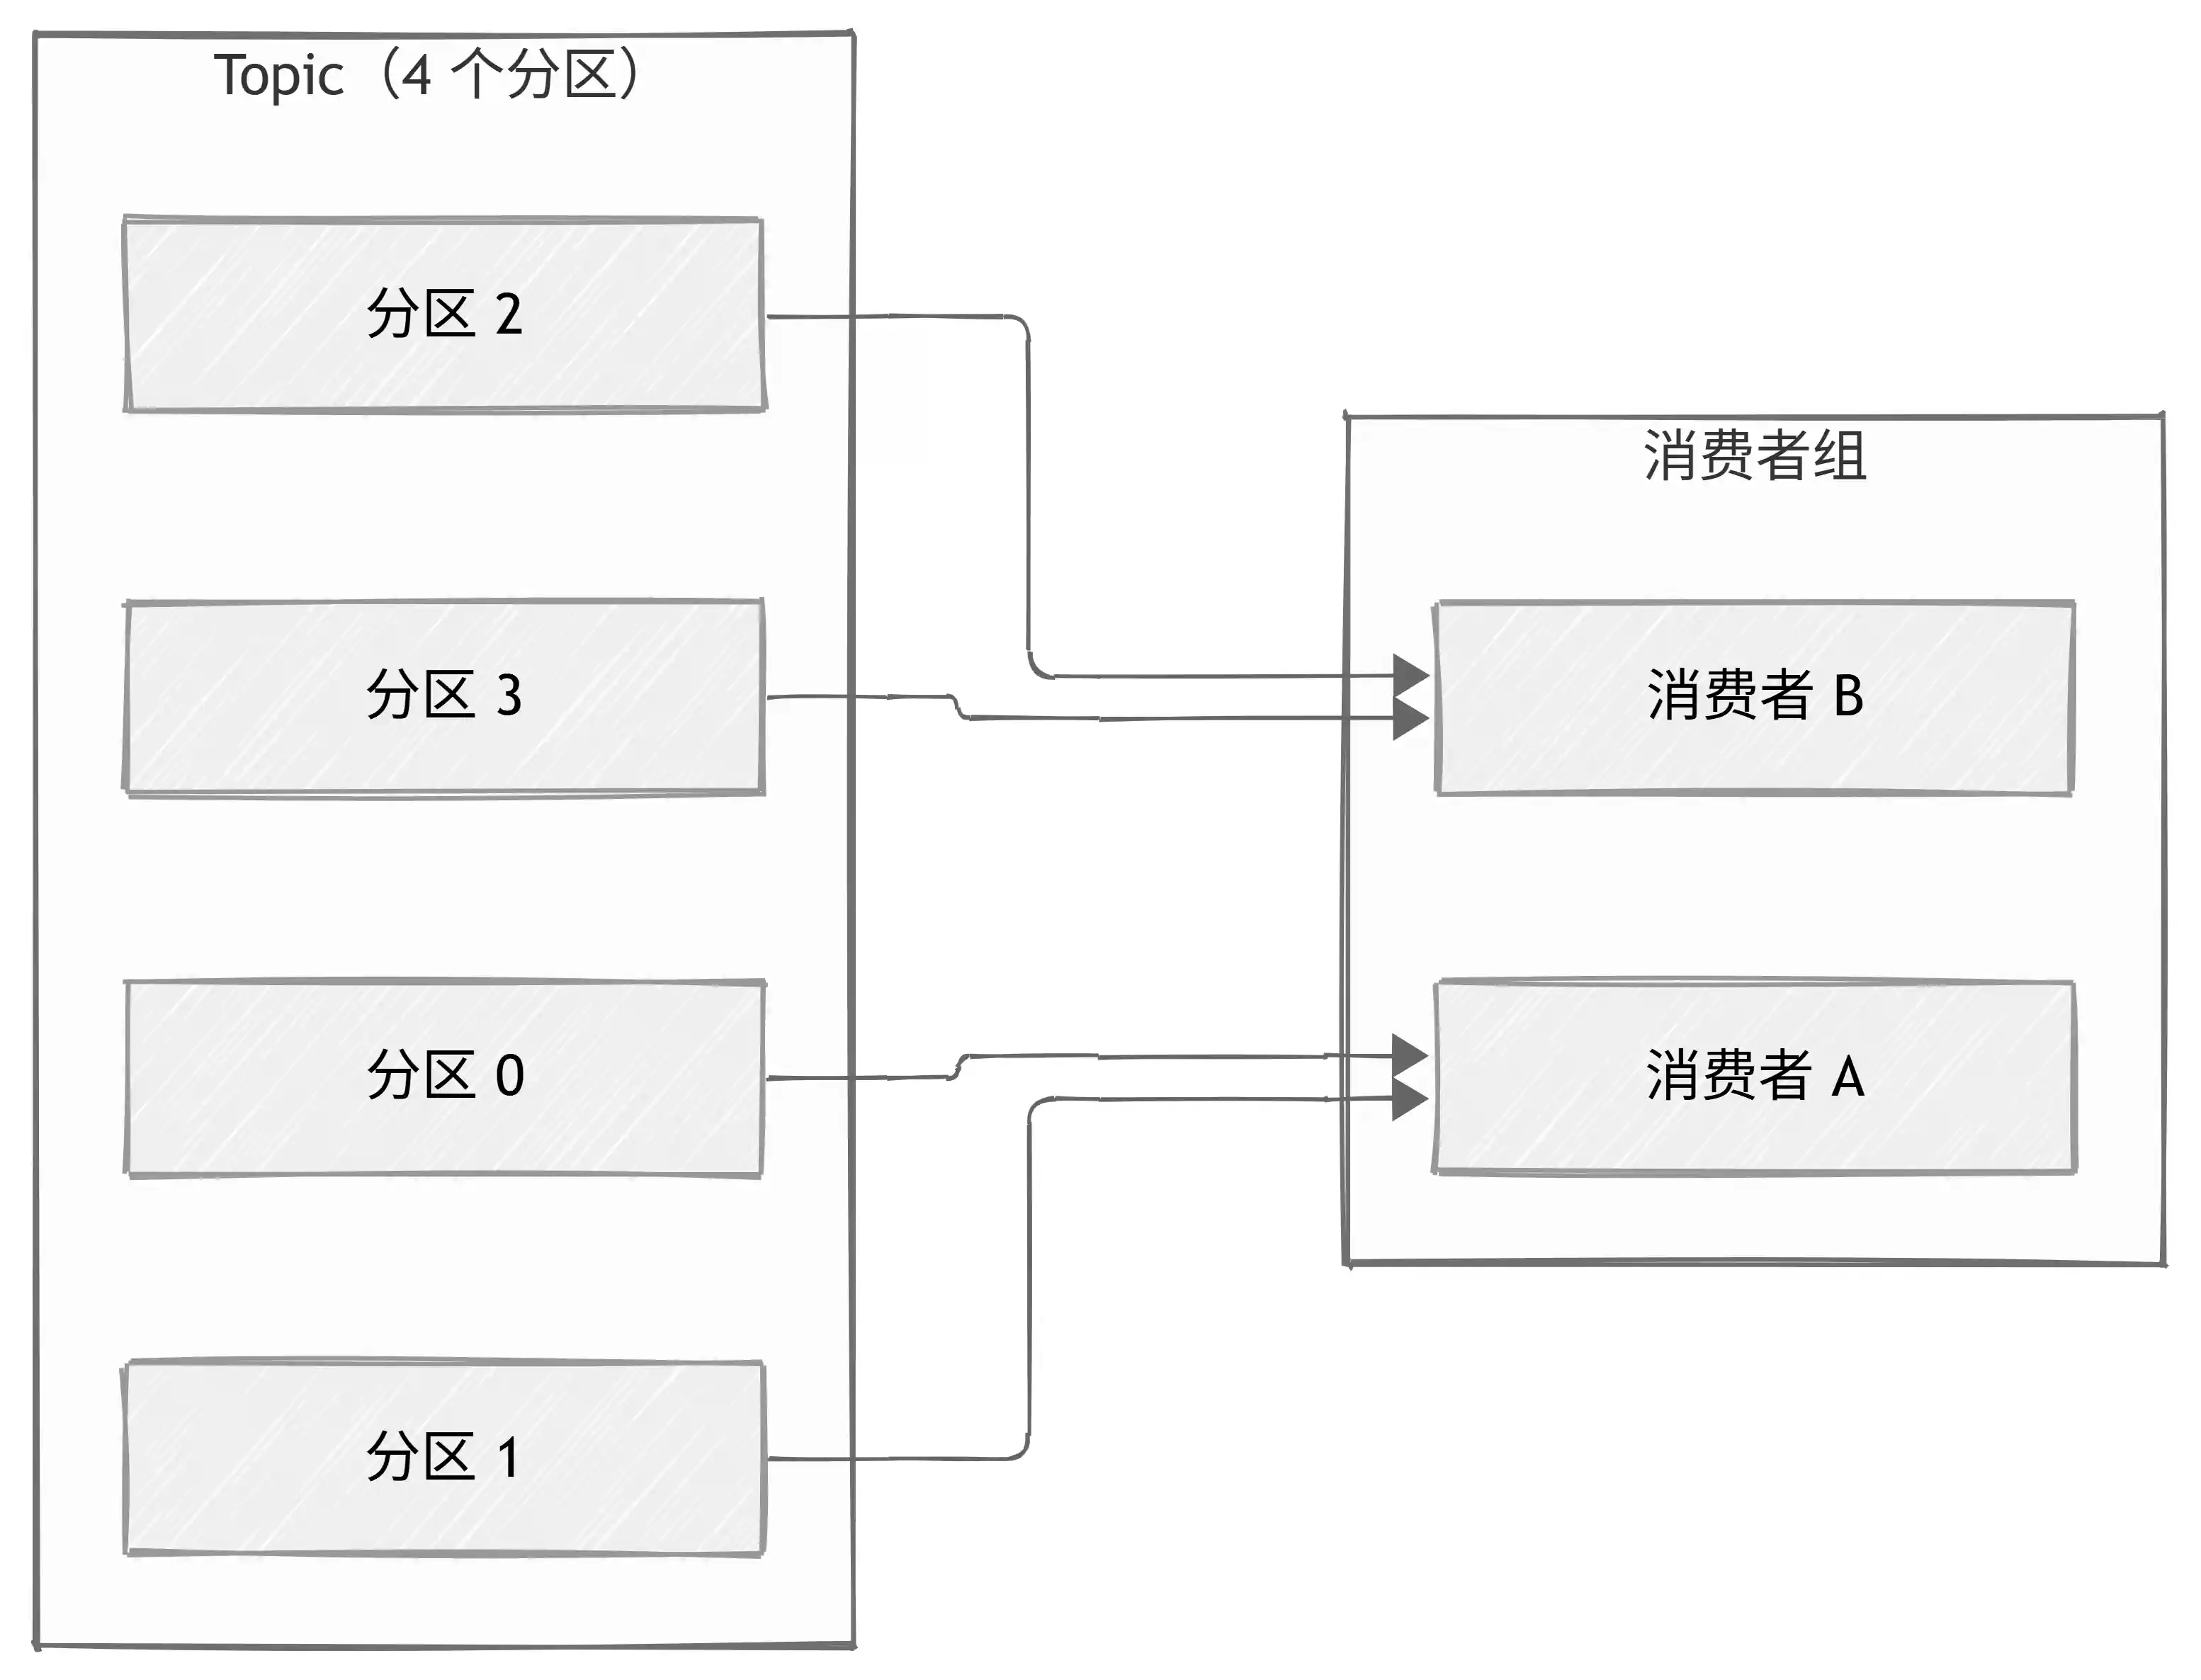
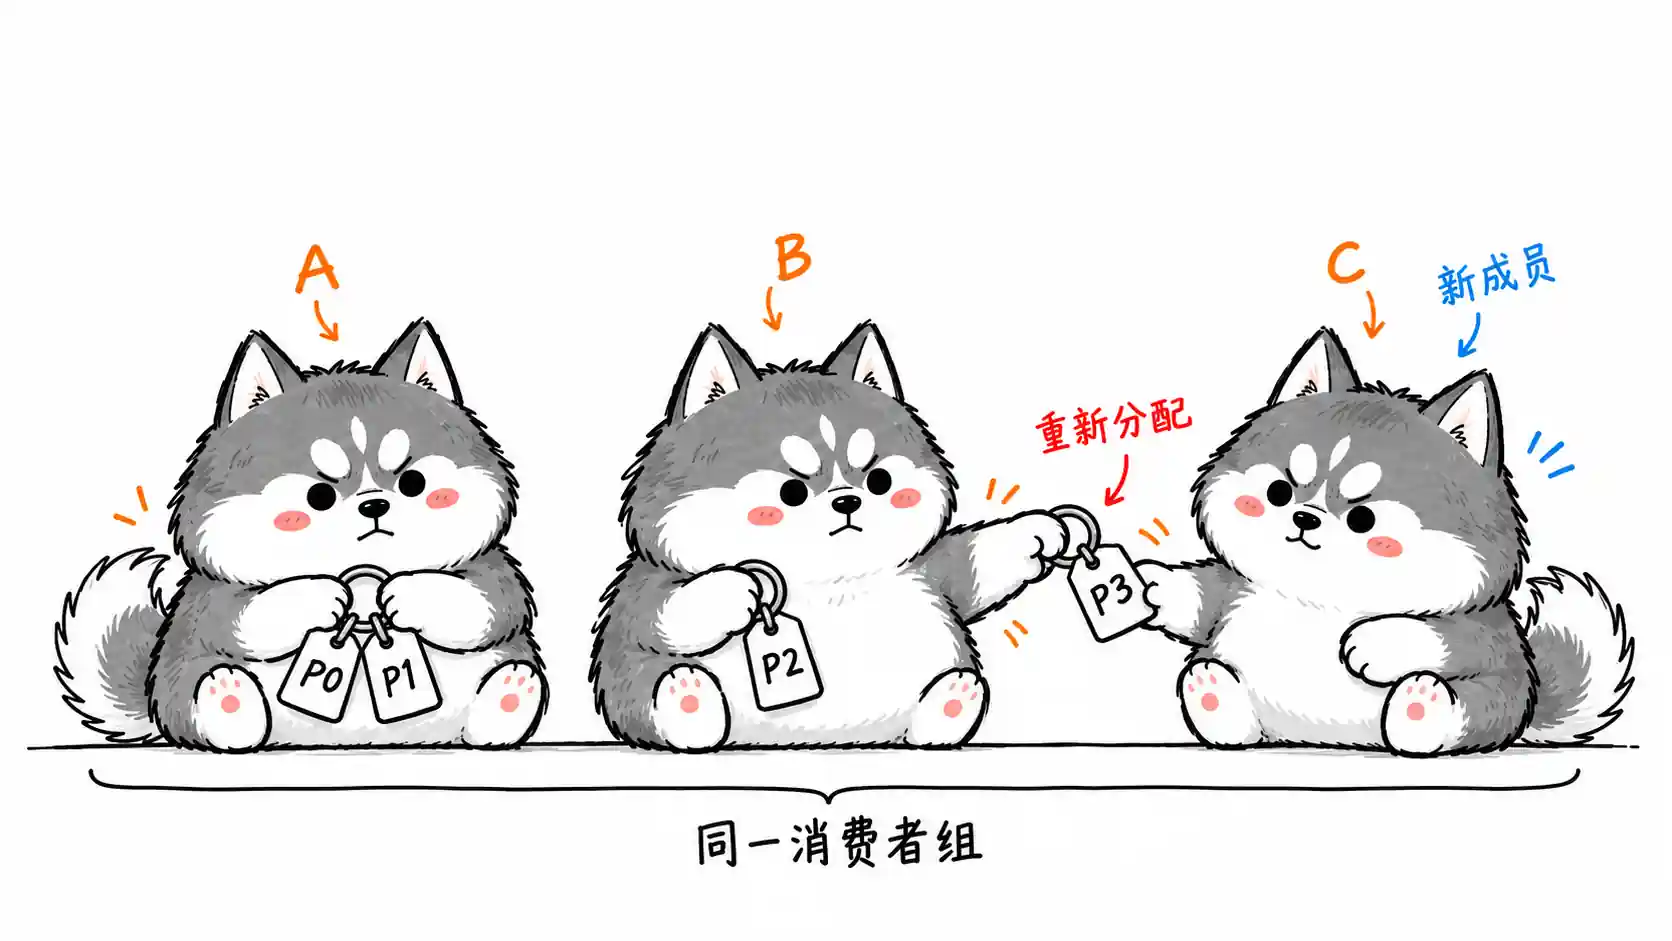
上图就是一个典型的消费模型:4 个分区被 2 个消费者瓜分,每人两个。一旦这个映射关系需要打破重来——比如消费者 B 挂了,或者组里新进来一个消费者 C——重平衡就该登场了。
二、重平衡的触发条件
能触发重平衡的事件只有三类:
- 消费者组成员变化:最常见的来源。新消费者加入、旧消费者主动退出、消费者被
Group Coordinator判定 “已死” 踢出组,都会触发。线上大多数重平衡事故都出在这一类。 - 订阅主题数变化:用正则表达式订阅主题时(比如
subscribe(Pattern.compile("order-.*"))),新匹配到的主题的分区会触发重平衡。固定主题名订阅一般不会。 - 主题分区数变化:给已有主题增加分区,新分区没有归属,必须重平衡。
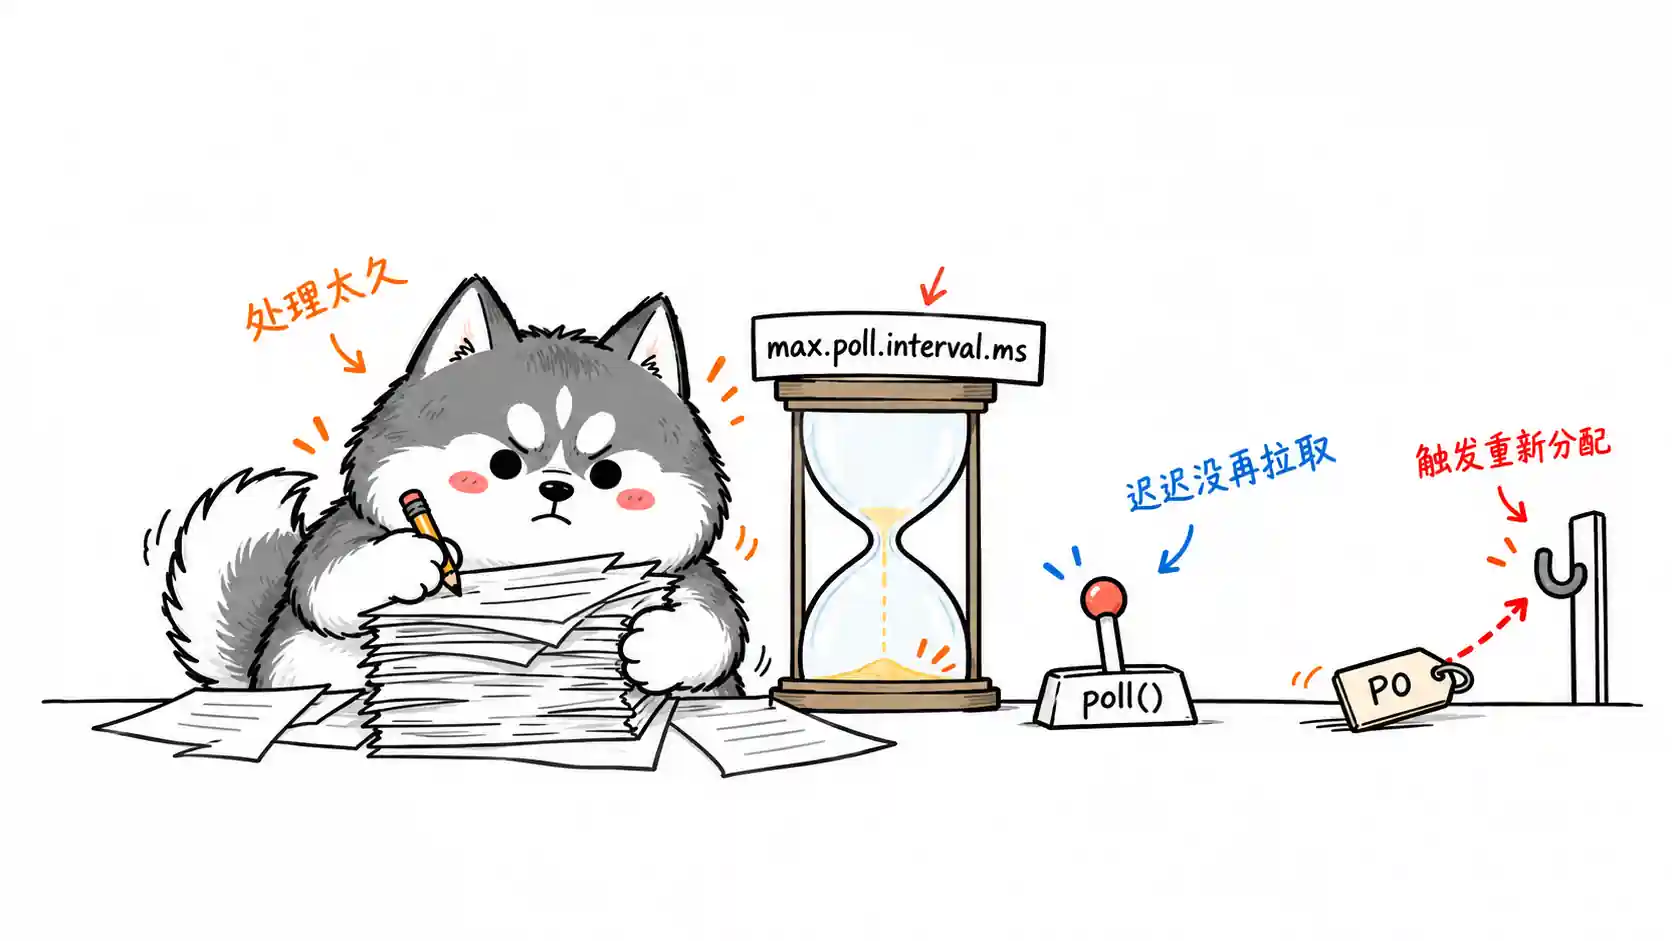
这里有个很容易踩的坑:消费者 “卡死” 也会被当成成员变化。业务处理逻辑太重、一次 poll() 拉回来的消息处理太久,超过 max.poll.interval.ms,协调者就认为这个消费者挂了,把它踢出组,触发一轮重平衡。很多人线上反复重平衡查不出原因,最后发现是消费逻辑太慢。
三、重平衡的完整流程(面试核心)
经典协议(也就是现在大多数 Kafka 版本在用的协议)的重平衡分两大步:JoinGroup 阶段 和 SyncGroup 阶段,外加前置的一步 FindCoordinator。
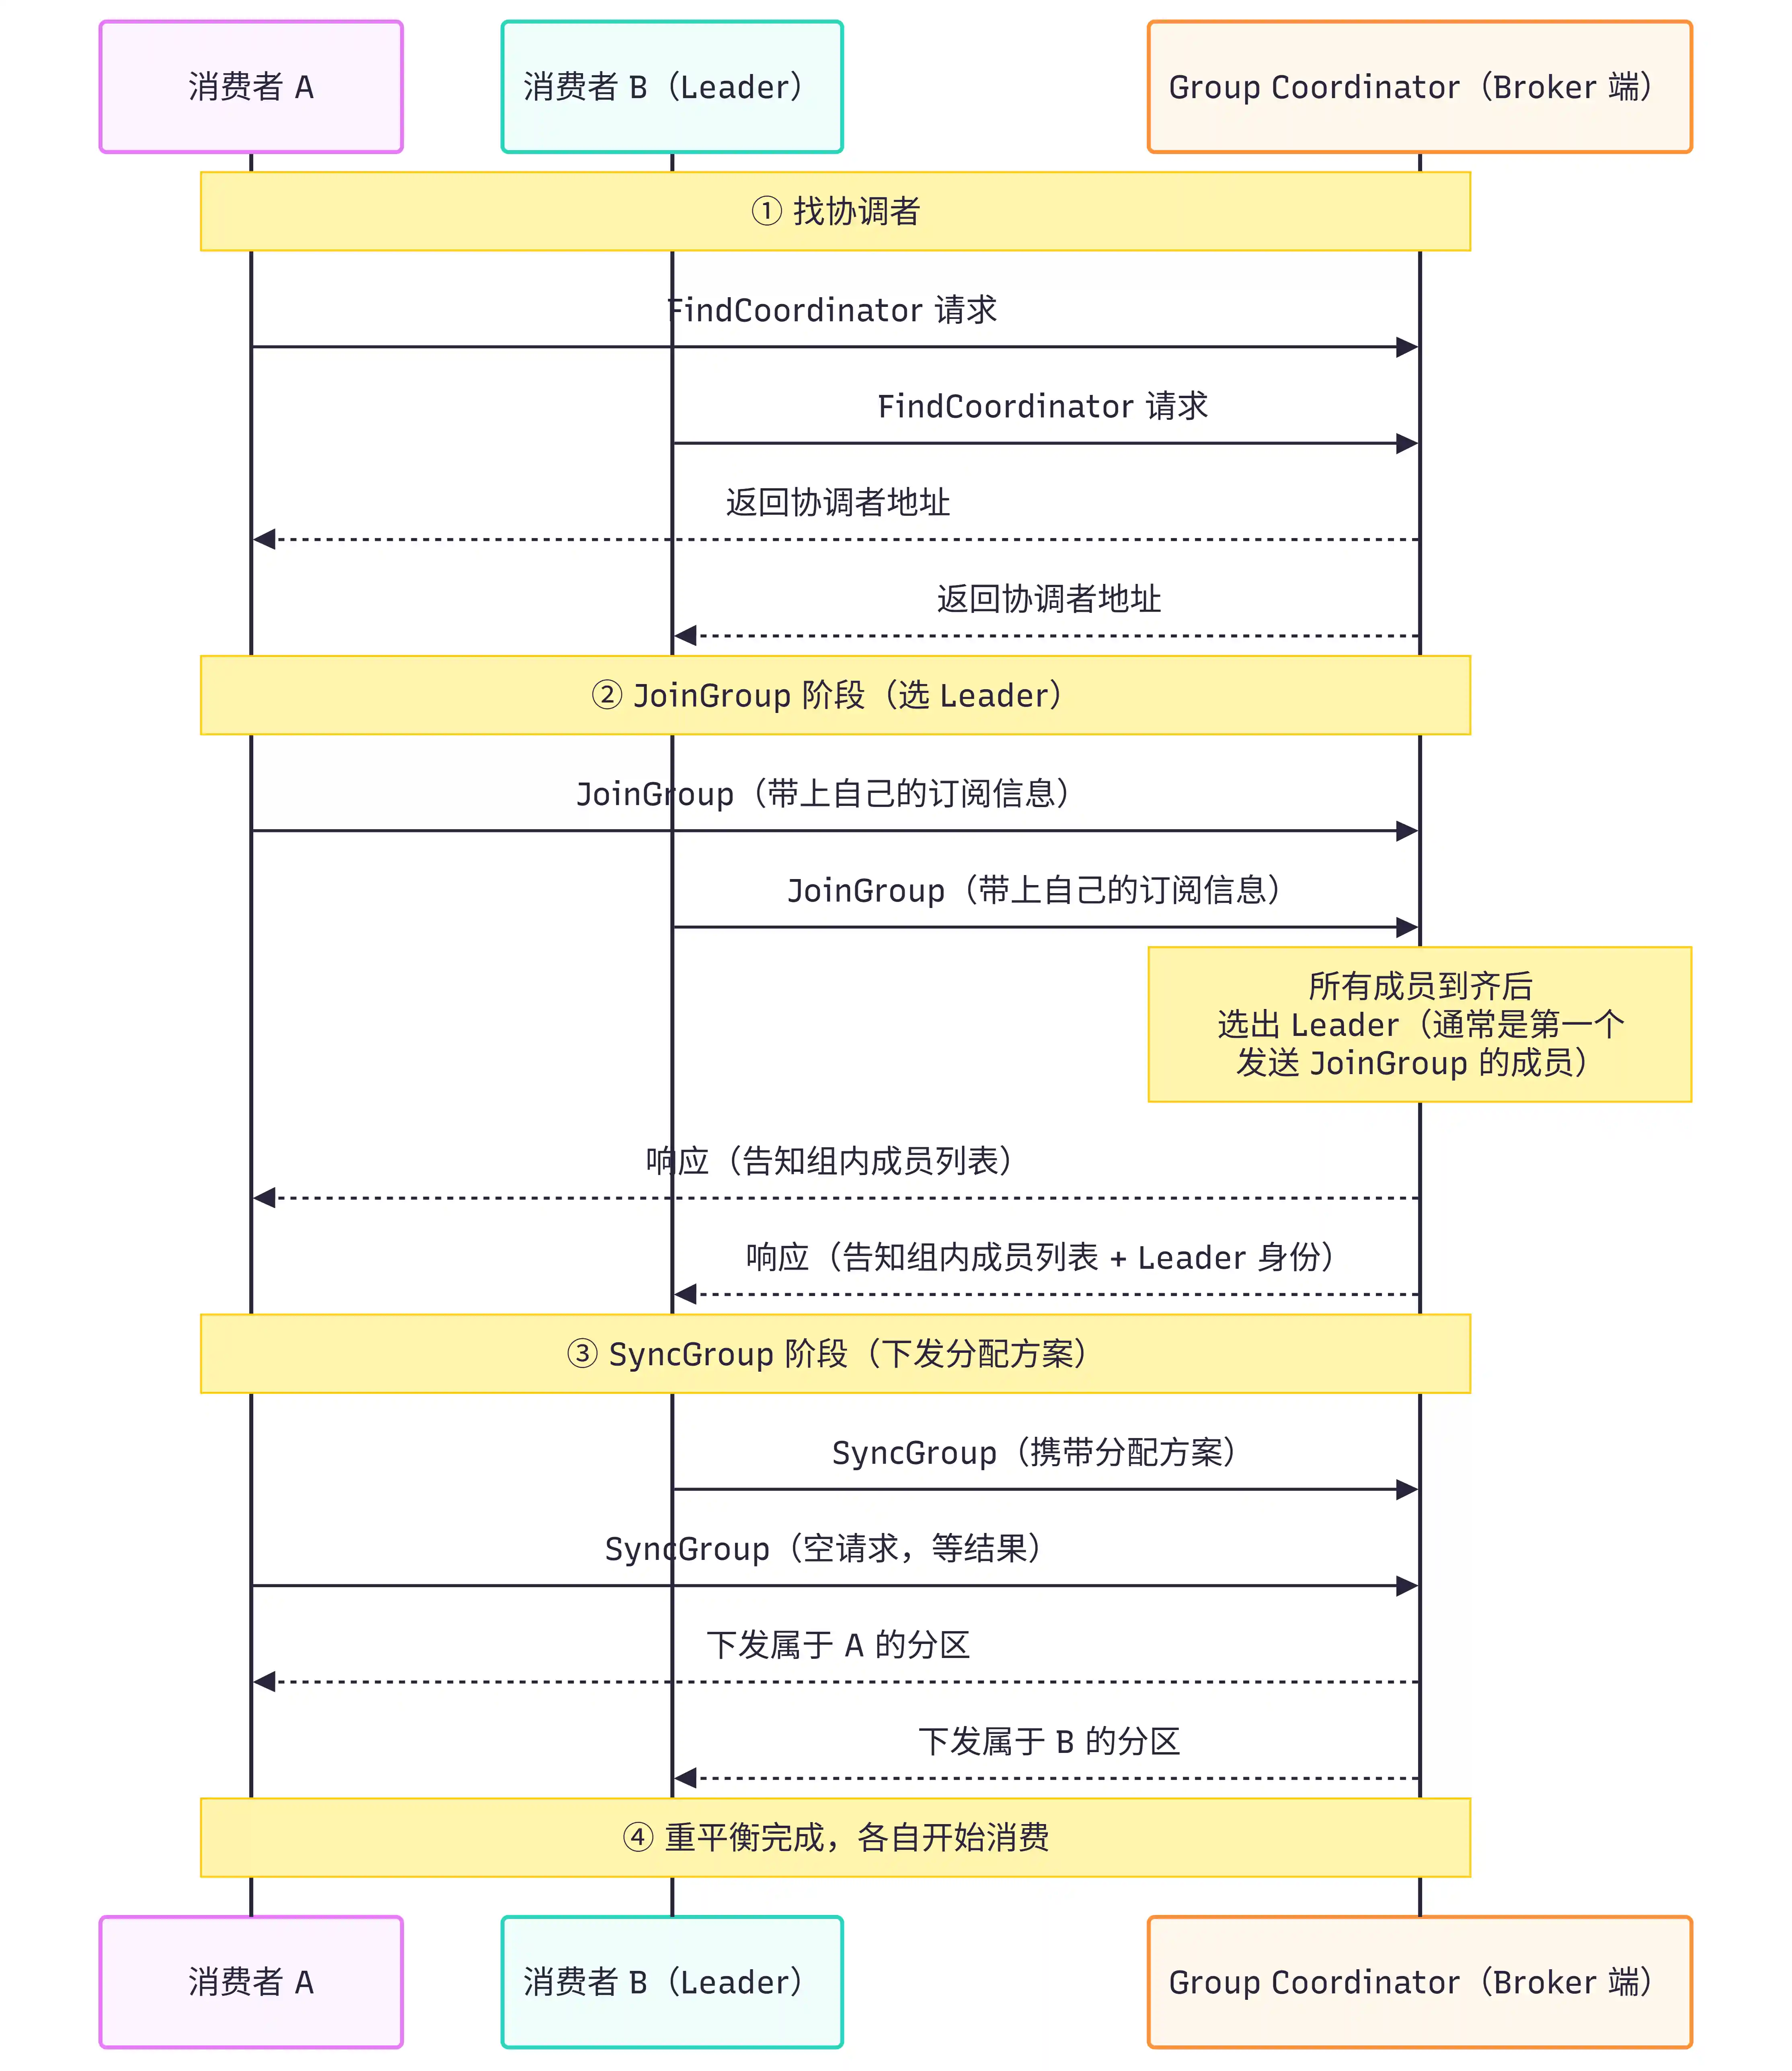
对照上图,把几个关键点掰开说:
- 第一步:找协调者。每个消费者组对应一个
Group Coordinator,它是 Broker 端的协调者,负责管理这个组的成员和重平衡。消费者启动后先发FindCoordinator请求找到它。具体落在哪个 Broker 上,由__consumer_offsets主题对应分区的 Leader 副本所在节点决定,老版本对应关系是取hash(groupId) % 50(offsets.topic.num.partitions默认 50)。 - 第二步:JoinGroup,选 Leader。所有消费者向协调者发送
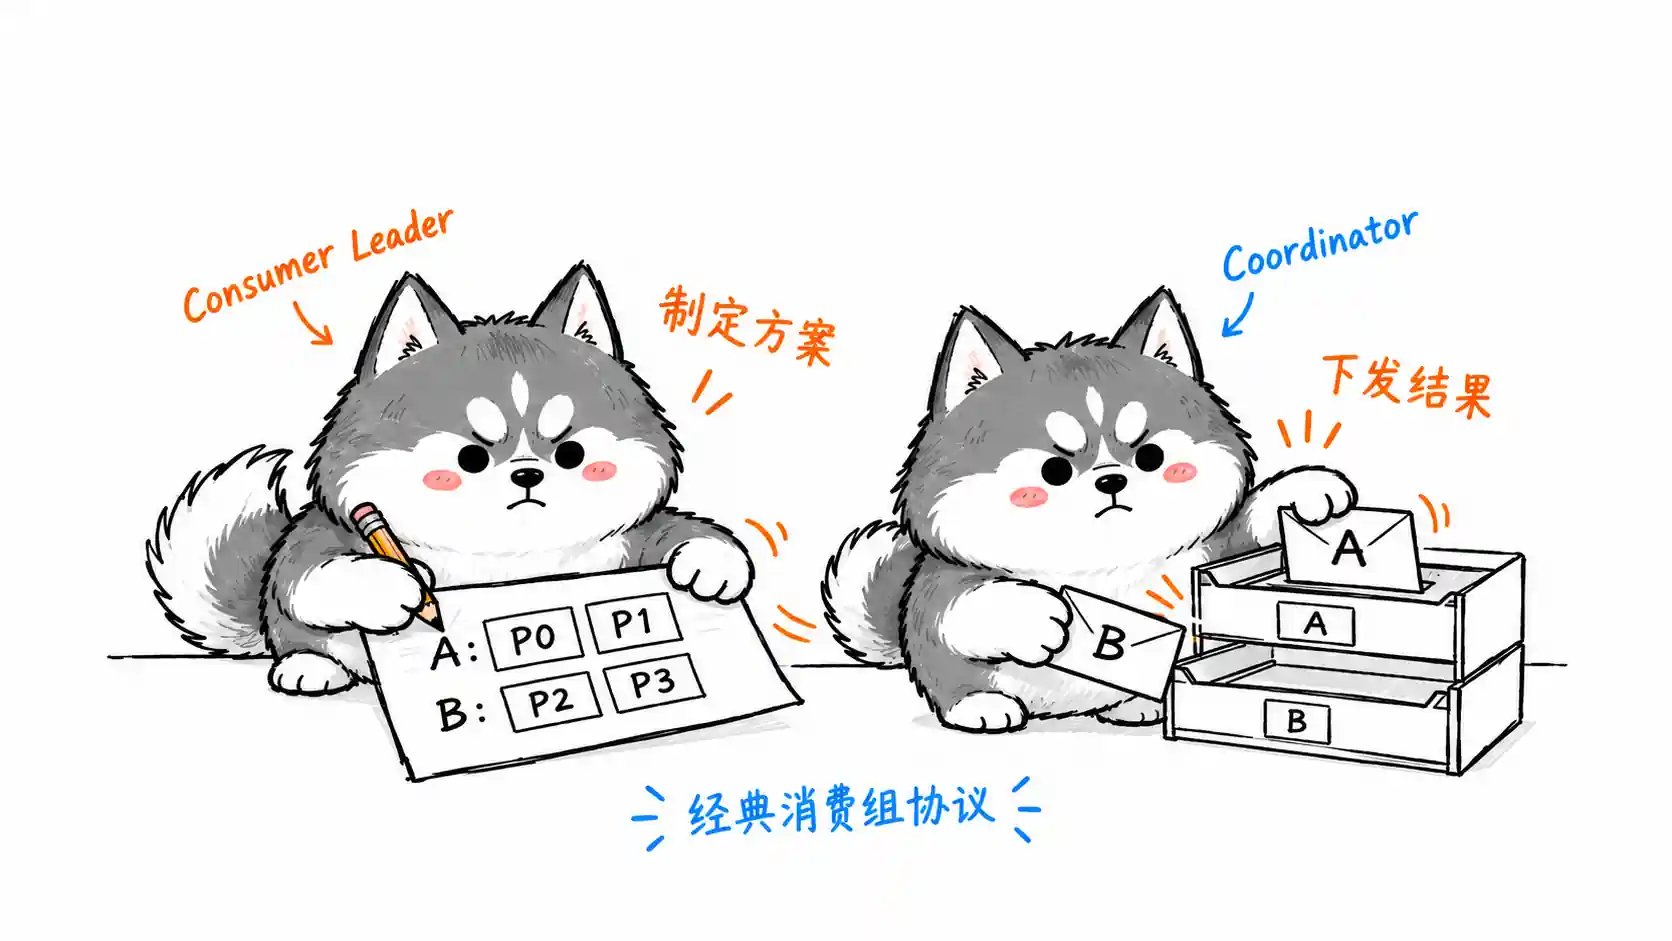
JoinGroup请求,带上自己的订阅信息。协调者等大家都到齐了,从中选出一个成员担任 Leader 消费者(通常是第一个发送JoinGroup的成员)。注意,这个 Leader 是客户端侧的消费者,不是 Broker。只有 Leader 能在响应里拿到完整的成员列表和订阅信息。 - 第三步:SyncGroup,制定并下发分配方案。Leader 根据成员列表和订阅信息,按分配策略算出每个消费者该拿哪些分区,把方案塞进
SyncGroup请求发给协调者;其他消费者也发SyncGroup,但内容为空,纯粹是等结果。协调者收到方案后,把各自的那份下发给每个成员。 - 第四步:恢复消费。所有消费者拿到自己的分区后,从上次提交的位移处继续消费,重平衡结束。
这套设计有个耐人寻味的地方:分配逻辑放在客户端(Leader 消费者)执行,而不是 Broker 执行。好处是分配策略可以灵活定制,客户端升级就能换策略,Broker 不用跟着改。坏处也明显——所有消费者得停下来等 Leader 算方案、等协调者下发,这段时间整个组都在空转。
还有一点必须强调:重平衡期间,组内所有消费者都要释放自己手里的分区,停止消费。不是只调整变化的那部分,而是全部推倒重来(经典协议下确实如此)。分区数多、消费者多的时候,一次重平衡可能持续几分钟,这期间消息堆积蹭蹭往上涨。
四、分区分配策略
Leader 消费者制定方案时,按哪个算法分?这就是分配策略,Kafka 内置了 4 种:
| 策略 | 类名 | 思路 | 问题 |
|---|---|---|---|
| 范围分配(默认) | RangeAssignor |
按主题逐个分配,分区按序号范围切给消费者 | 多个主题下,前面的消费者总会多拿分区,容易倾斜 |
| 轮询分配 | RoundRobinAssignor |
所有主题的分区放一起,逐个轮询分发 | 分配更均匀,但代价是动静大 |
| 粘性分配 | StickyAssignor |
尽量保留上次分配结果,只调整必要的部分 | 减少分区在消费者间搬运 |
| 协作粘性分配 | CooperativeStickyAssignor |
在粘性基础上支持增量重平衡(Kafka 2.4+) | 需要客户端 2.4 以上版本 |
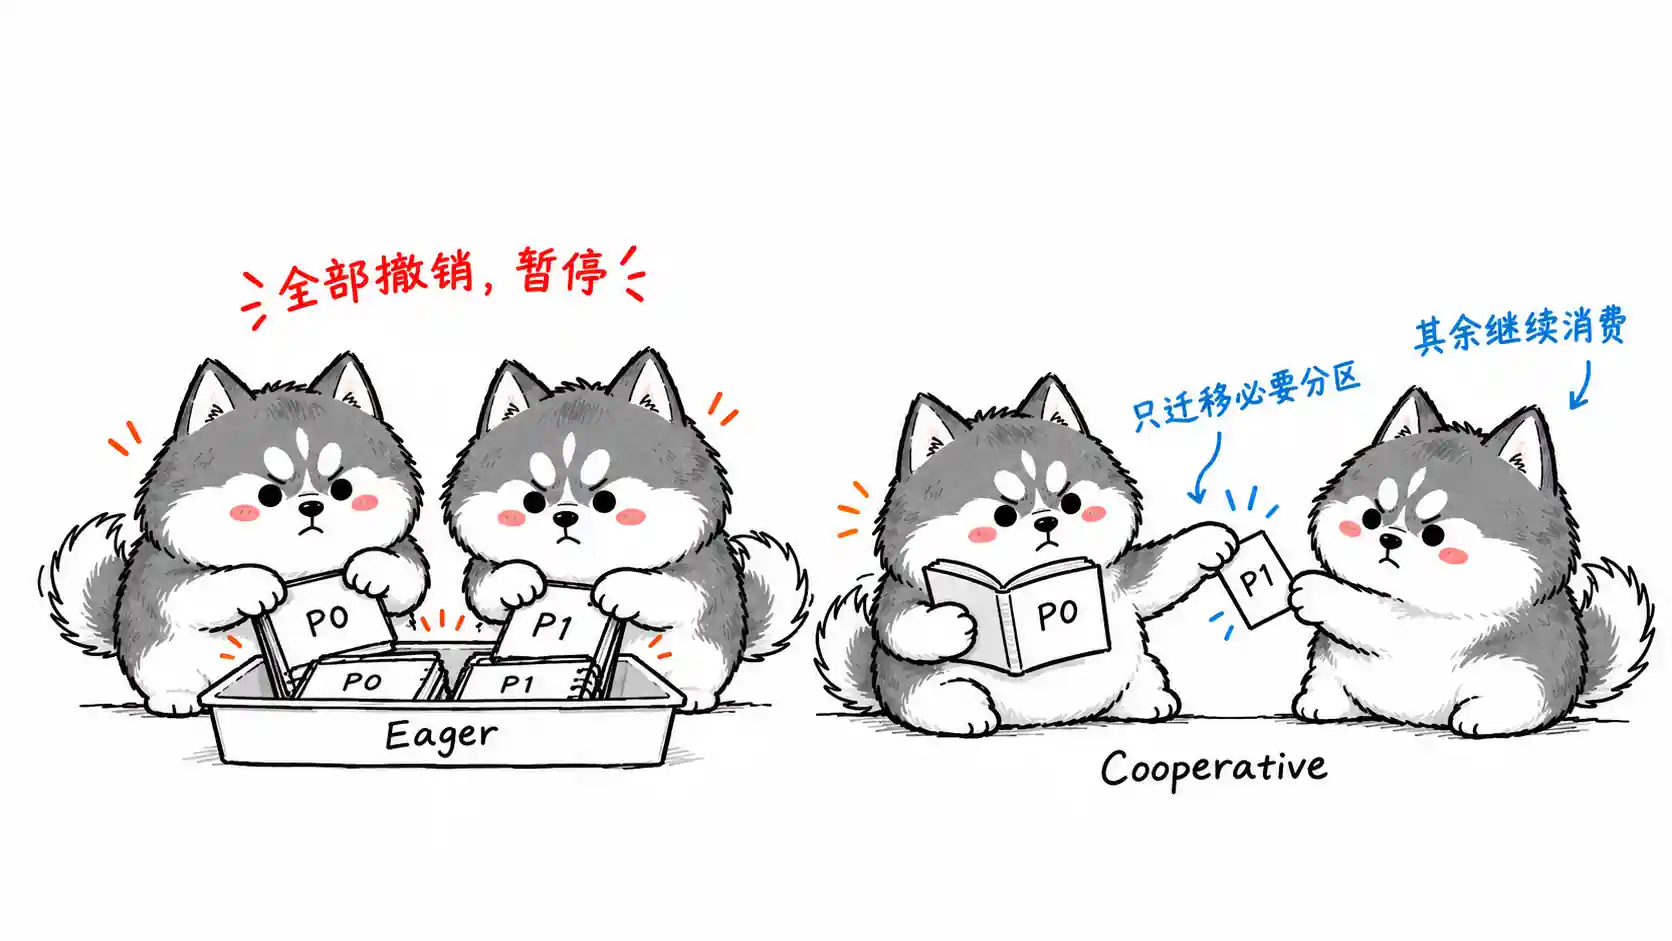
前三种属于 Eager(饥饿式)协议:重平衡一开始,所有消费者无条件撤销全部分区,等新方案出来再重新分配,这就是 STW 的根源。第四种 CooperativeStickyAssignor 是增量式的,下面单独说。
五、重平衡的危害
为什么大家谈重平衡色变?主要是三板斧:
- STW,全组停摆:重平衡期间整个消费者组没法消费消息,分区越多、成员越多,一次拖得越久,代价越惨。
- 重复消费:重平衡发生时,如果消费者还没来得及提交位移就被撤销了分区,新接手的消费者会从上次提交的位置开始消费,中间那段就会被消费两次。
- 连锁反应:上游消费卡住 → 消息堆积 → 下游任务延迟,如果业务上有超时兜底逻辑,一轮重平衡风暴能引发一串告警。
六、如何减少重平衡(生产实践重点)
知道了触发条件,规避思路也就清楚了:让协调者别误判消费者 “死了”。核心参数就这几个。
| 参数 | 默认值 | 作用 | 调优建议 |
|---|---|---|---|
session.timeout.ms |
45s(3.0 之前是 10s,KIP-735 调整) | 会话超时时间,超过没心跳就判死 | 不要设太短,网络抖一下就误杀 |
heartbeat.interval.ms |
3s | 心跳间隔 | 一般设为 session.timeout.ms 的 1/3 |
max.poll.interval.ms |
5min | 两次 poll() 的最大间隔 |
业务处理慢就调大,这是 “被踢群” 的头号原因 |
max.poll.records |
500 | 单次 poll() 拉取的最大条数 |
处理慢就调小,让 poll() 更频繁 |
除了调参数,还有两个更治本的招:
1. 静态成员资格(Kafka 2.3+)
给每个消费者配置一个固定的 group.instance.id,重启后协调者认得它是 “老熟人”,不触发重平衡。这对滚动发布场景特别友好——发布重启不再引发组内风暴。
2. 增量协作式重平衡(Kafka 2.4+)
把分配策略换成 CooperativeStickyAssignor,重平衡不再 “全部回收重来”,而是只回收需要迁移的分区,其他分区照常消费。两次小协商就能完成,把 STW 的范围缩到了最小。新项目建议直接上这个。
七、一提新版本:KIP-848
经典协议的 JoinGroup/SyncGroup 机制被诟病多年,Kafka 社区在 2.4 引入增量式协作重平衡之后,又在 KIP-848 里拿出了换代方案 全新的消费者组协议:消费者不再推举 Leader,也不用客户端算分配方案,直接向 Broker 端的组协调者上报订阅信息,由服务端单方面分配。重平衡期间消费者也不用停消费。这套协议在 Kafka 3.7 进入早期预览,4.0 已经正式转正(GA)。面试里提到 KIP-848,绝对是区分度拉满的加分项。
面试高频追问
-
追问一:重平衡期间消费者还能消费消息吗?
经典协议(Eager)下不能,所有消费者撤销分区、暂停消费,直到新方案下发。这也是重平衡最大的痛点。Kafka 2.4 的
CooperativeStickyAssignor支持增量式,只撤销要迁移的分区,其余不受影响。 -
追问二:消费者被踢出组的判定条件是什么?
两条:一是
session.timeout.ms内没收到心跳,协调者认为它挂了;二是两次poll()间隔超过max.poll.interval.ms,消费者主动离组。这两种情况都会触发重平衡。 -
追问三:
__consumer_offsets和重平衡有什么关系?__consumer_offsets是存储消费位移的内部主题,每个消费者组的Group Coordinator就落在该主题某个分区的 Leader 副本所在的 Broker 上,所以它和协调者的定位有关。同时位移提交失败(比如重平衡进行中提交)还会返回REBALANCE_IN_PROGRESS异常。 -
追问四:怎么排查线上频繁重平衡的问题?
先看日志里的
Attempt to heartbeat failed、Rebalance关键字,再对时间点,区分是成员真变了还是误判。误判就查max.poll.interval.ms是否太小、心跳线程是否被长时间 GC 打断、网络是否抖动。最后考虑静态成员资格 + 协作式分配。
常见面试变体
- 变体一:Kafka 重平衡的触发条件有哪些?
- 变体二:Kafka 消费者组的分配策略有哪几种?
- 变体三:如何避免 Kafka 频繁重平衡?
- 变体四:Kafka 2.4 的增量协作式重平衡和经典重平衡有什么区别?
记忆口诀
触发条件:成员变、主题变、分区变。流程四步:找协调者 → 入组选 Leader → Leader 出方案 → 协调者发方案。规避三招:心跳别太紧、拉取别太狠、上静态成员。
总结
一句话:重平衡是消费者组在成员或分区变化时重新分配分区的自愈机制,由 Group Coordinator 和 Leader 消费者通过 JoinGroup/SyncGroup 两阶段协作完成。它换来的是消费组的弹性,但代价是全组 STW,生产环境要用好 max.poll.interval.ms 等参数、静态成员资格和协作式分配,把不必要的重平衡摁住。