Kafka 消息的发送过程简单介绍一下?
一则或许对你有用的小广告
欢迎加入小哈的星球,你将获得:专属的实战项目(4个项目都能学) / 1v1 提问 / 简历修改 / Java 学习路线 / 社群讨论 / 学习打卡 / 每月赠书
《Spring AI 项目实战(问答机器人、RAG 智能客服、联网搜索)》已完结,基于
Spring AI + Spring Boot 3.x + JDK 21...,查看介绍《从零手撸:仿小红书(微服务架构)》 已完结,基于
Spring Cloud Alibaba + Spring Boot 3.x + JDK 17...,查看介绍;演示链接:http://116.62.199.48:7070/《从零手撸:前后端分离博客项目(全栈开发)》 2 期已完结,演示链接:http://116.62.199.48/
新开坑项目:《从零手撸:秒杀系统高并发优化实战》 正在更新中...,查看介绍
截止目前,星球内专栏累计输出 150w+ 字,讲解图 5110+ 张,还在持续爆肝中.. 后续还会上新更多项目,已有 4700+ 小伙伴加入学习,欢迎点击围观
面试考察点
-
主流程掌握度:面试官想知道你是不是真的理解 KafkaProducer 内部干了什么,而不是只会调 API。消息从
send()到落盘,中间经历了序列化、分区、攒批、网络发送这一整条链路,能不能讲清楚很见功力。 -
异步与批量思维:Kafka 高吞吐的底气就在 “批量 + 异步” 这套设计上。面试官想看的是,你讲不讲得清为什么生产者要攒批次再发、而不是一条一条发。
-
参数与调优意识:
batch.size、linger.ms、buffer.memory这几个参数直接影响吞吐和延迟,结合参数讲流程的人,大概率在生产环境真调过。
核心答案
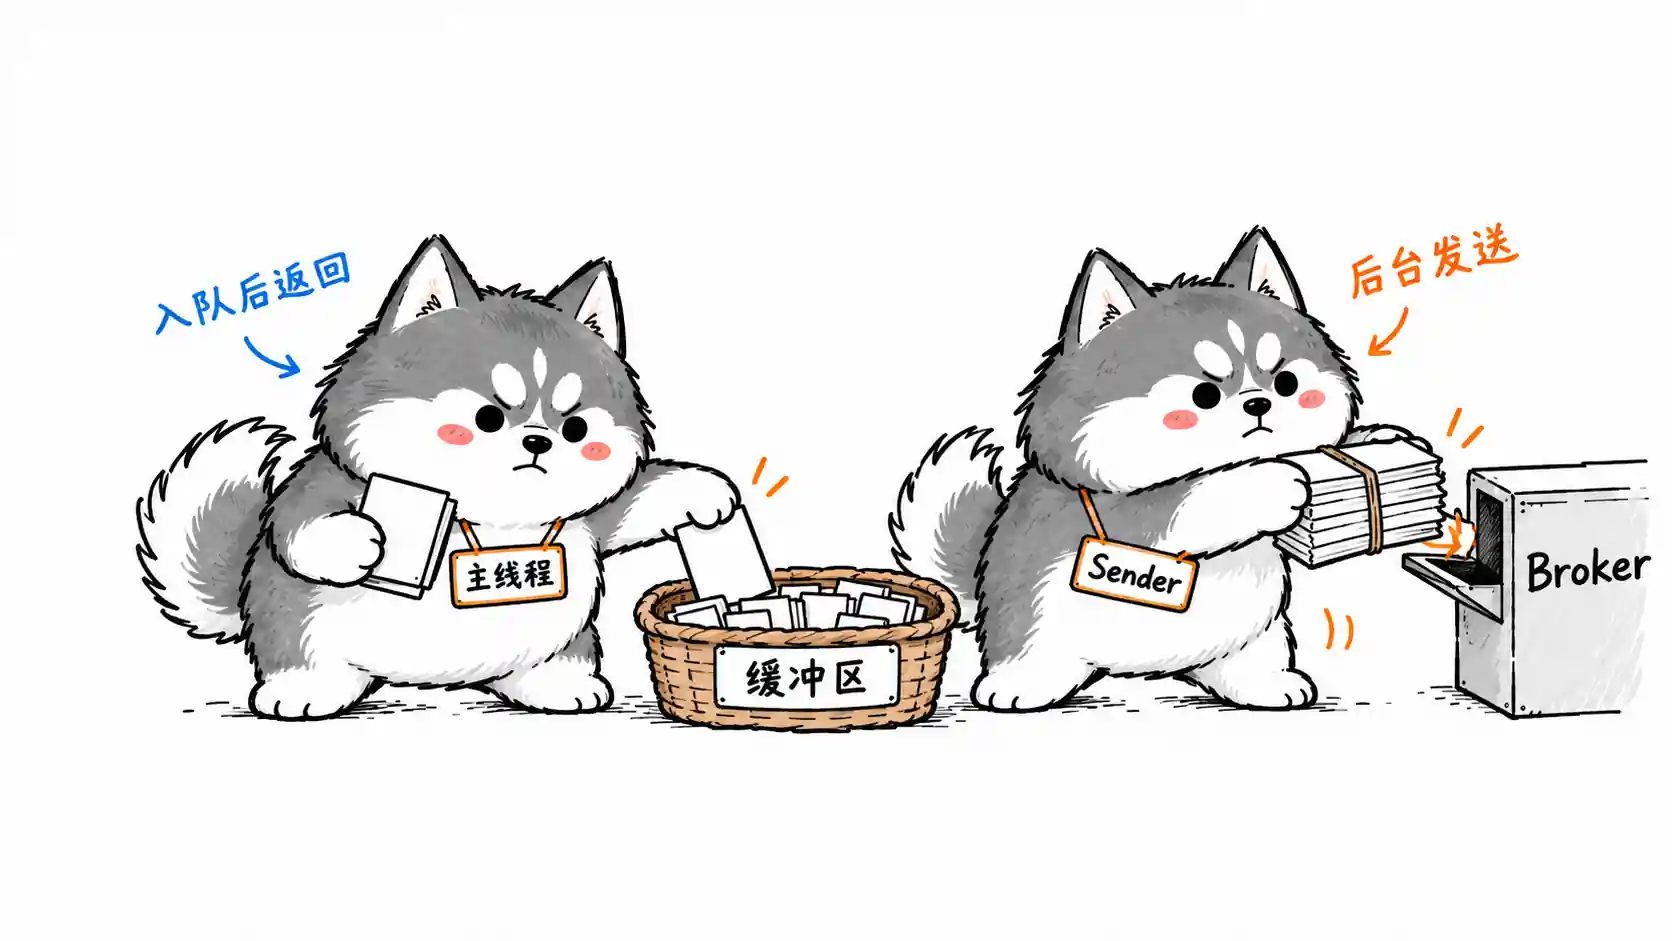
先给结论:Kafka 生产者发送消息是 “两条线程 + 一个缓冲区” 的异步模型。
| 阶段 | 干活的角色 | 核心动作 |
|---|---|---|
| 1. 拦截 | 主线程 | ProducerInterceptor 消息拦截(可选) |
| 2. 序列化 | 主线程 | Serializer 把 key/value 转成字节数组 |
| 3. 分区 | 主线程 | Partitioner 决定消息去哪个分区 |
| 4. 攒批 | 主线程 | 消息追加进 RecordAccumulator 的批次队列 |
| 5. 网络发送 | Sender 线程 | 取出就绪批次,按 broker 分组发出去 |
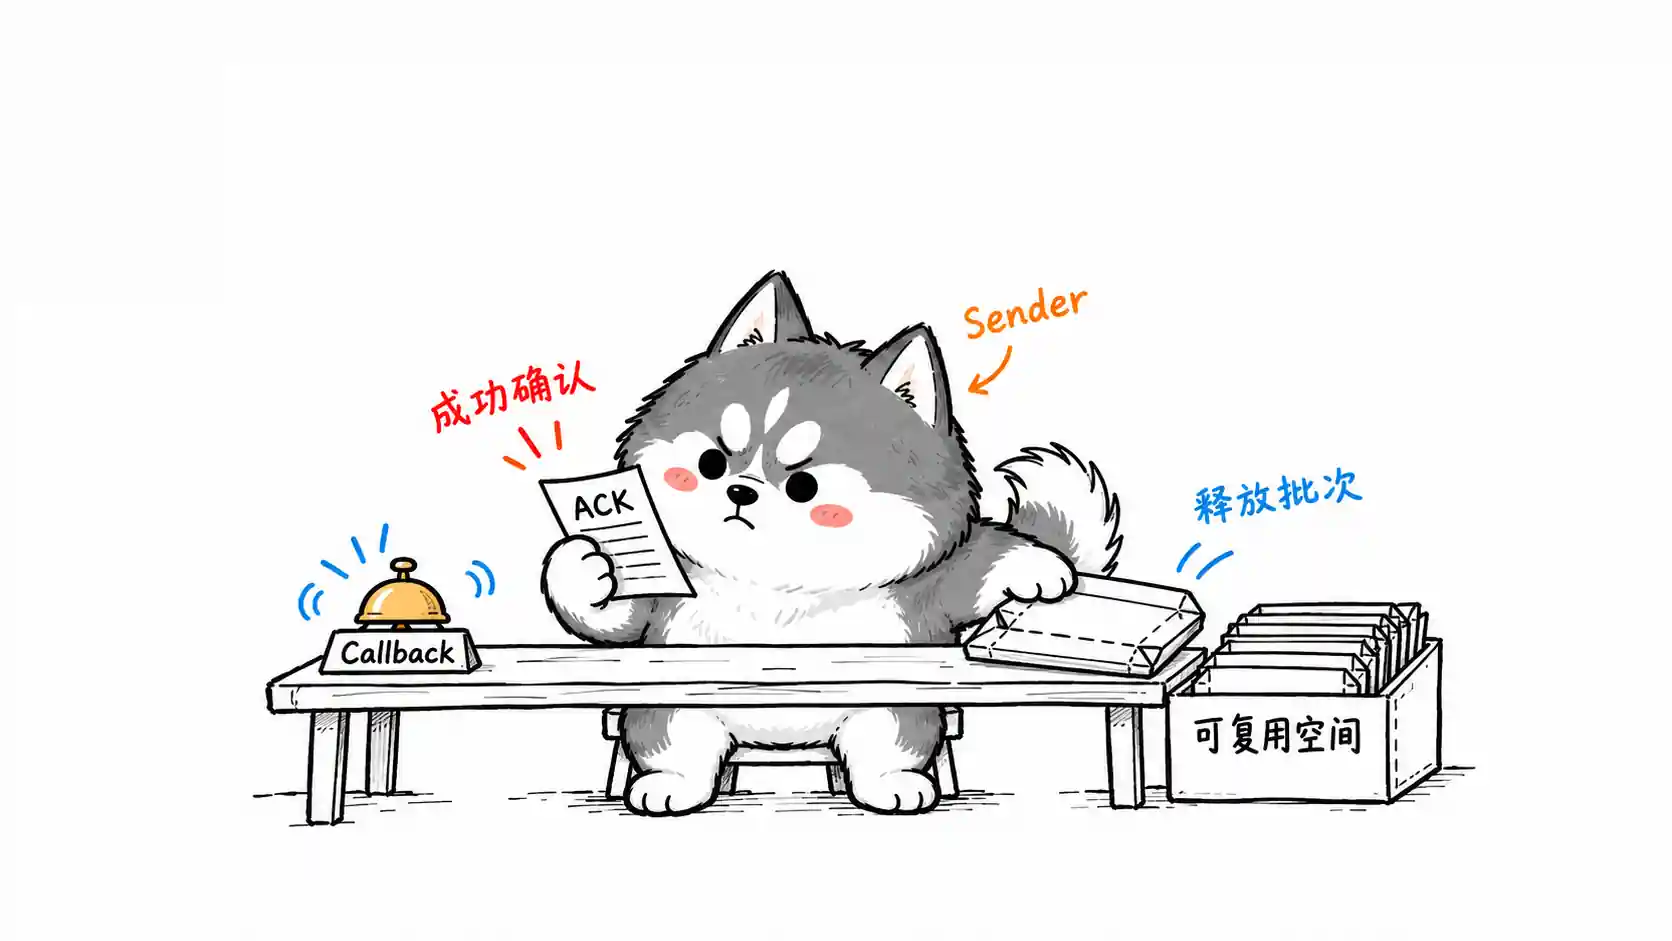
| 6. 响应回调 | Sender 线程 | 收到 broker ACK 后执行回调,释放批次 |
一句话概括:主线程只管把消息往内存里塞,真正的网络 IO 由后台的 Sender 线程全权负责。生产者高吞吐,靠的就是这套分工。
深度解析
一、整体流程图
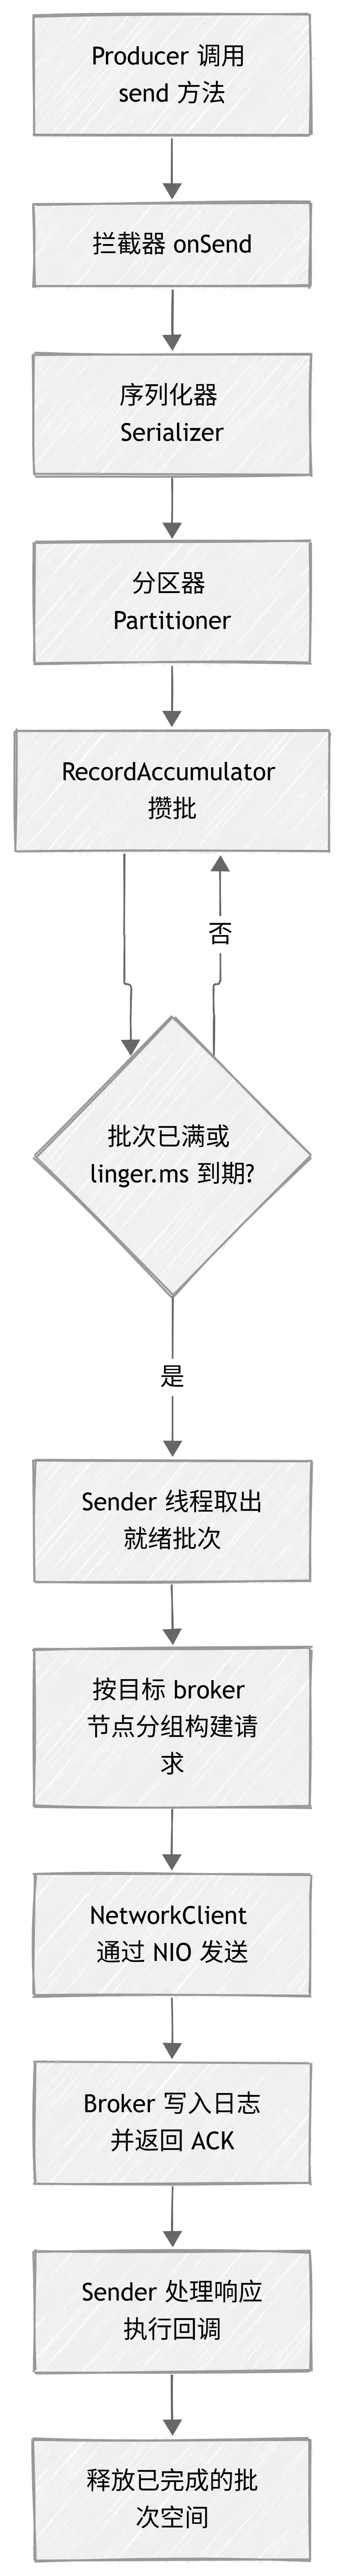
上图就是消息的完整旅程,拆开来看每个环节:
- 拦截器:
ProducerInterceptor的onSend()最先被调用,一般用来打埋点、补充消息头,多数业务用不上,但面试提一嘴是加分项。 - 序列化:key 和 value 各自走配置的
Serializer,转成byte[]。Kafka 不会替你存对象,网络上传的全是字节数组。 - 分区:决定这条消息去哪个分区,规则下面细说。
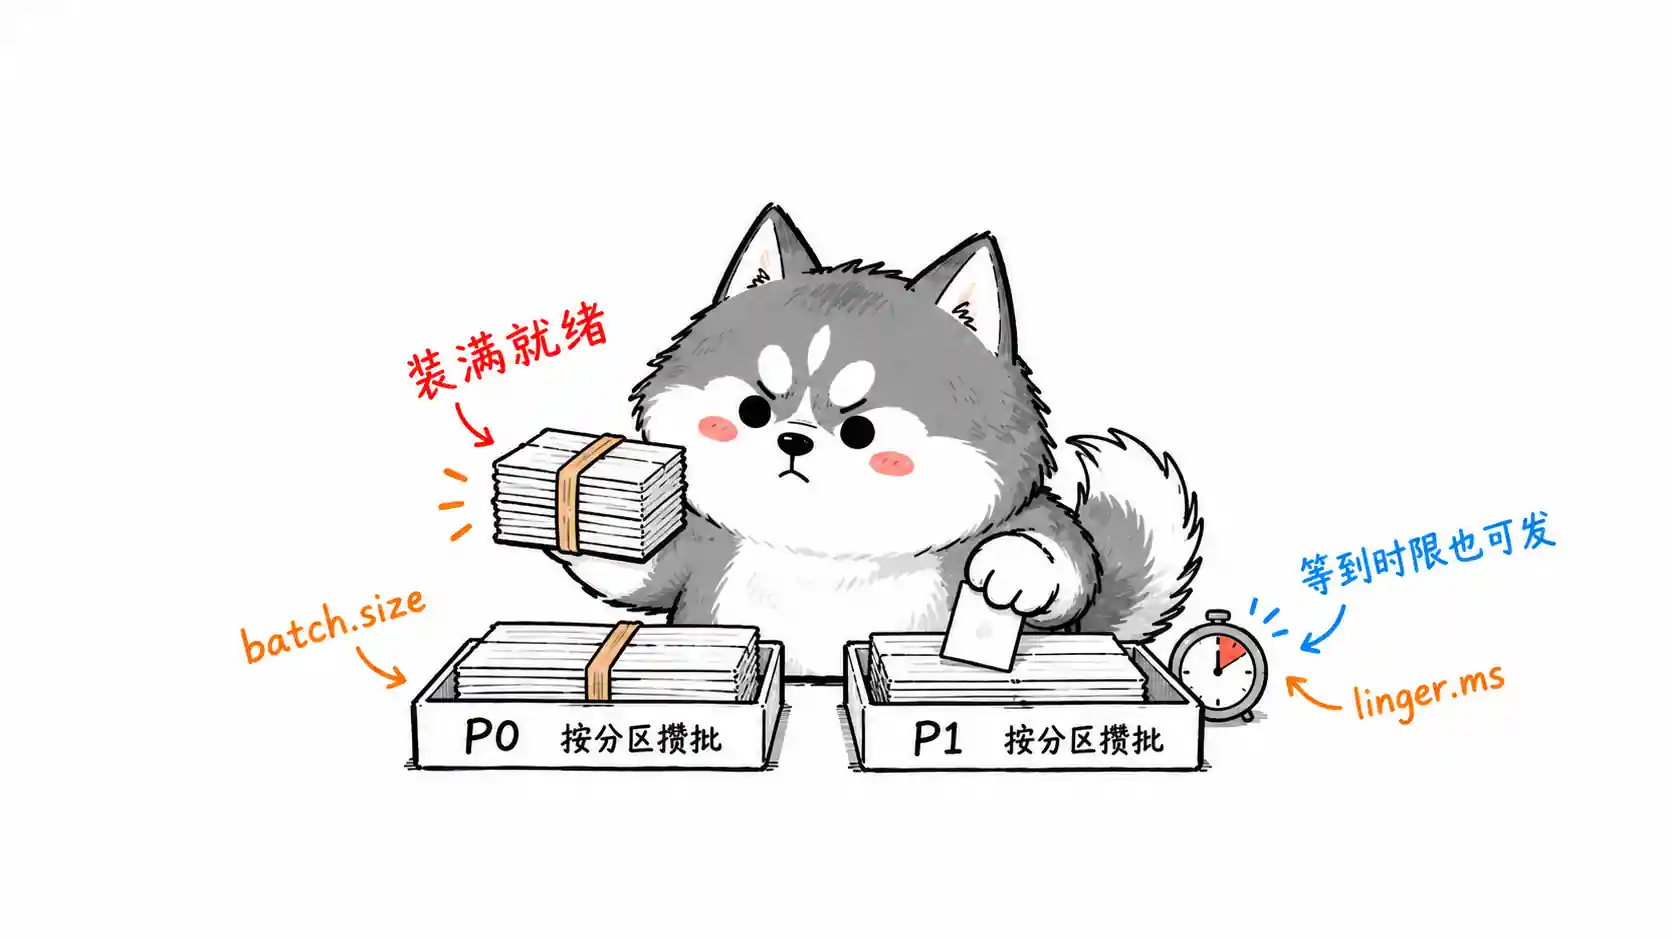
- 攒批:消息不会直接发网络,而是进
RecordAccumulator(一个 32MB 左右的内存缓冲区),它为每个分区维护一个双端队列Deque<ProducerBatch>,消息往批次尾部追加。 - 网络发送:后台的 Sender 线程(一个死循环的 Runnable)不停检查哪些批次 “就绪” 了,要么批次写满(
batch.size,默认 16KB),要么等待超时(linger.ms)。就绪的批次按目标 broker 分组,包装成ClientRequest交给NetworkClient,底层走 Java NIO 发出去。 - 响应处理:broker 落盘后返回 ACK,Sender 收到响应就触发你
send()时传的那个回调,Callback里的onCompletion()被执行,批次占用的内存随之释放。
二、分区器怎么选分区
分区这步是面试官最爱追问的,规则一共三条,按优先级来:
- 指定了 partition 字段:直接用,别的都不看。
- 有 key 没 partition:对 key 做 murmur2 哈希再对分区数取模,
toPositive(murmur2(keyBytes)) % numPartitions。所以同一个 key 的消息永远进同一个分区,这就是 Kafka 保分区有序的基础。 - 既没 partition 也没 key:Kafka 2.4 之前是轮询(Round Robin),2.4 之后改成了粘性分区,先黏住一个分区把批次填满,填满再换下一个。这样小流量场景也能凑出完整的批次,吞吐明显更好。Kafka 3.3 又引入了均匀粘性分区(KIP-794),切换分区时会按分区大小做加权,流量分布更均匀。这几个版本差异,说出来就是加分项。
三、代码里感受一下
// 创建生产者(关键配置都标了注释)
Properties props = new Properties();
props.put("bootstrap.servers", "localhost:9092");
props.put("key.serializer", "org.apache.kafka.common.serialization.StringSerializer");
props.put("value.serializer", "org.apache.kafka.common.serialization.StringSerializer");
props.put("batch.size", "16384");       // 批次大小,默认 16KB
props.put("linger.ms", "5");            // 攒批等待 5ms,吞吐换延迟的权衡
props.put("acks", "all");               // 等待所有 ISR 副本确认
props.put("buffer.memory", "33554432"); // 缓冲区默认 32MB

KafkaProducer<String, String> producer = new KafkaProducer<>(props);

// 异步发送:send 方法几乎立刻返回,消息只是进了缓冲区
producer.send(new ProducerRecord<>("order-topic", orderId, orderJson),
        (metadata, exception) -> {
            // 这个回调由 Sender 线程在收到 broker 响应后触发
            if (exception != null) {
                log.error("发送失败: {}", orderId, exception);
            } else {
                log.info("分区: {}, 偏移量: {}", metadata.partition(), metadata.offset());
            }
        });
注意 send() 返回的其实是个 Future<RecordMetadata>,急着拿结果可以调 .get() 同步阻塞,但那样就退化成同步发送了,一般不这么干。
四、缓冲区满了会怎样
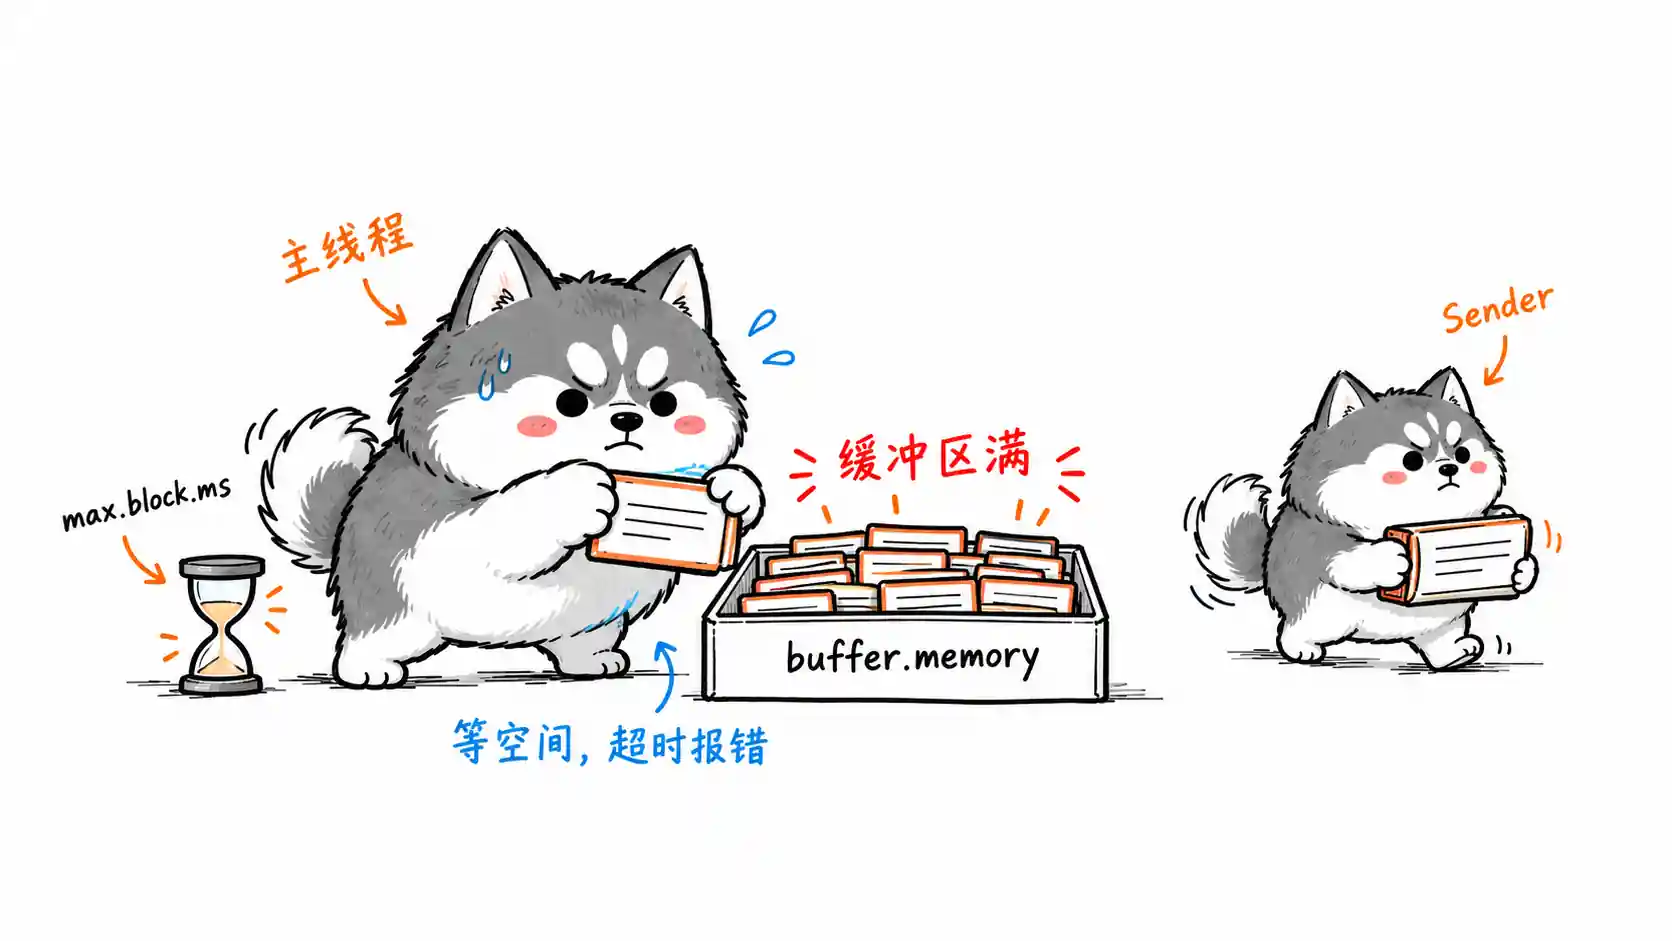
这是个隐藏考点。如果 Sender 发得慢、主线程塞得快,buffer.memory 被榨干之后,send() 会阻塞,最长等 max.block.ms(默认 60 秒),超时直接抛异常。所以生产上如果看到发送超时报错,先想缓冲区是不是不够,或者 broker 是不是卡了。
面试高频追问
-
acks参数有哪几个值?0:发了就算完,不等确认,吞吐最高但可能丢消息;1:Leader 写入就算成功,Leader 挂了且未同步时可能丢;all:等所有 ISR 副本确认,最可靠。Kafka 3.0 之后默认值已经从1改成all了。 -
重试会导致消息乱序吗?
会。
max.in.flight.requests.per.connection大于 1 且开启重试时,前面的批次失败重发,后面的批次可能先到。解法是开幂等(enable.idempotence=true),broker 端靠 PID + 序列号去重,max.in.flight不超过 5 就能保住分区有序。Kafka 3.0 之后幂等默认就是开着的,很多人升完级都没察觉。 -
怎么提高生产者的吞吐?
调大
batch.size和linger.ms换批量收益,开压缩(compression.type=lz4),再确认acks不是拖后腿的配置。本质都是在延迟和吞吐之间做权衡。
常见面试变体
- “Kafka 生产者为什么是线程安全的?多个线程共用一个实例可以吗?”(可以,且推荐,KafkaProducer 线程安全,省连接开销)
- “
send()之后消息马上就发出去吗?”(不是,进缓冲区等批次) - “生产者的幂等性是怎么实现的?”(broker 端记录 PID + 序列号去重)
记忆口诀
主线程三件事:拦截、序列化、选分区;Sender 两件事:攒批满了就发送、收到 ACK 跑回调。
总结
Kafka 发送消息的骨架就是 “主线程塞缓冲区,Sender 线程发网络”:send() → 拦截 → 序列化 → 分区 → 进 RecordAccumulator 攒批 → Sender 按 broker 分组用 NIO 发出 → broker ACK → 回调释放。把这条线讲顺,再带上粘性分区、linger.ms 攒批和 acks 这几个细节,这道题基本就拿捏了。