Kafka 如何保证消息不丢失?
一则或许对你有用的小广告
欢迎加入小哈的星球,你将获得:专属的实战项目(4个项目都能学) / 1v1 提问 / 简历修改 / Java 学习路线 / 社群讨论 / 学习打卡 / 每月赠书
《Spring AI 项目实战(问答机器人、RAG 智能客服、联网搜索)》已完结,基于
Spring AI + Spring Boot 3.x + JDK 21...,查看介绍《从零手撸:仿小红书(微服务架构)》 已完结,基于
Spring Cloud Alibaba + Spring Boot 3.x + JDK 17...,查看介绍;演示链接:http://116.62.199.48:7070/《从零手撸:前后端分离博客项目(全栈开发)》 2 期已完结,演示链接:http://116.62.199.48/
新开坑项目:《从零手撸:秒杀系统高并发优化实战》 正在更新中...,查看介绍
截止目前,星球内专栏累计输出 150w+ 字,讲解图 5110+ 张,还在持续爆肝中.. 后续还会上新更多项目,已有 4700+ 小伙伴加入学习,欢迎点击围观
面试考察点
-
全局视角:面试官要的不只是几个配置参数,更想看你脑子里有没有 “消息从生产到消费” 的完整链路图,也就是消息可能在哪丢、为什么会在那丢。
-
生产实践意识:考察你是不是真在生产环境用过 Kafka。背参数谁都会,但
acks=all为什么要配min.insync.replicas=2一起用?答得出这个层次关系的,大概率踩过坑。 -
原理理解深度:副本机制(ISR)、Leader 选举、offset 提交时机,这些底层逻辑不清楚,参数就是死记硬背,追问两句就露馅。
核心答案
先说结论:消息丢失只可能发生在三个环节,生产者发消息时、Broker 存消息时、消费者消费时。防丢失就是三端各配一手,缺一不可。
| 环节 | 丢失场景 | 关键配置 |
|---|---|---|
| 生产者 | 发送失败没重试 | acks=all、retries 调大、用带回调的 send() |
| Broker | Leader 挂了、副本没同步 | replication.factor>=3、min.insync.replicas>=2、unclean.leader.election.enable=false |
| 消费者 | 先提交 offset 再处理,处理失败消息就丢了 | enable.auto.commit=false,处理完手动提交 |
下面把三个环节一个个拆开讲。
深度解析
一、先搞清楚消息会在哪丢
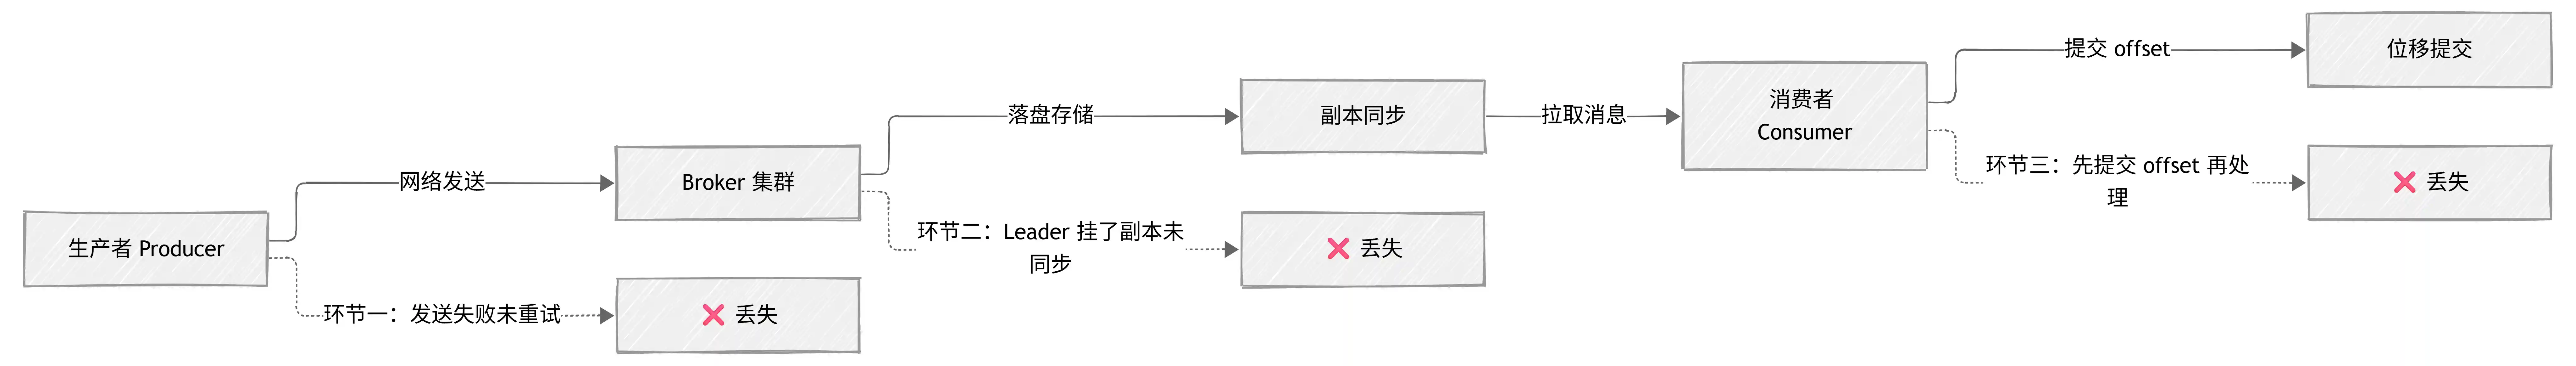
上图就是消息的完整生命周期,三个虚线指向的位置就是消息可能丢失的地方。链路本身不复杂,复杂的是每个环节背后的保障机制:
- 环节一,生产者发送:网络抖动、Broker 繁忙都可能导致发送失败,如果发了就不管(发后即忘),失败了你都不知道
- 环节二,Broker 存储:消息刚写到 Leader,还没来得及同步给 Follower,Leader 所在机器就宕机了,这条消息就没了
- 环节三,消费者消费:这个最冤枉,消息明明拉下来了,但 offset 提交时机不对,处理一半崩了,重启后这条消息再也不会被消费
记住这张图,后面的所有配置都是围绕堵这三个口子来的。
二、生产者端:acks 是灵魂
生产者端最核心的参数是 acks,它决定了 Broker 多快返回确认:
| acks 值 | 含义 | 丢失风险 |
|---|---|---|
0 |
发出去就算成功,不等确认 | 高,网络抖一下消息就没了 |
1 |
Leader 写入本地日志即确认 | 中,Leader 刚确认就宕机、Follower 还没同步,消息丢 |
all(即 -1) |
所有 ISR 副本都写入才确认 | 低,配合 min.insync.replicas 使用 |
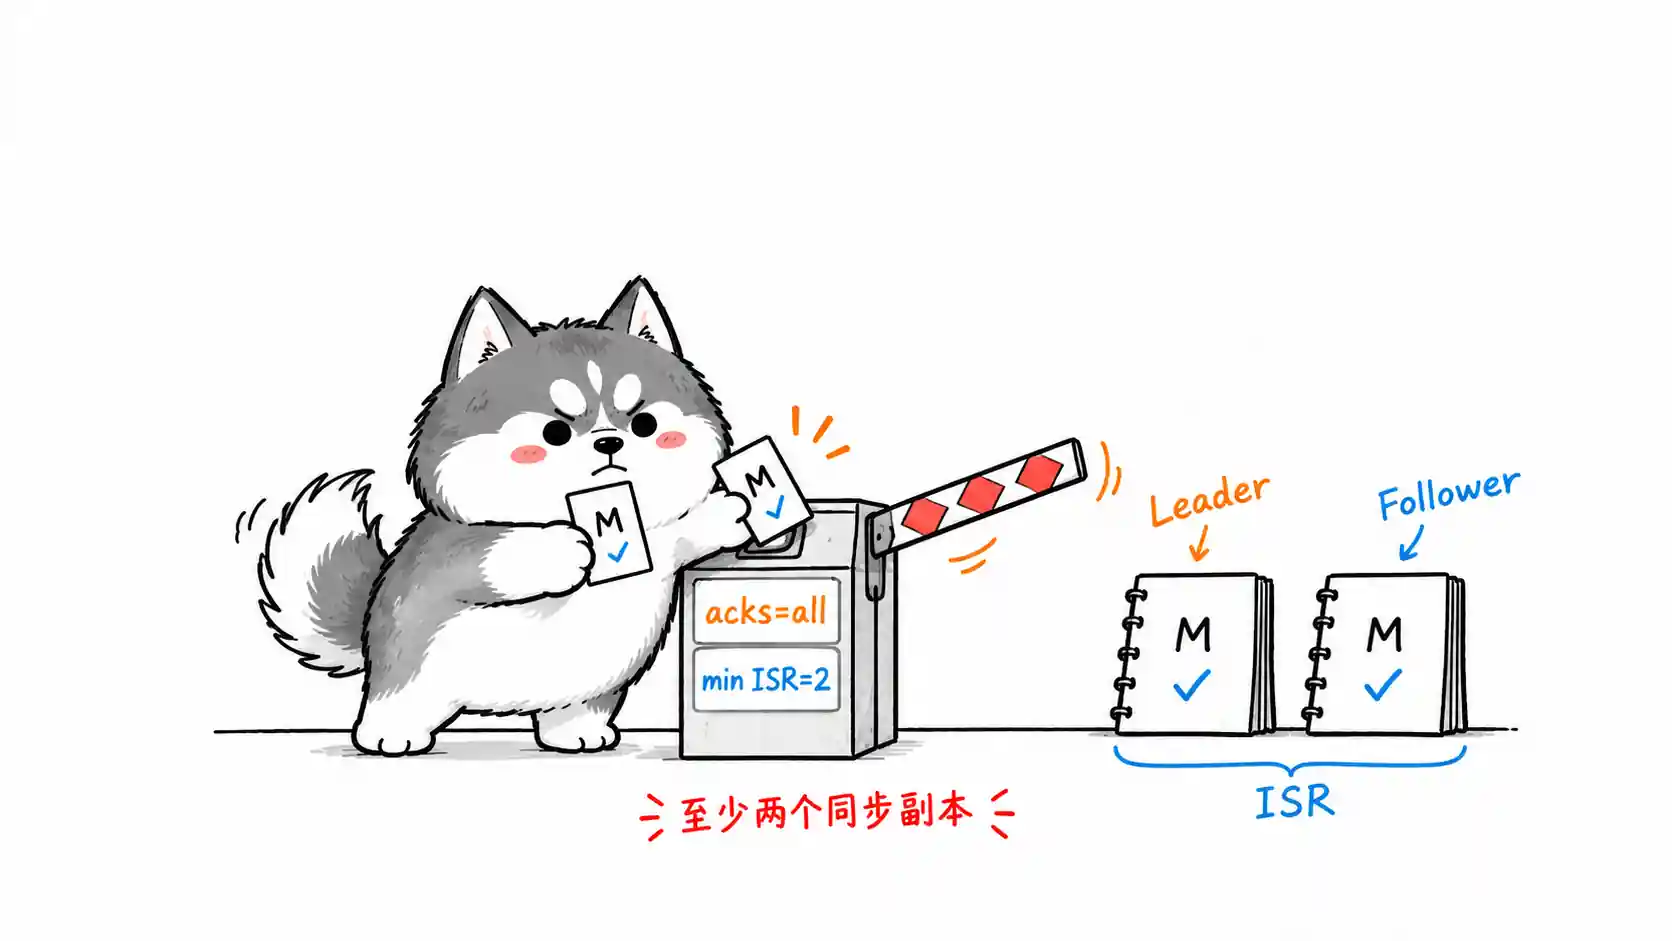
要防丢失,acks=all 是必选项。但注意,acks=all 单独用是不够的,它说的是 “ISR 里的副本都写入”,如果 ISR 里只剩 Leader 自己一个副本,那 all 就退化成了 1。所以它必须和 Broker 端的 min.insync.replicas 搭配,这个下一节细说。
生产者的完整防丢失配置大概长这样:
Properties props = new Properties();
// 所有 ISR 副本写入成功才确认,防丢失的核心
props.put(ProducerConfig.ACKS_CONFIG, "all");
// 失败自动重试,配合 delivery.timeout.ms 控制总重试时长
props.put(ProducerConfig.RETRIES_CONFIG, Integer.MAX_VALUE);
// 单条消息超时时间,默认 2 分钟,一般够用
props.put(ProducerConfig.DELIVERY_TIMEOUT_MS_CONFIG, 120000);
// 开启幂等,防止重试导致的消息重复(不防丢,但防重)
props.put(ProducerConfig.ENABLE_IDEMPOTENCE_CONFIG, true);

KafkaProducer<String, String> producer = new KafkaProducer<>(props);

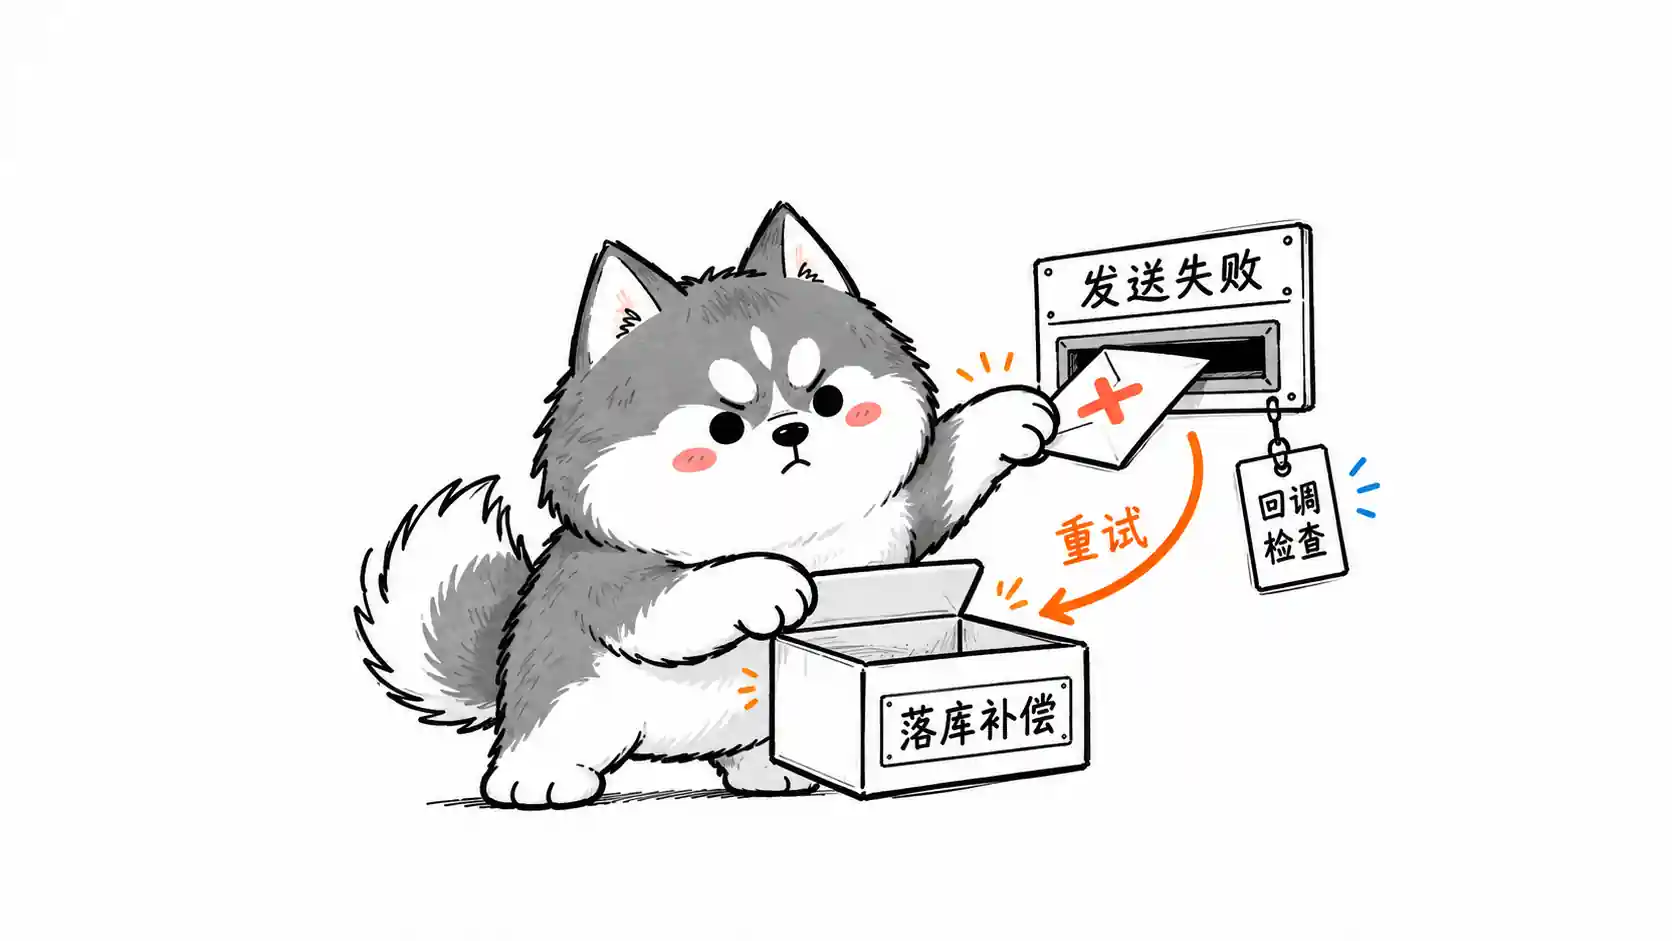
// 关键:用带回调的 send(),失败了你才知道!
producer.send(record, (metadata, exception) -> {
    if (exception != null) {
        // 重试也救不回来,落库或告警,人工兜底
        log.error("消息发送失败: {}", record, exception);
    }
});
这里有个很多新手栽过的坑:发后即忘。producer.send(record) 不加回调,消息发没发出去完全不知道,出了丢失连排查的抓手都没有。别问我怎么知道的,说多了都是泪。
另外说个版本细节:Kafka 3.0 之前 acks 默认值是 1,3.0 之后官方把默认值改成了 all,同时幂等默认开启。所以用新版本的同学,这块的默认兜底比以前强,但生产环境还是建议显式配置,别赌默认值。
三、Broker 端:副本机制兜底
Broker 端防丢失靠的是多副本,涉及三个参数:
1. replication.factor >= 3
每个分区至少 3 个副本。Kafka 官方的设计哲学是用多副本代替 RAID,单机磁盘坏了无所谓,只要不同副本分散在不同机器上,消息就还在。
2. min.insync.replicas >= 2
这个参数的意思是:ISR(In-Sync Replicas,同步副本集合)里至少要有 2 个副本,生产者才能写入成功。它就是给 acks=all 兜底的。ISR 缩水到只剩 1 个副本时,写入会直接抛 NotEnoughReplicasException,消息写不进去,但绝不会 “写进去了却是单副本” 这种危险状态。
写不进去怎么办?生产者会重试,等 ISR 恢复。业务侧感受到的是短暂不可用,换来的是消息不丢。这就是 CAP 里的取舍:宁可写失败,不可写丢。
3. unclean.leader.election.enable=false
字面意思是 “禁止不干净的 Leader 当选”。什么场景会用上?假设 ISR 里所有副本全挂了,只剩一个落后很多的 Follower(不在 ISR 里)。这个参数决定要不要让它当 Leader:
true:让它上位,牺牲一致性换可用性,但它落后的那些消息就永久丢了false(默认):宁可分区不可用,也不让落后的副本上位,消息不丢
防丢失场景下必须是 false,好消息是这个值从 0.11 版本开始默认就是 false 了。
这三个参数配下来的效果:消息至少同时存在于 2 个以上的副本里,单机宕机随便扛,机房级故障也有缓冲。
四、消费者端:offset 提交时机是关键
消费者端的丢失,九成九出在 offset 自动提交 上。
默认配置 enable.auto.commit=true 时,消费者每 5 秒(auto.commit.interval.ms)自动把拉到的最大 offset 提交上去。问题在于:提交 offset 和处理消息是两条线,自动提交根本不管你消息处理没处理完。
经典事故现场:消费者拉了 500 条消息,自动提交先走一步,offset 已经提交了;结果处理到第 200 条的时候消费者崩了。重启一拉,从 501 开始消费。前面没处理完的 300 条,就这么无声无息地丢了,日志里连个报错都没有。
正确姿势是关掉自动提交,处理完再手动提交:
Properties props = new Properties();
// 关闭自动提交
props.put(ConsumerConfig.ENABLE_AUTO_COMMIT_CONFIG, false);

KafkaConsumer<String, String> consumer = new KafkaConsumer<>(props);
consumer.subscribe(List.of("order-topic"));

while (true) {
    ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(500));
    for (ConsumerRecord<String, String> record : records) {
        // 先处理消息
        handleBusiness(record);
    }
    // 处理完全部消息后,再手动提交 offset
    consumer.commitSync();
}
顺序就一句话:先消费,后提交。处理失败的消息不提交 offset,下次 poll 还能拉到,最多是重复消费,不会再丢。
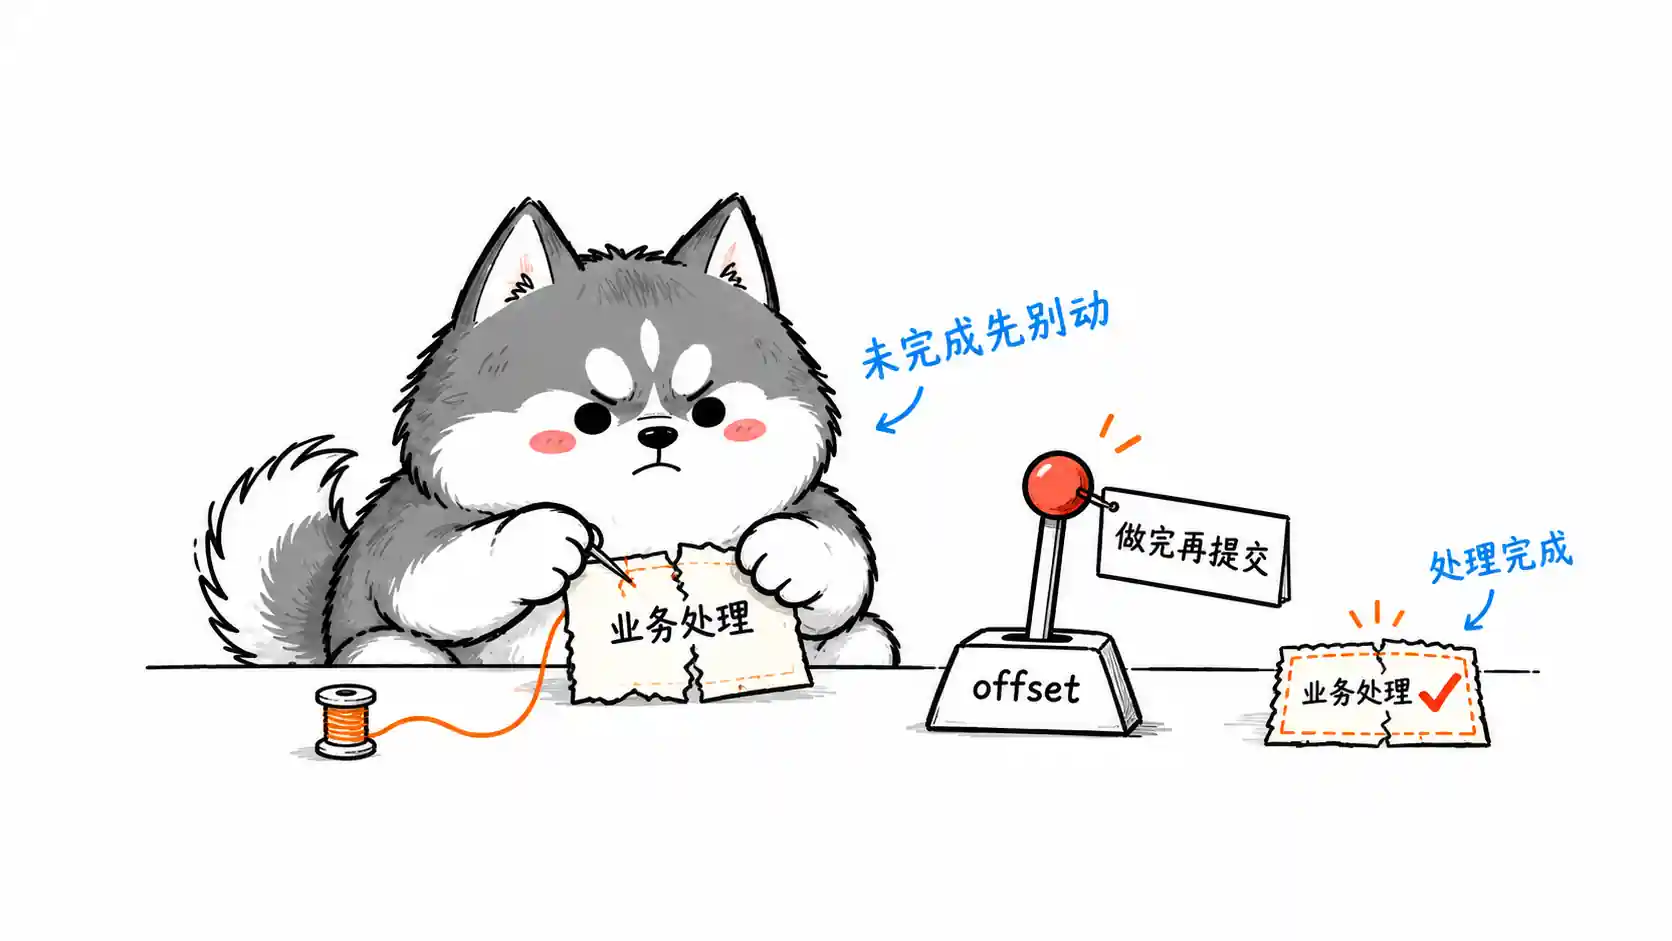
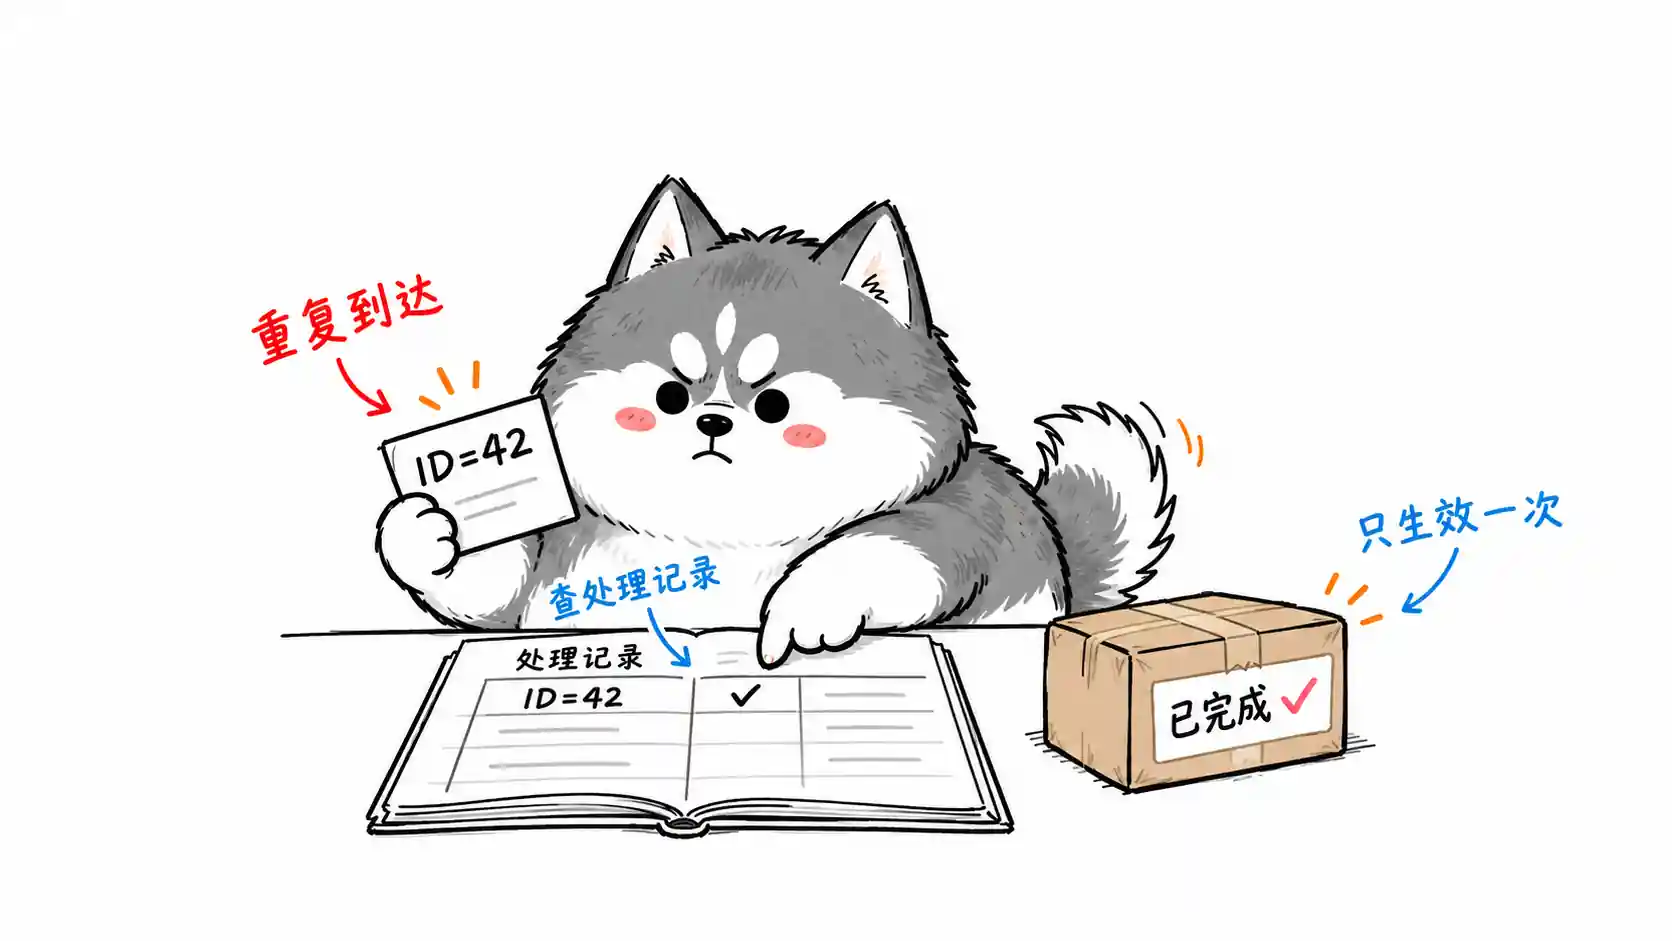
顺便提一句,重复消费是防丢失的另一面,offset 提交失败、消费者重启,都可能把处理过的消息再拉一遍。所以工程上经常说 “至少一次(At Least Once)+ 消费端幂等” 才是生产可用的组合,靠数据库唯一键或者 Redis 记录已处理的消息 ID 都行。
面试高频追问
-
追问一:
acks=all就一定不丢消息吗?不一定。如果 ISR 里只剩 Leader 一个副本,
acks=all就退化成acks=1。必须配min.insync.replicas>=2才能堵住这个漏洞。另外retries拉满也救不了死信,重试超时后要把失败消息落库人工介入,才算把兜底做完整。 -
追问二:消息不丢和消息不重复,能同时保证吗?
这就是 Exactly-Once 问题。Kafka 0.11 之后靠幂等生产者(
enable.idempotence=true)+ 事务可以做到端到端的精确一次,但有性能开销,而且要求消费端也在事务里read_committed。大部分业务场景还是选 At Least Once + 消费端幂等,成本低得多。 -
追问三:怎么保证消息的顺序?
把需要有序的消息发到同一个分区(按业务 key 路由),单分区内天然有序。但注意如果
max.in.flight.requests.per.connection > 1且没开幂等,重试可能导致乱序,开了幂等之后,Kafka 能保证重试也不会把顺序打乱。 -
追问四:消息积压了怎么处理?
快速扩容消费者(消费者数量不能超过分区数),或者新建一个分区数更多的主题,写个临时分发程序把积压消息搬运过去再消费。
常见面试变体
- “Kafka 的 ISR 机制是什么?和
acks=all什么关系?” - “
min.insync.replicas和replication.factor是什么关系?” - “生产环境你们 Kafka 的防丢失是怎么配的?”(考察真实实践)
- “Kafka 为什么快?”(常和本题连着问)
记忆口诀
三端三手:生产者 acks=all 加重试,Broker 三副本加双同步,消费者手动提交别偷懒。
再压缩一下就是九个字:发得稳、存得牢、提得晚。
总结
一句话:消息不丢 = 生产端 acks=all + 重试 + 回调兜底,Broker 端 replication.factor>=3 + min.insync.replicas>=2 + 禁止脏选举,消费端关自动提交、先消费后提交。把三个环节的丢失场景讲清楚,再抛出 “不丢的代价是可能重复,所以还要消费端幂等” 这一句,这道题基本就答出深度了。