介绍一下 Kafka 的 ISR 机制?
一则或许对你有用的小广告
欢迎加入小哈的星球,你将获得:专属的实战项目(4个项目都能学) / 1v1 提问 / 简历修改 / Java 学习路线 / 社群讨论 / 学习打卡 / 每月赠书
《Spring AI 项目实战(问答机器人、RAG 智能客服、联网搜索)》已完结,基于
Spring AI + Spring Boot 3.x + JDK 21...,查看介绍《从零手撸:仿小红书(微服务架构)》 已完结,基于
Spring Cloud Alibaba + Spring Boot 3.x + JDK 17...,查看介绍;演示链接:http://116.62.199.48:7070/《从零手撸:前后端分离博客项目(全栈开发)》 2 期已完结,演示链接:http://116.62.199.48/
新开坑项目:《从零手撸:秒杀系统高并发优化实战》 正在更新中...,查看介绍
截止目前,星球内专栏累计输出 150w+ 字,讲解图 5110+ 张,还在持续爆肝中.. 后续还会上新更多项目,已有 4700+ 小伙伴加入学习,欢迎点击围观
面试考察点
-
基础掌握度:面试官想考的不只是你能不能把 ISR 三个字母展开,更要看你说不说得清楚 AR、ISR、OSR 之间的关系,以及 ISR 里到底装了哪些副本。
-
原理理解深度:ISR 这份名单不是写死的,一直在动态变化。副本什么时候被踢出去、什么时候加回来,背后的判定条件是什么,这才是拉开差距的地方。
-
架构权衡思维:ISR 本质是 Kafka 在性能和数据可靠性之间找的折中点。能不能讲明白 “为什么不等所有副本确认” 和 “选主为什么只从 ISR 里挑”,决定了你是 “用过 Kafka” 还是 “懂 Kafka”。
核心答案
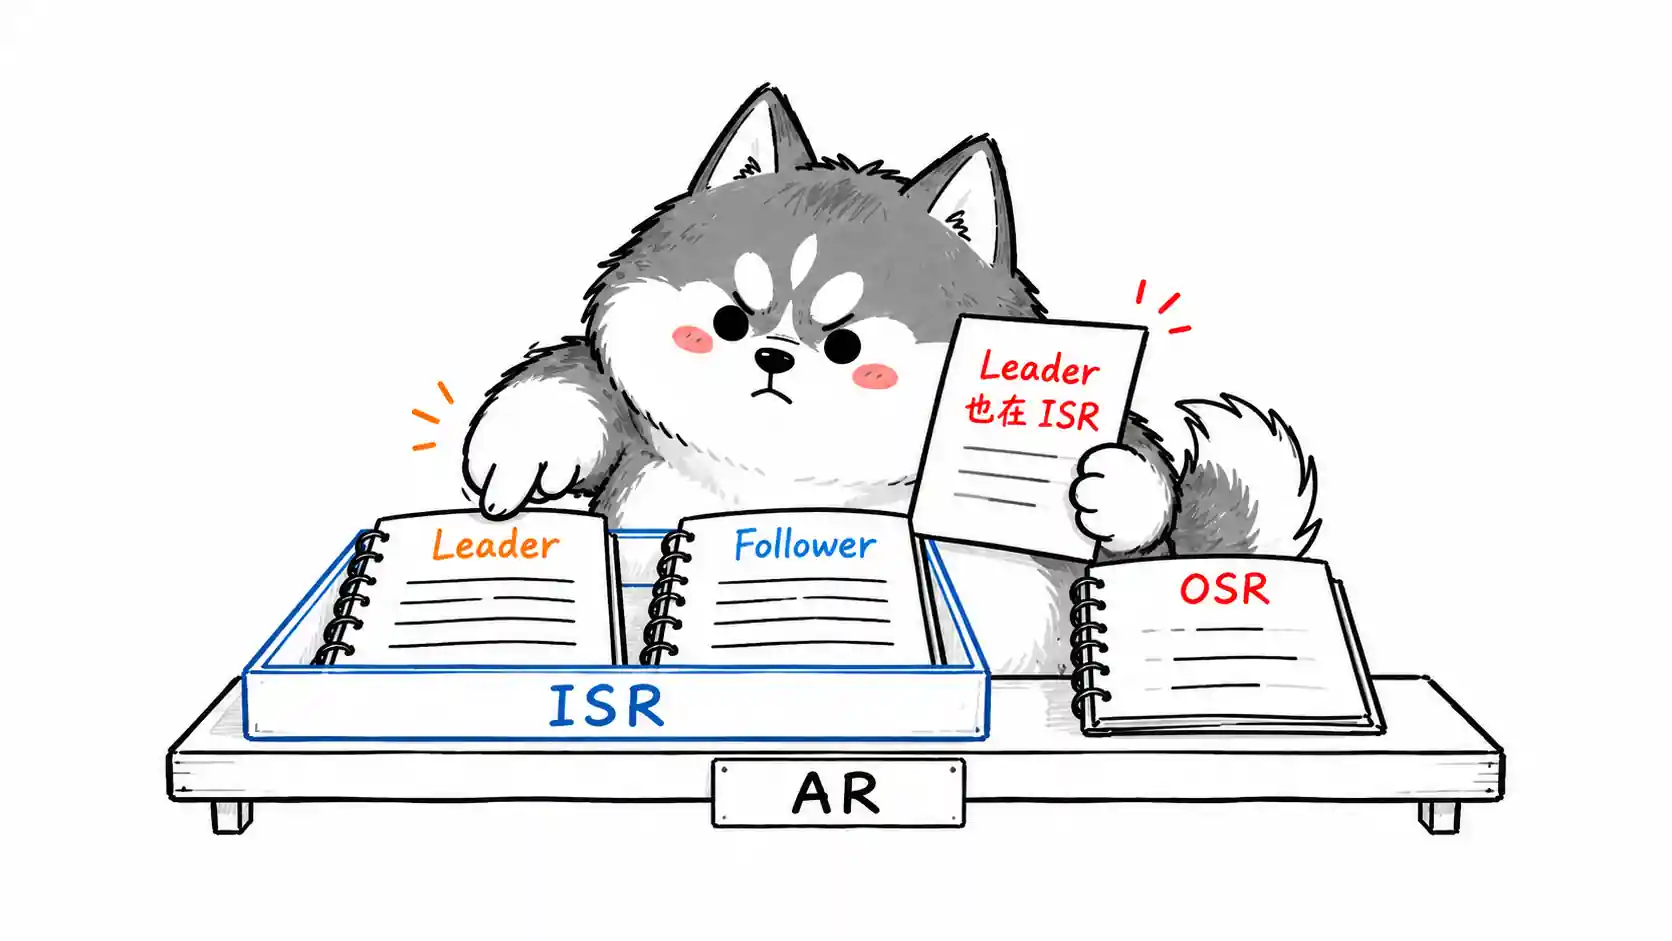
ISR(In-Sync Replicas,同步副本列表)指的是一个分区里与 leader 保持同步的副本集合,注意 leader 自己也在 ISR 里。
先看三兄弟的关系,一张表说清:
| 概念 | 全称 | 含义 |
|---|---|---|
| AR | Assigned Replicas | 分区的全部副本 |
| ISR | In-Sync Replicas | 与 leader 保持同步的副本集合(含 leader) |
| OSR | Out-of-Sync Replicas | 落后太多、被移出同步名单的副本 |
一句话:AR = ISR + OSR。
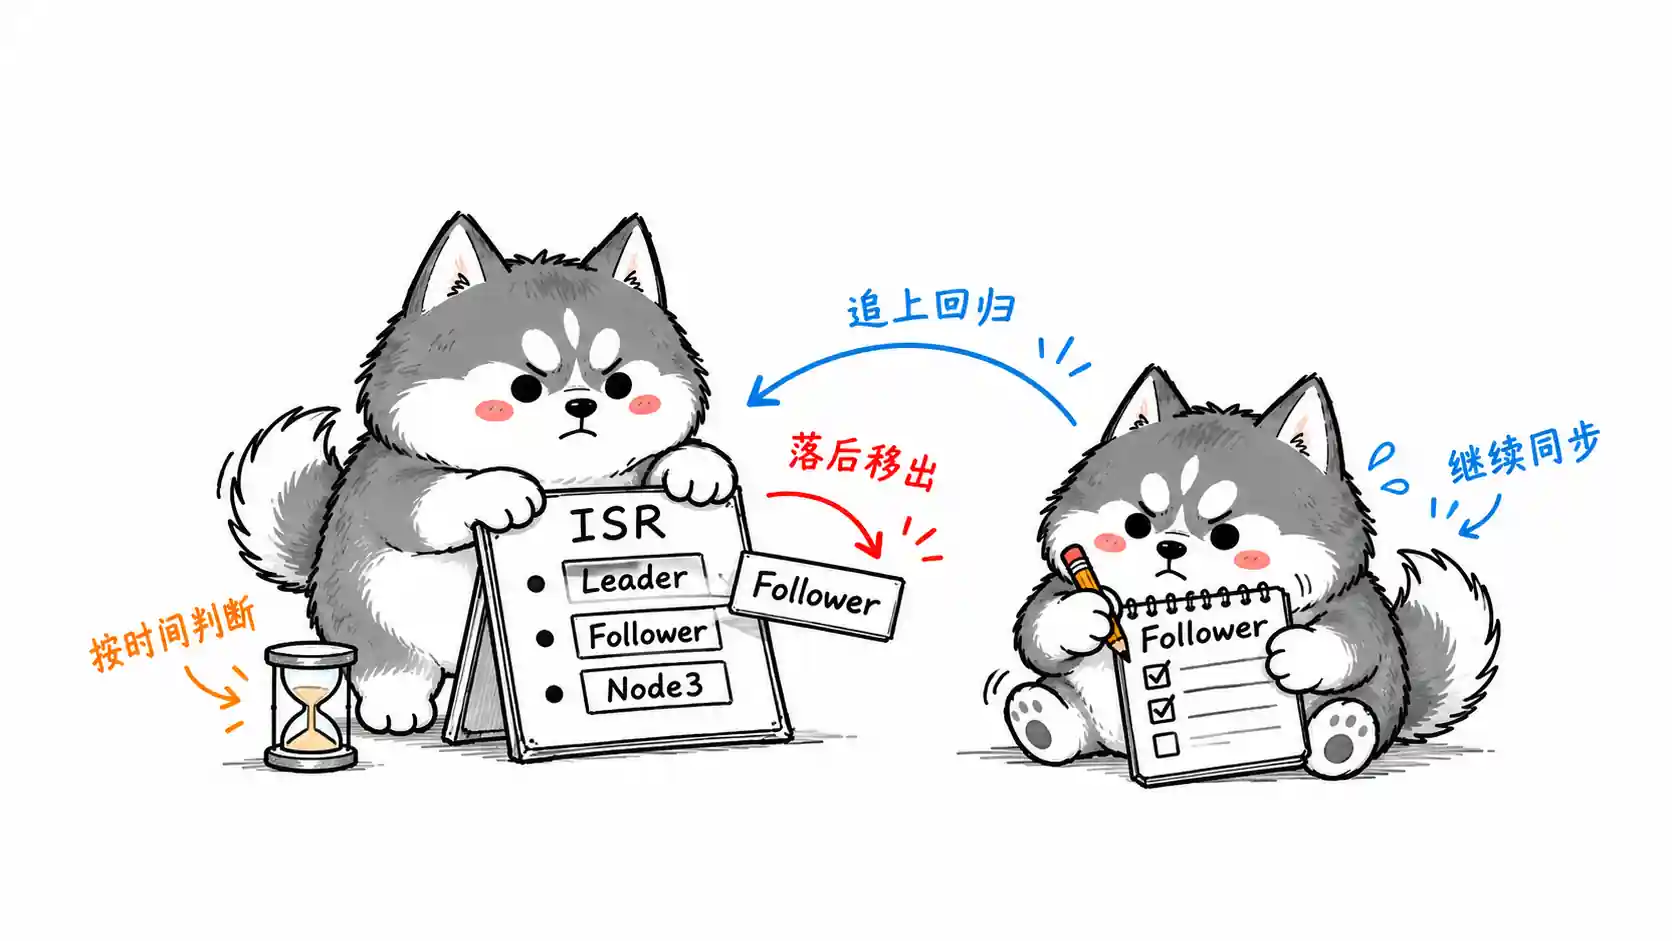
ISR 机制用大白话讲就是:跟得上的留在名单里,跟不上的踢出去,追上了再拉回来。它主要管两件事:
- 消息什么时候算写成功:
acks=all时,ISR 内所有副本都写入就算成功,不用干等每一个副本(包括掉队的那些) - leader 挂了谁接班:新 leader 只从 ISR 里选,保证接班的人手里数据最全
深度解析
一、ISR 是动态的:收缩与扩张
先看图:
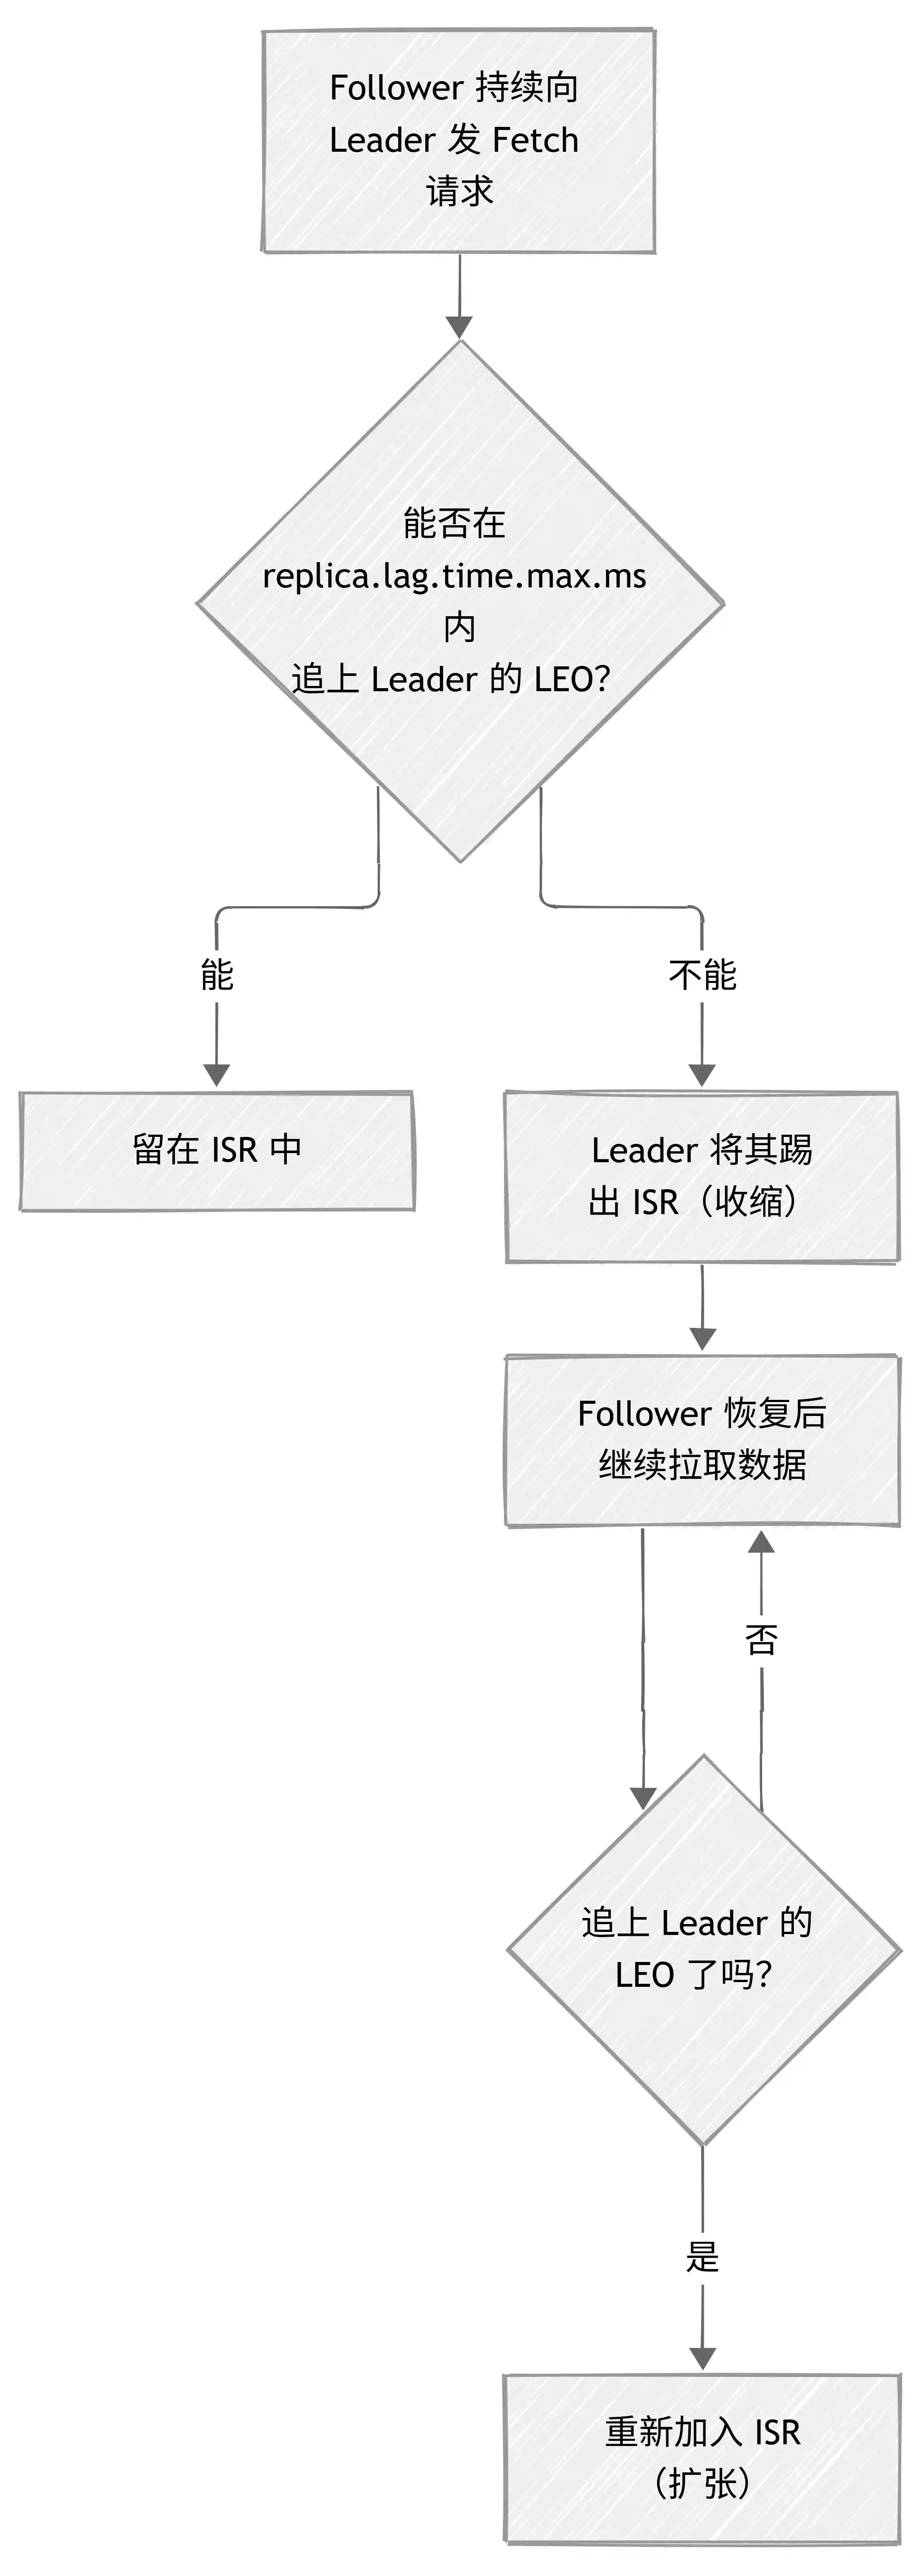
图里这条逻辑线的关键,全在 replica.lag.time.max.ms 这个参数上:
- 判定标准是时间,不是条数:follower 只要在这个时间窗口内(默认 30 秒,Kafka 2.5 之前是 10 秒)追上 leader 的日志末端,就算 “同步中”;超过这个时间还没追上,leader 所在的 broker 就把它从 ISR 里移出去
- 踢出去不是永久的:OSR 里的副本恢复后接着追,一旦追上 leader 的 LEO,就重新被加回 ISR,这就是 ISR 扩张
- 判定由 leader 主导:leader 记录着每个 follower 最近一次 fetch 的时间和位移,踢不踢人它说了算
这里有个历史小知识可以当加分项:Kafka 0.9 之前还有个 replica.lag.max.messages 参数,按落后消息条数判定(0.8 里默认落后 4000 条就踢)。后来发现流量一突增,正常的 follower 也会被误判踢出,ISR 抖来抖去,所以 0.9 之后干脆把条数判定删了,只留时间判定。这段演进在面试里说出来,面试官会知道你真研究过。
二、ISR 背后的两个关键概念:LEO 和 HW
聊 ISR 绕不开 LEO 和 HW 这对搭档,不然很多机制串不起来。
- LEO(Log End Offset):每个副本日志下一条待写入消息的位移,通俗讲就是日志写到哪了
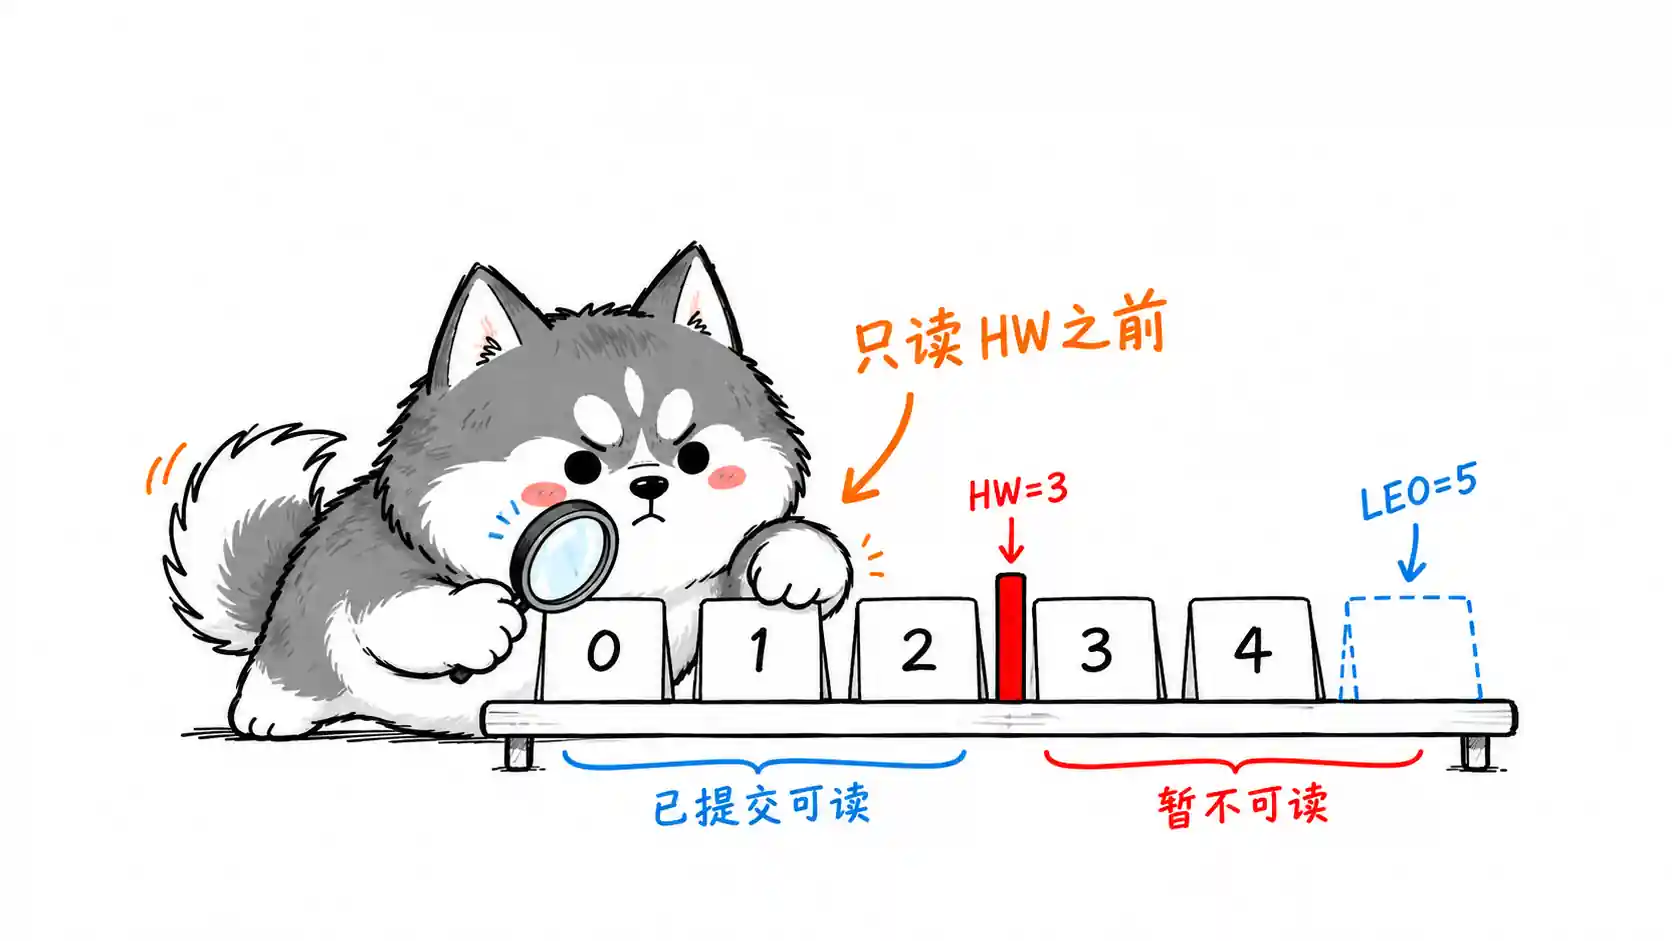
- HW(High Watermark,高水位):ISR 中所有副本 LEO 的最小值。消费者只能消费 HW 之前的消息,因为只有这部分才被 ISR 全员确认过
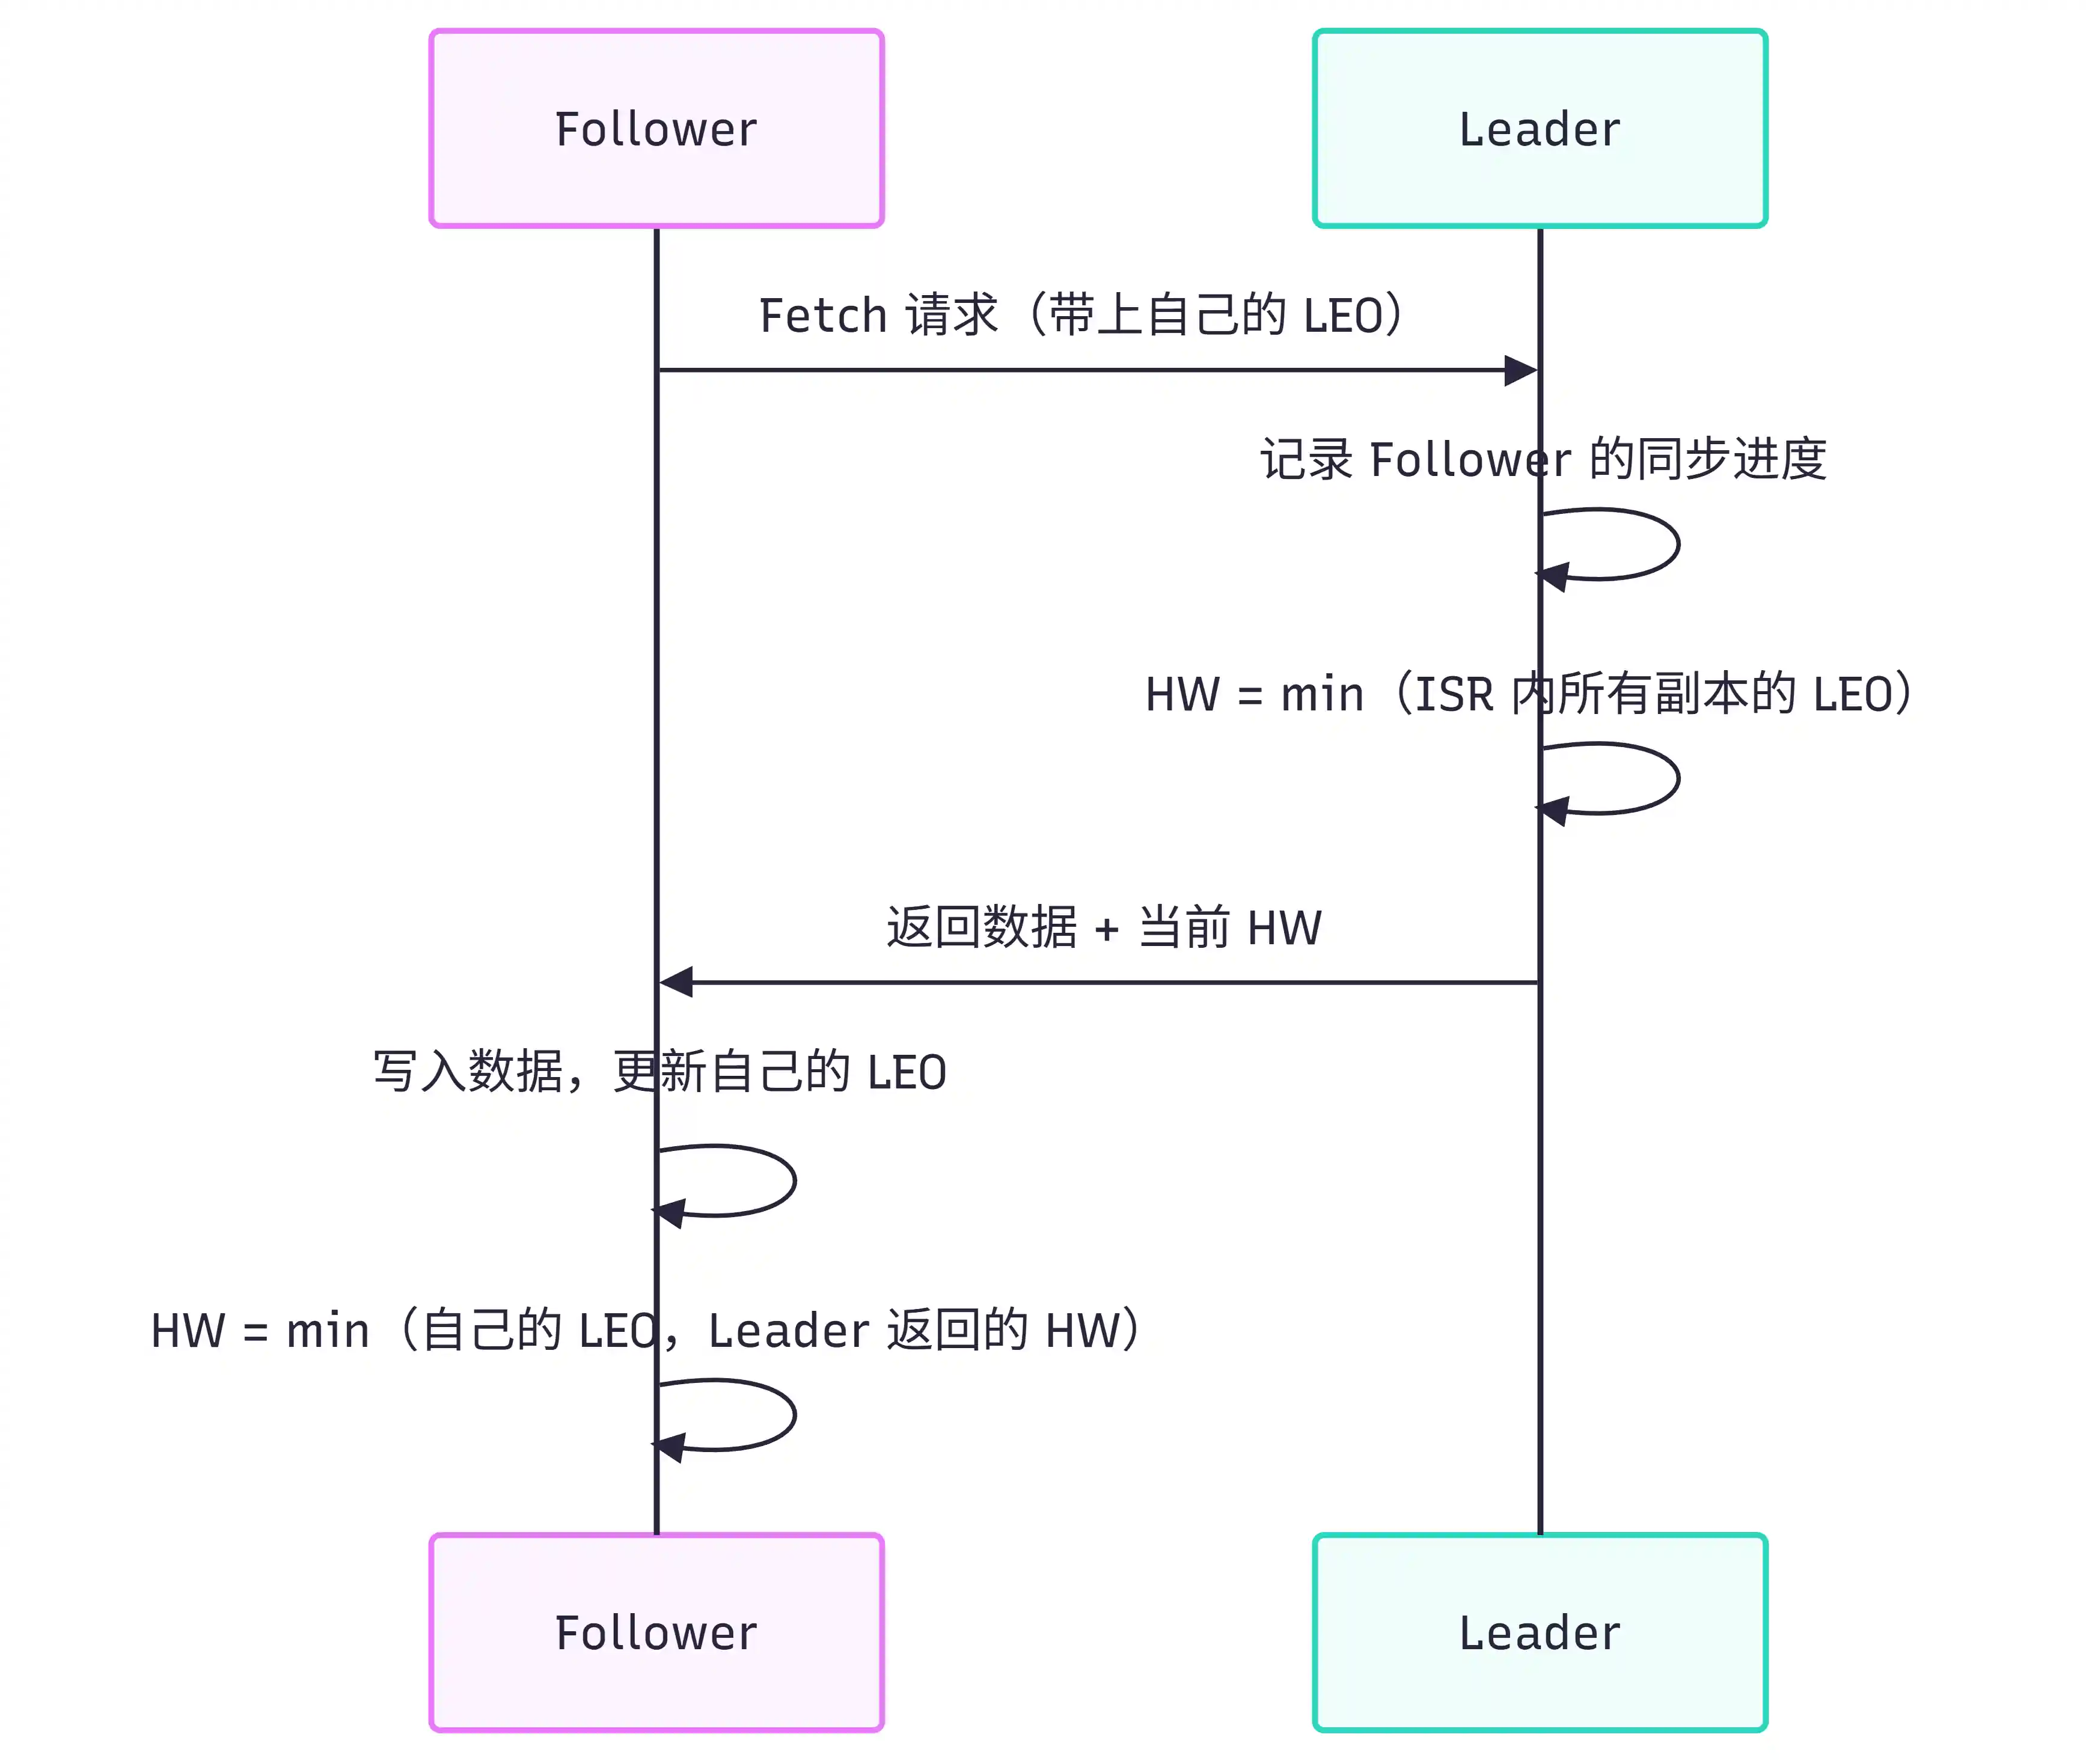
对着图捋一遍:
- follower 每次 fetch 都会把自己的 LEO 告诉 leader,leader 借此掌握每个副本的进度
- leader 取 ISR 里最小的 LEO 当 HW,意思是 “这个位置之前的消息,ISR 全员都写完了”
- follower 拿到 leader 返回的 HW 后,和自己 LEO 取最小,同步自己的 HW
为什么要搞出 HW 这个东西?因为它就是 “已提交” 和 “未提交” 的分界线。所以有时生产者刚发完消息,消费者立刻去读却读不到,消息大概率还在 HW 之后,得等 ISR 全员跟上才能被看见。
这里还有个深水区:老版本的 HW 更新机制在 leader 切换时可能丢数据,或者让副本数据错乱。Kafka 0.11 引入 Leader Epoch 修复了这个问题,副本切主时不再盲目按 HW 截断日志。面试被追问到再展开,平时记住有这回事就行。
三、ISR 撑起了 Kafka 的消息可靠性
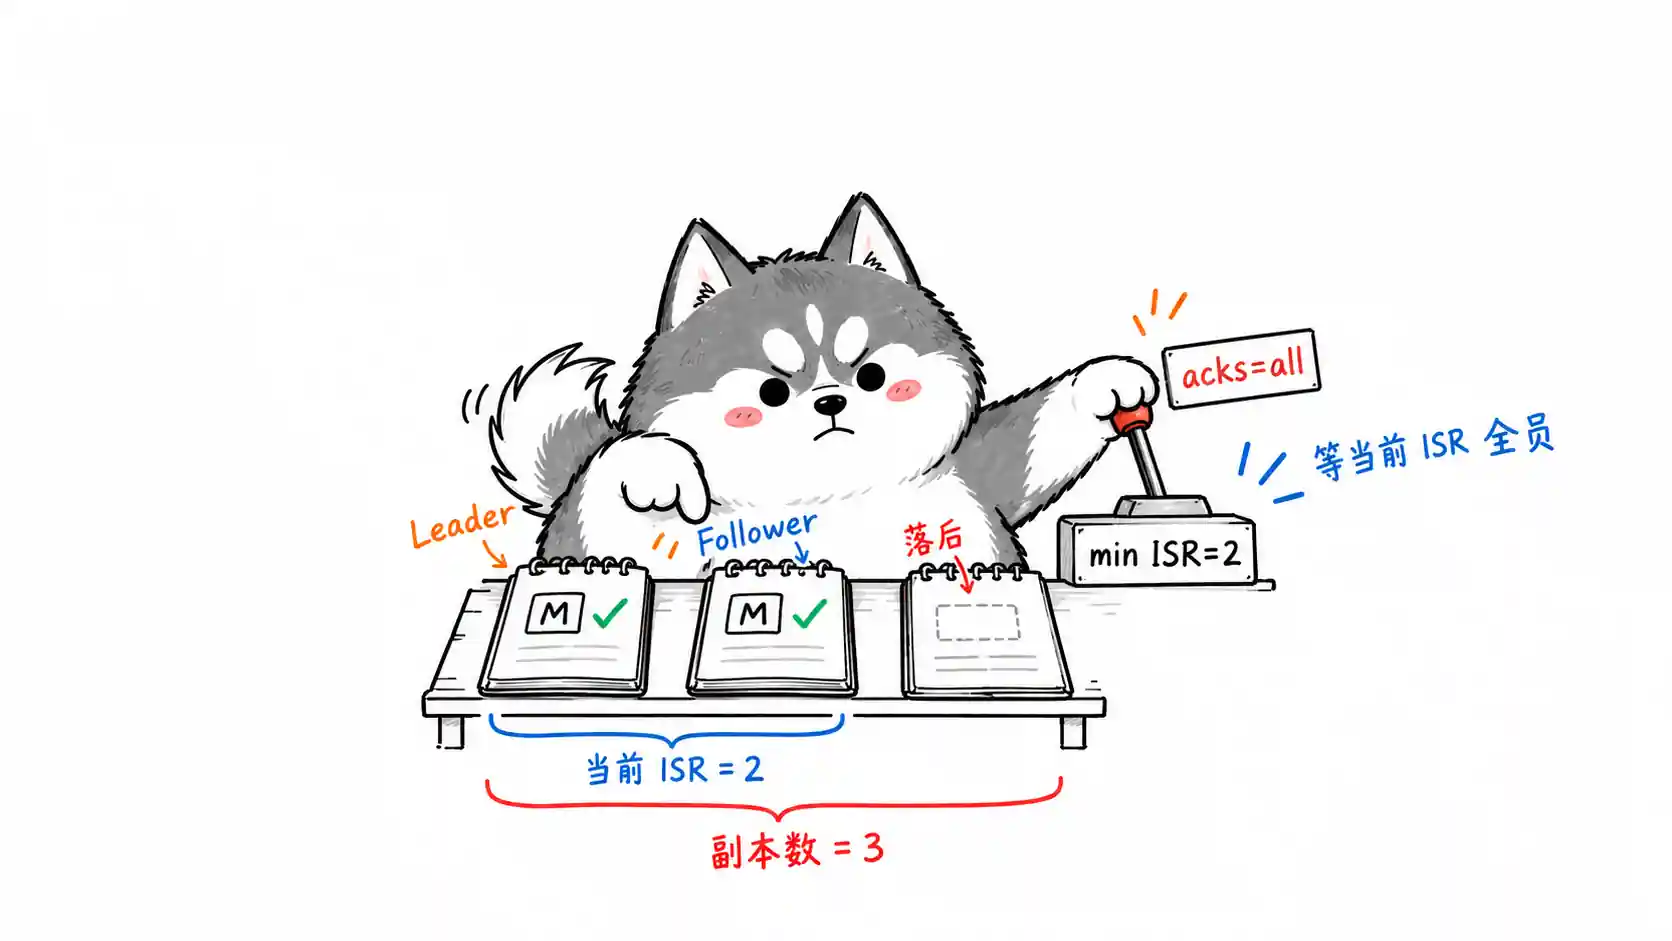
ISR 不是个孤立概念,它跟生产端配置是一套组合拳。生产环境追求 “不丢消息” 的铁三角长这样:
Properties props = new Properties();
// acks=all:ISR 内所有副本确认,才算写入成功
props.put(ProducerConfig.ACKS_CONFIG, "all");
// 发送失败自动重试
props.put(ProducerConfig.RETRIES_CONFIG, Integer.MAX_VALUE);
// 本地配置好序列化器、broker 地址,这里省略
# 创建 topic:3 副本,ISR 至少 2 个才允许写入
kafka-topics.sh --create --topic order-topic \
  --partitions 6 \
  --replication-factor 3 \
  --config min.insync.replicas=2
三个配置咬合在一起的逻辑是:
replication.factor=3:每个分区 3 个副本,物理上兜底min.insync.replicas=2:ISR 里至少得有 2 个副本,否则拒绝写入,生产者会收到NotEnoughReplicasExceptionacks=all:消息要等 ISR 内全部副本都写入才返回成功
这里有个特别常见的误区:很多人以为 acks=all 就万事大吉、绝不丢消息了。不对。如果 ISR 收缩到只剩 leader 一个,而 min.insync.replicas 又是默认的 1,那 acks=all 实际上就退化成了 acks=1,leader 刚确认完就宕机,消息照样丢。所以铁三角必须配齐,少一个都不行。这块当年真坑过不少团队,丢了消息还一脸懵。
四、leader 选举为什么只认 ISR
leader 宕机后,Controller 会从 ISR 里挑一个副本当新 leader。因为 ISR 里的副本数据最全,从里面选主,已提交的消息一条都不会丢。
那如果 ISR 全军覆没了呢?这就轮到 unclean.leader.election.enable 出场:
false(0.11 之后的默认值):宁可让分区暂时不可用,也不让落后副本上位,数据不丢,牺牲可用性true:允许 OSR 里的副本当 leader,保住可用性,但落后的那段消息就永久丢了
0.11 之前这个参数默认还是 true,后来社区觉得丢数据的代价更大,把默认值改成了 false。典型的 CAP 取舍:一致性还是可用性,按业务自己挑。
面试高频追问
replica.lag.time.max.ms默认多少?怎么调?
默认 30 秒(Kafka 2.5 之前是 10 秒,当年 broker 一场 GC 停顿就把正常 follower 踢出 ISR,社区这才把默认值调大)。调小的话,落后副本更快被踢出,acks=all 的延迟更可控;调大的话,ISR 更稳定,但落后副本会拖住 acks=all 的确认速度。有频繁网络抖动的集群适当调大,能减少 ISR 抖动。
acks=all就一定不丢消息吗?
不一定。要配合 min.insync.replicas >= 2 和 replication.factor >= 3。ISR 收缩到 1 时,acks=all 会退化。另外多说一句,Kafka 3.0 之后生产者的默认 acks 已经从 1 改成 all 了。
- 消费者能消费到 LEO 吗?
不能,最多到 HW。LEO 减 HW 的那部分是还没被 ISR 全员确认的 “未提交” 消息。
- ISR 信息存在哪?
老版本存在 ZooKeeper 的 /brokers/topics/<topic>/partitions/<partition>/state 节点;KRaft 模式下改为记录在集群元数据日志里,Kafka 4.0 已经彻底移除 ZooKeeper。
- 为什么 Kafka 数据同步不用多数派投票?
ISR 方案等待的是当前 ISR 的确认,慢副本先踢出去再继续写,不会被最慢的副本拖死;而且能容忍的故障副本数不受 “过半” 的硬限制,可以通过 min.insync.replicas 灵活配置。ZooKeeper 那种多数派适合元数据场景,数据量小、强一致要求高。顺带一提,KRaft 的元数据管理用的恰恰就是 Raft 多数派,元数据和数据是两码事。
常见面试变体
- “Kafka 的 HW 和 LEO 是什么?”
- “
acks=0、acks=1、acks=all的区别?” - “Kafka 怎么保证分区副本的数据同步?”
- “什么是 Unclean Leader Election?什么时候开?”
记忆口诀
ISR 一句话:跟得上的留下,跟不上的踢走,追上了再回来。
可靠性铁三角:三副本、最少俩、acks=all(replication.factor=3 + min.insync.replicas=2 + acks=all)。
总结
ISR 就是 Kafka 在 “等所有副本太慢” 和 “只写 leader 易丢” 之间找的那个平衡点:用 replica.lag.time.max.ms 动态筛出靠谱副本,acks=all 只等这批人,选主也只从这批人里挑。把 ISR 收缩扩张、HW/LEO、可靠性铁三角这条线讲顺,这道题基本就稳了。