Kafka 有几种选举过程?
一则或许对你有用的小广告
欢迎加入小哈的星球,你将获得:专属的实战项目(4个项目都能学) / 1v1 提问 / 简历修改 / Java 学习路线 / 社群讨论 / 学习打卡 / 每月赠书
《Spring AI 项目实战(问答机器人、RAG 智能客服、联网搜索)》已完结,基于
Spring AI + Spring Boot 3.x + JDK 21...,查看介绍《从零手撸:仿小红书(微服务架构)》 已完结,基于
Spring Cloud Alibaba + Spring Boot 3.x + JDK 17...,查看介绍;演示链接:http://116.62.199.48:7070/《从零手撸:前后端分离博客项目(全栈开发)》 2 期已完结,演示链接:http://116.62.199.48/
新开坑项目:《从零手撸:秒杀系统高并发优化实战》 正在更新中...,查看介绍
截止目前,星球内专栏累计输出 150w+ 字,讲解图 5110+ 张,还在持续爆肝中.. 后续还会上新更多项目,已有 4700+ 小伙伴加入学习,欢迎点击围观
面试考察点
-
体系化掌握:分区副本怎么选 Leader 只是基本盘,面试官更想看你脑子里有没有一张全局图——Kafka 里至少有三类选举(Controller、Partition Leader、Consumer Leader),答不全说明对架构的理解是碎片的。
-
原理深度:ZooKeeper 模式怎么选 Controller?KRaft 模式又怎么选?ISR 是什么?unclean 选举为什么可能丢数据?这些追问环环相扣,一问就见底。
-
生产意识:选举不是纸上谈兵——Broker 宕机后集群多久恢复、
unclean.leader.election.enable开了会怎样、脑裂怎么防,这些全是线上真踩过的坑。
核心答案
先说结论:Kafka 里主要有 三种选举:
| 选举类型 | 选出什么 | 谁来组织 | 核心机制 |
|---|---|---|---|
| Controller 选举 | 集群的 “大管家” Broker | ZK 模式:ZooKeeper;KRaft 模式:Raft 协议 | 先到先得 / 多数派投票 |
| Partition Leader 选举 | 每个分区的主副本 | Controller | 从 ISR 中选,优先第一个副本 |
| Consumer Leader 选举 | 消费组的 “组长” 消费者 | GroupCoordinator | 第一个加入组的消费者 |
下面一个一个拆开讲。
深度解析
一、Controller 选举:抢椅子游戏
Controller 是整个集群的大管家,负责分区 Leader 选举、故障转移、元数据管理这些活儿。一个集群只能有一个 Controller,那谁来当?这就涉及两种模式的演进了。
老模式:依赖 ZooKeeper(Kafka 2.8 之前)
所有 Broker 启动时都会去 ZooKeeper 的 /controller 节点上抢着注册——谁先创建成功,谁就是 Controller,输家们就监听这个节点。
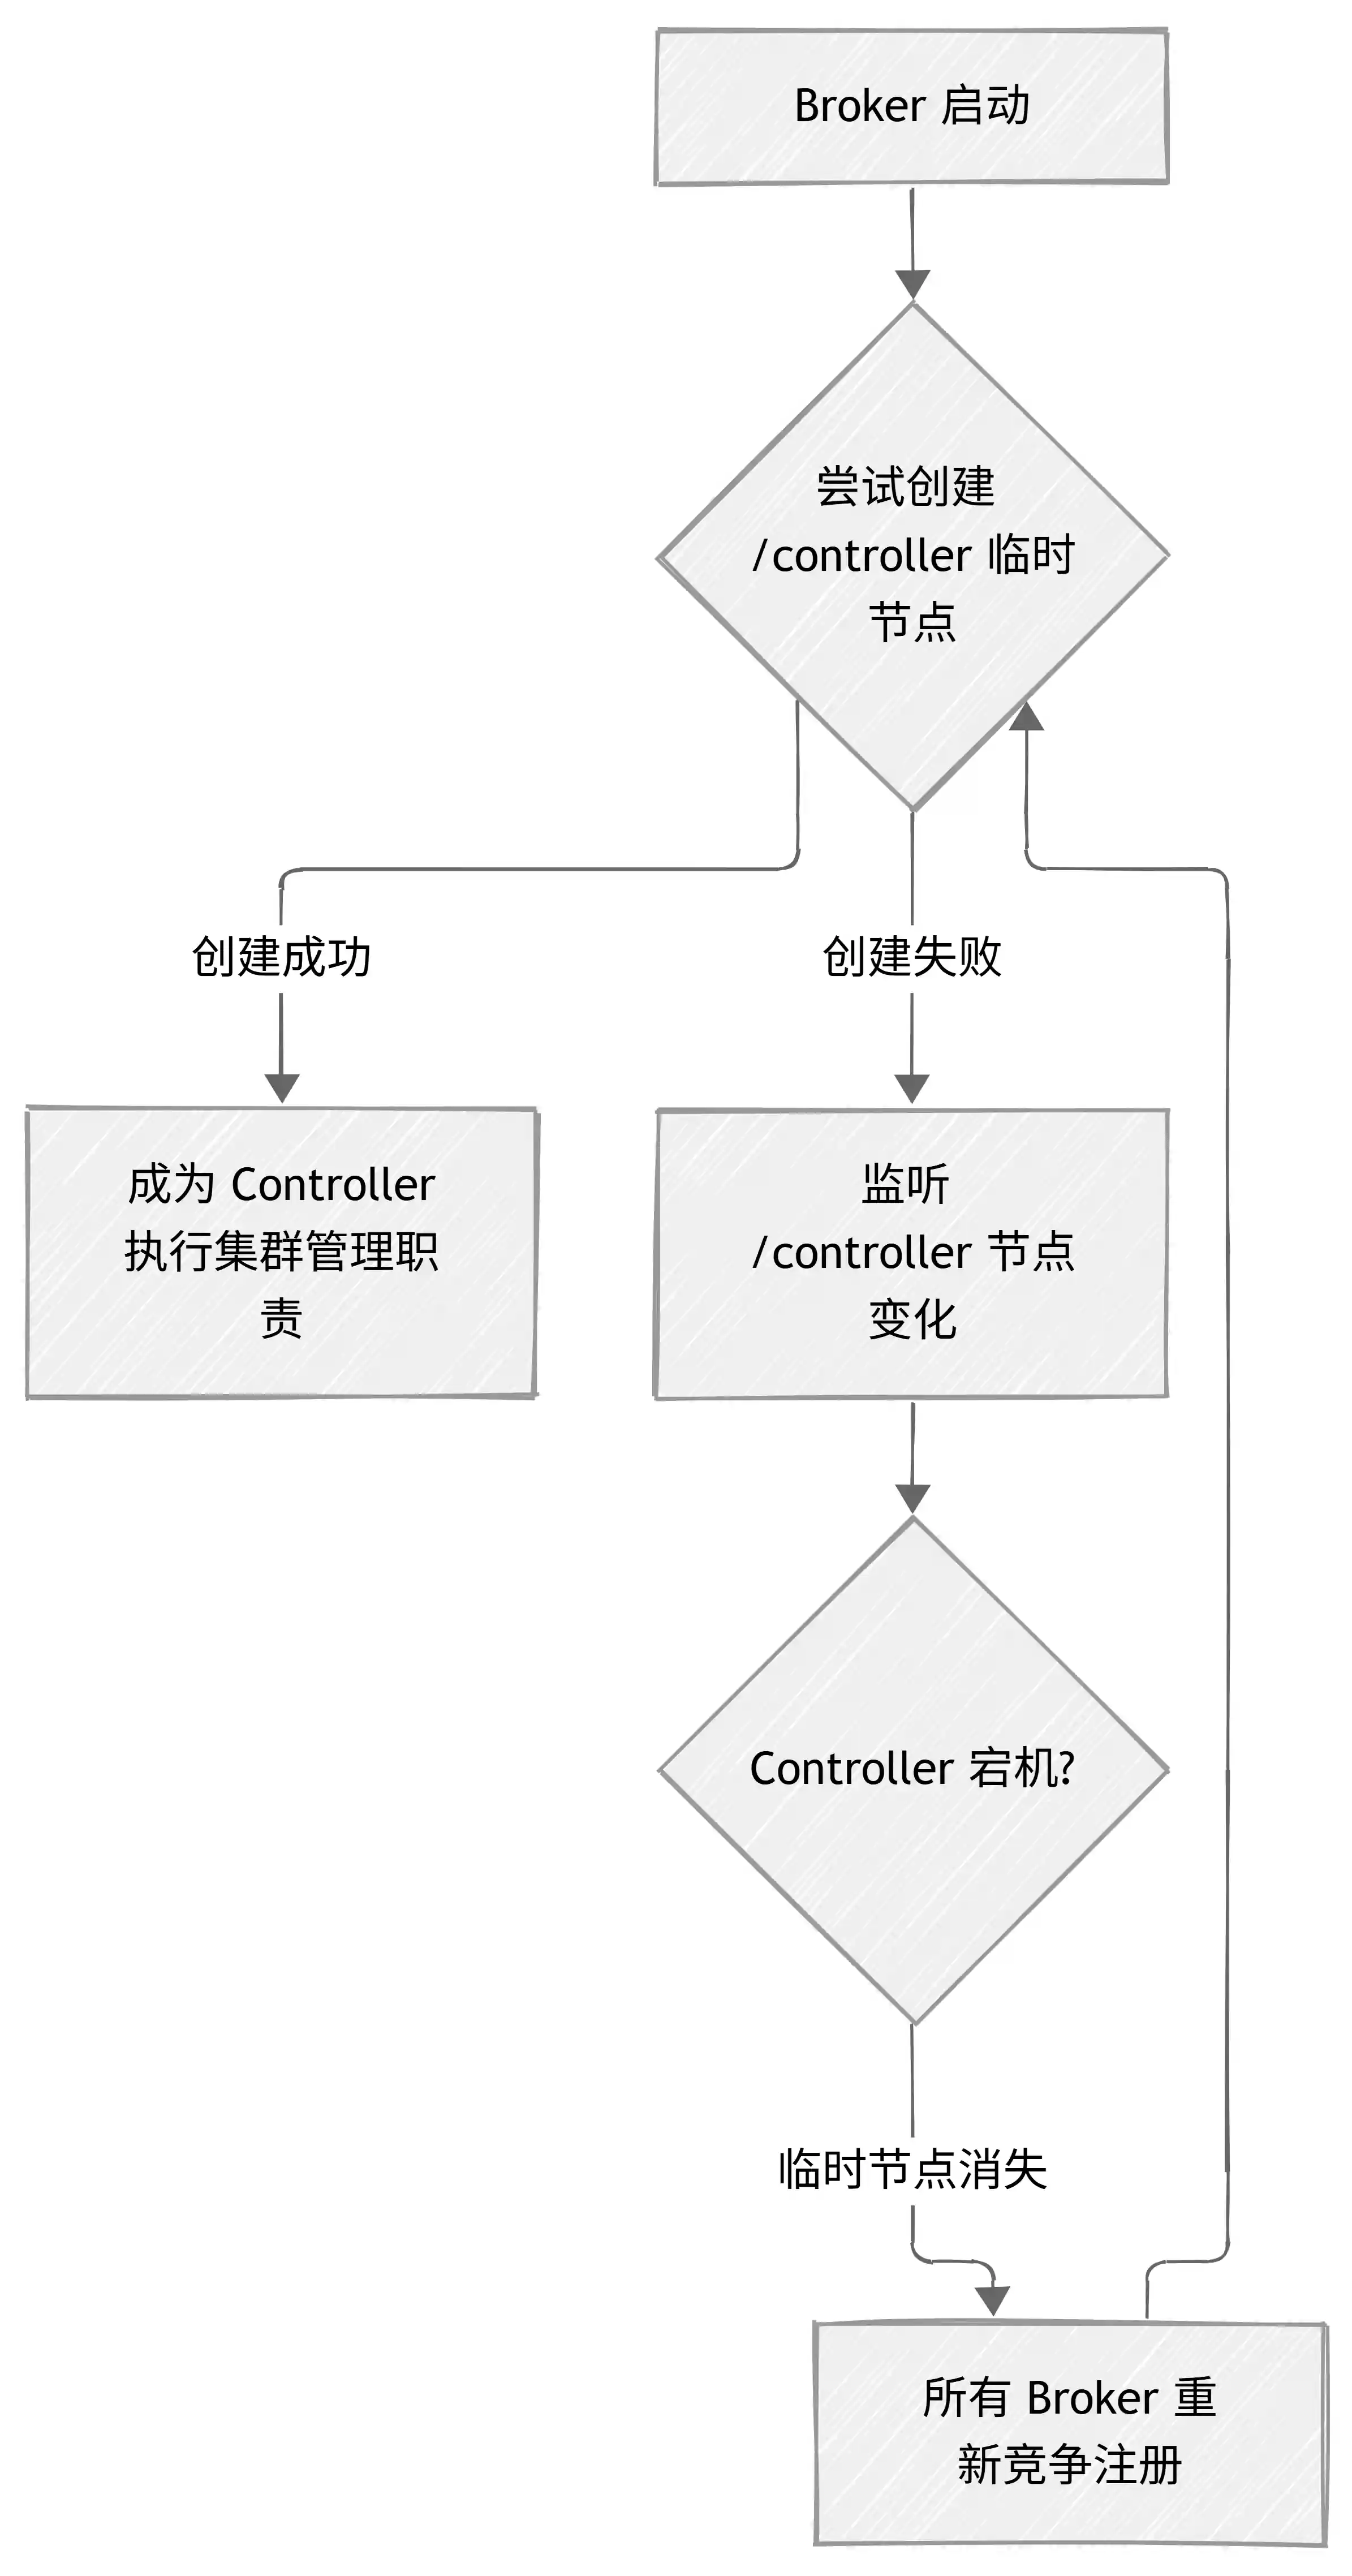
上图就是 ZK 模式下的 Controller 选举与故障转移,几个关键点:
- 先到先得:本质是抢分布式锁,谁的注册请求先落到 ZooKeeper,谁赢
- 临时节点:Controller 所在 Broker 宕机后,ZooKeeper 会话失效,临时节点自动删除
- 故障转移:其他 Broker 监听到节点被删,立刻重新发起竞争,新 Controller 上位后会把元数据缓存和 Leader 分配全部重算一遍
新模式:KRaft(Kafka 2.8 引入,3.3 生产可用)
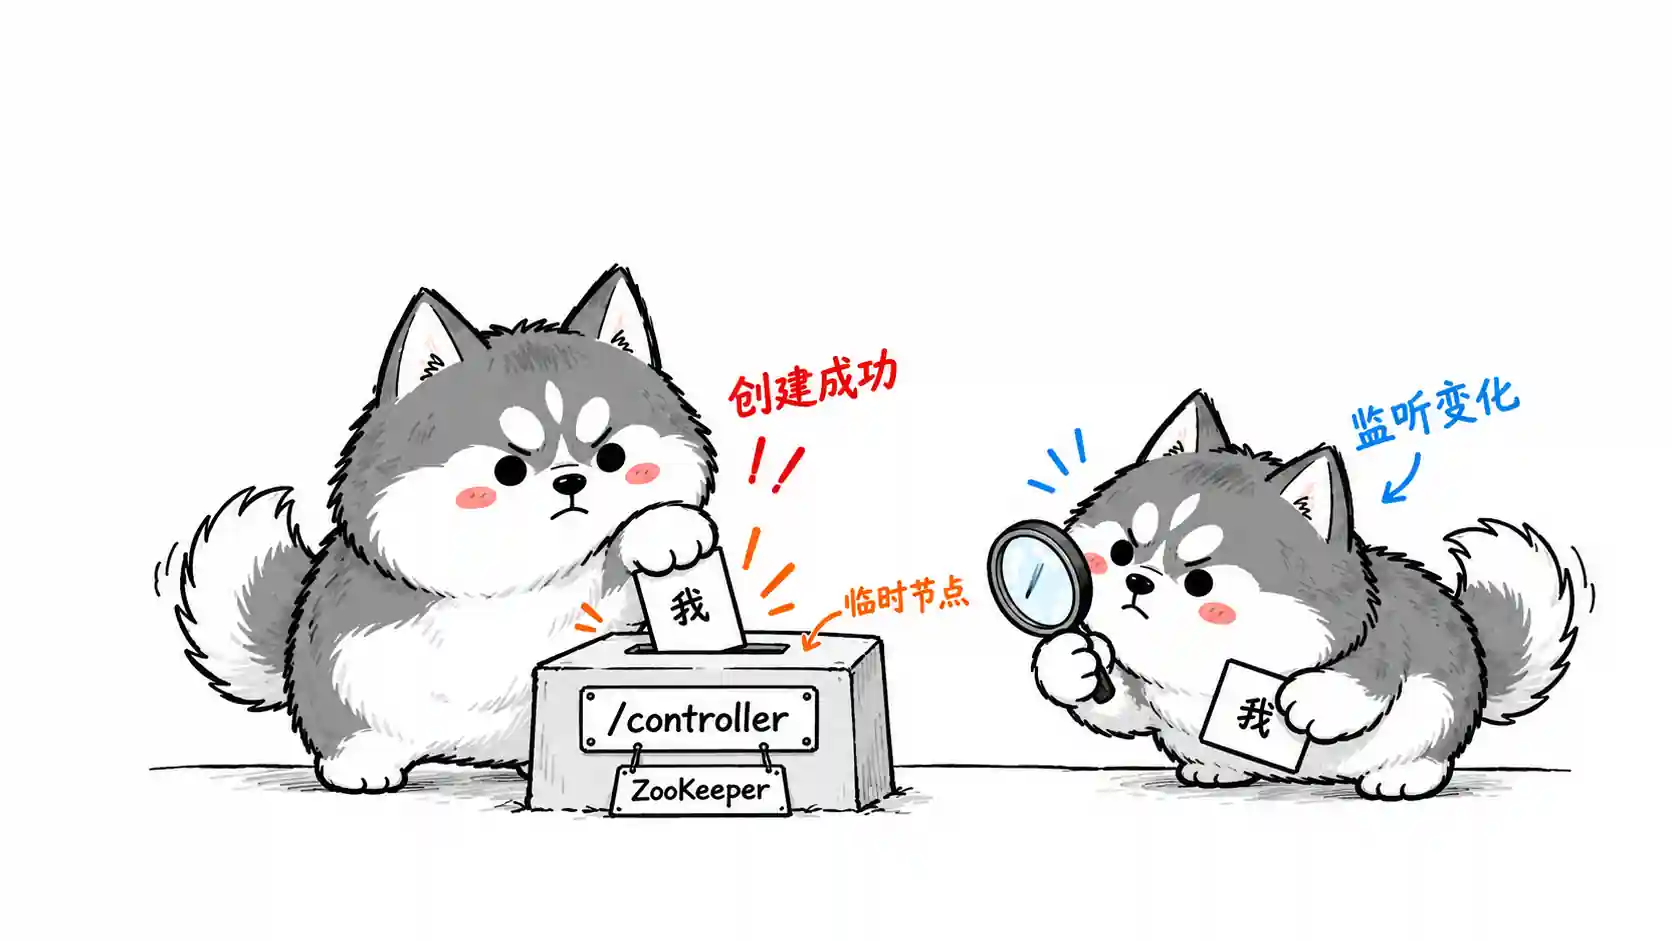
Kafka 后来把 ZooKeeper 扔了,改用内置的 KRaft 模式(KRaft = Kafka Raft)。Controller 选举不再依赖外部,而是用 Raft 协议自己选:
- 一组 Controller 节点组成仲裁队列(quorum),通常 3 个或 5 个
- 每个节点都能发起拉票,Candidate 状态下向其他节点要投票
- 拿到多数派选票即成为 Leader,比如 3 个节点拿 2 票就赢
- 日志最新(term 和 log 都匹配)的节点更容易当选,保证新 Leader 拥有最全的元数据
到 Kafka 4.0,ZooKeeper 被彻底移除,KRaft 成为唯一模式。这个演进本身也是面试常见追问,后面细说。
二、Partition Leader 选举:从 ISR 里挑人
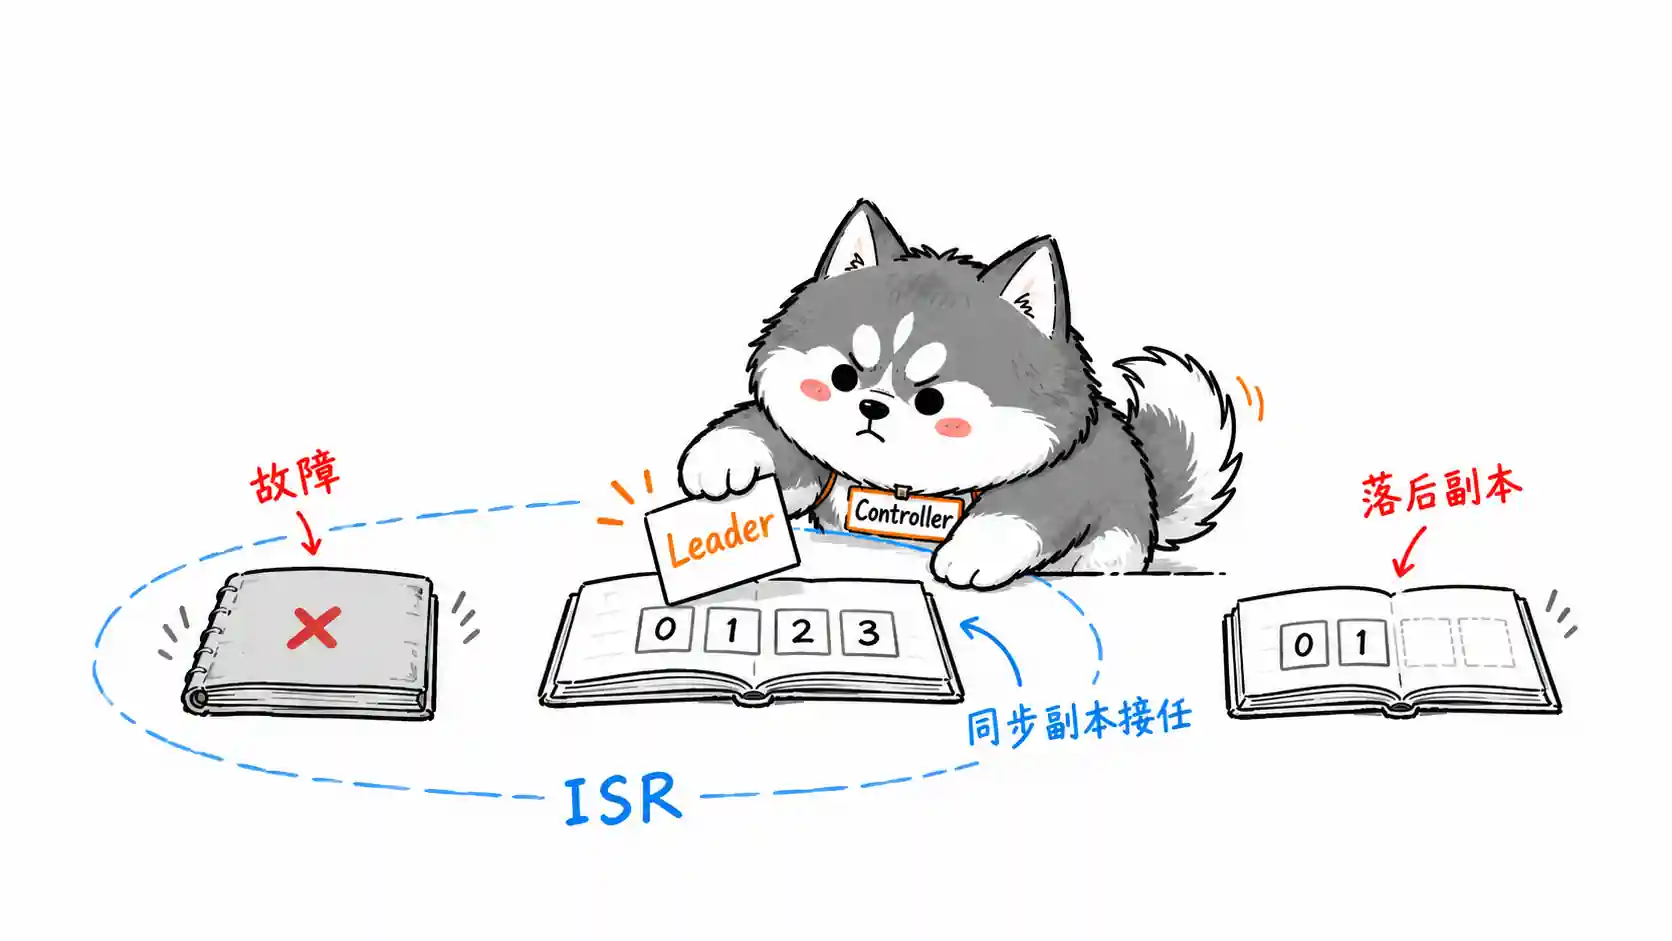
分区是 Kafka 的数据分片单位,每个分区有多个副本,副本之间一主多从——Leader 副本负责读写,Follower 只负责同步。Leader 挂了,得马上选个新的,不然这个分区就没法读写了。
这个选举由 Controller 全权负责,核心规则就一条:从 ISR 里选。
ISR(In-Sync Replicas,同步副本列表)是跟 Leader 保持同步的副本集合(含 Leader 自己)。Follower 落后太多(超过 replica.lag.time.max.ms,默认 30 秒)就会被踢出 ISR。
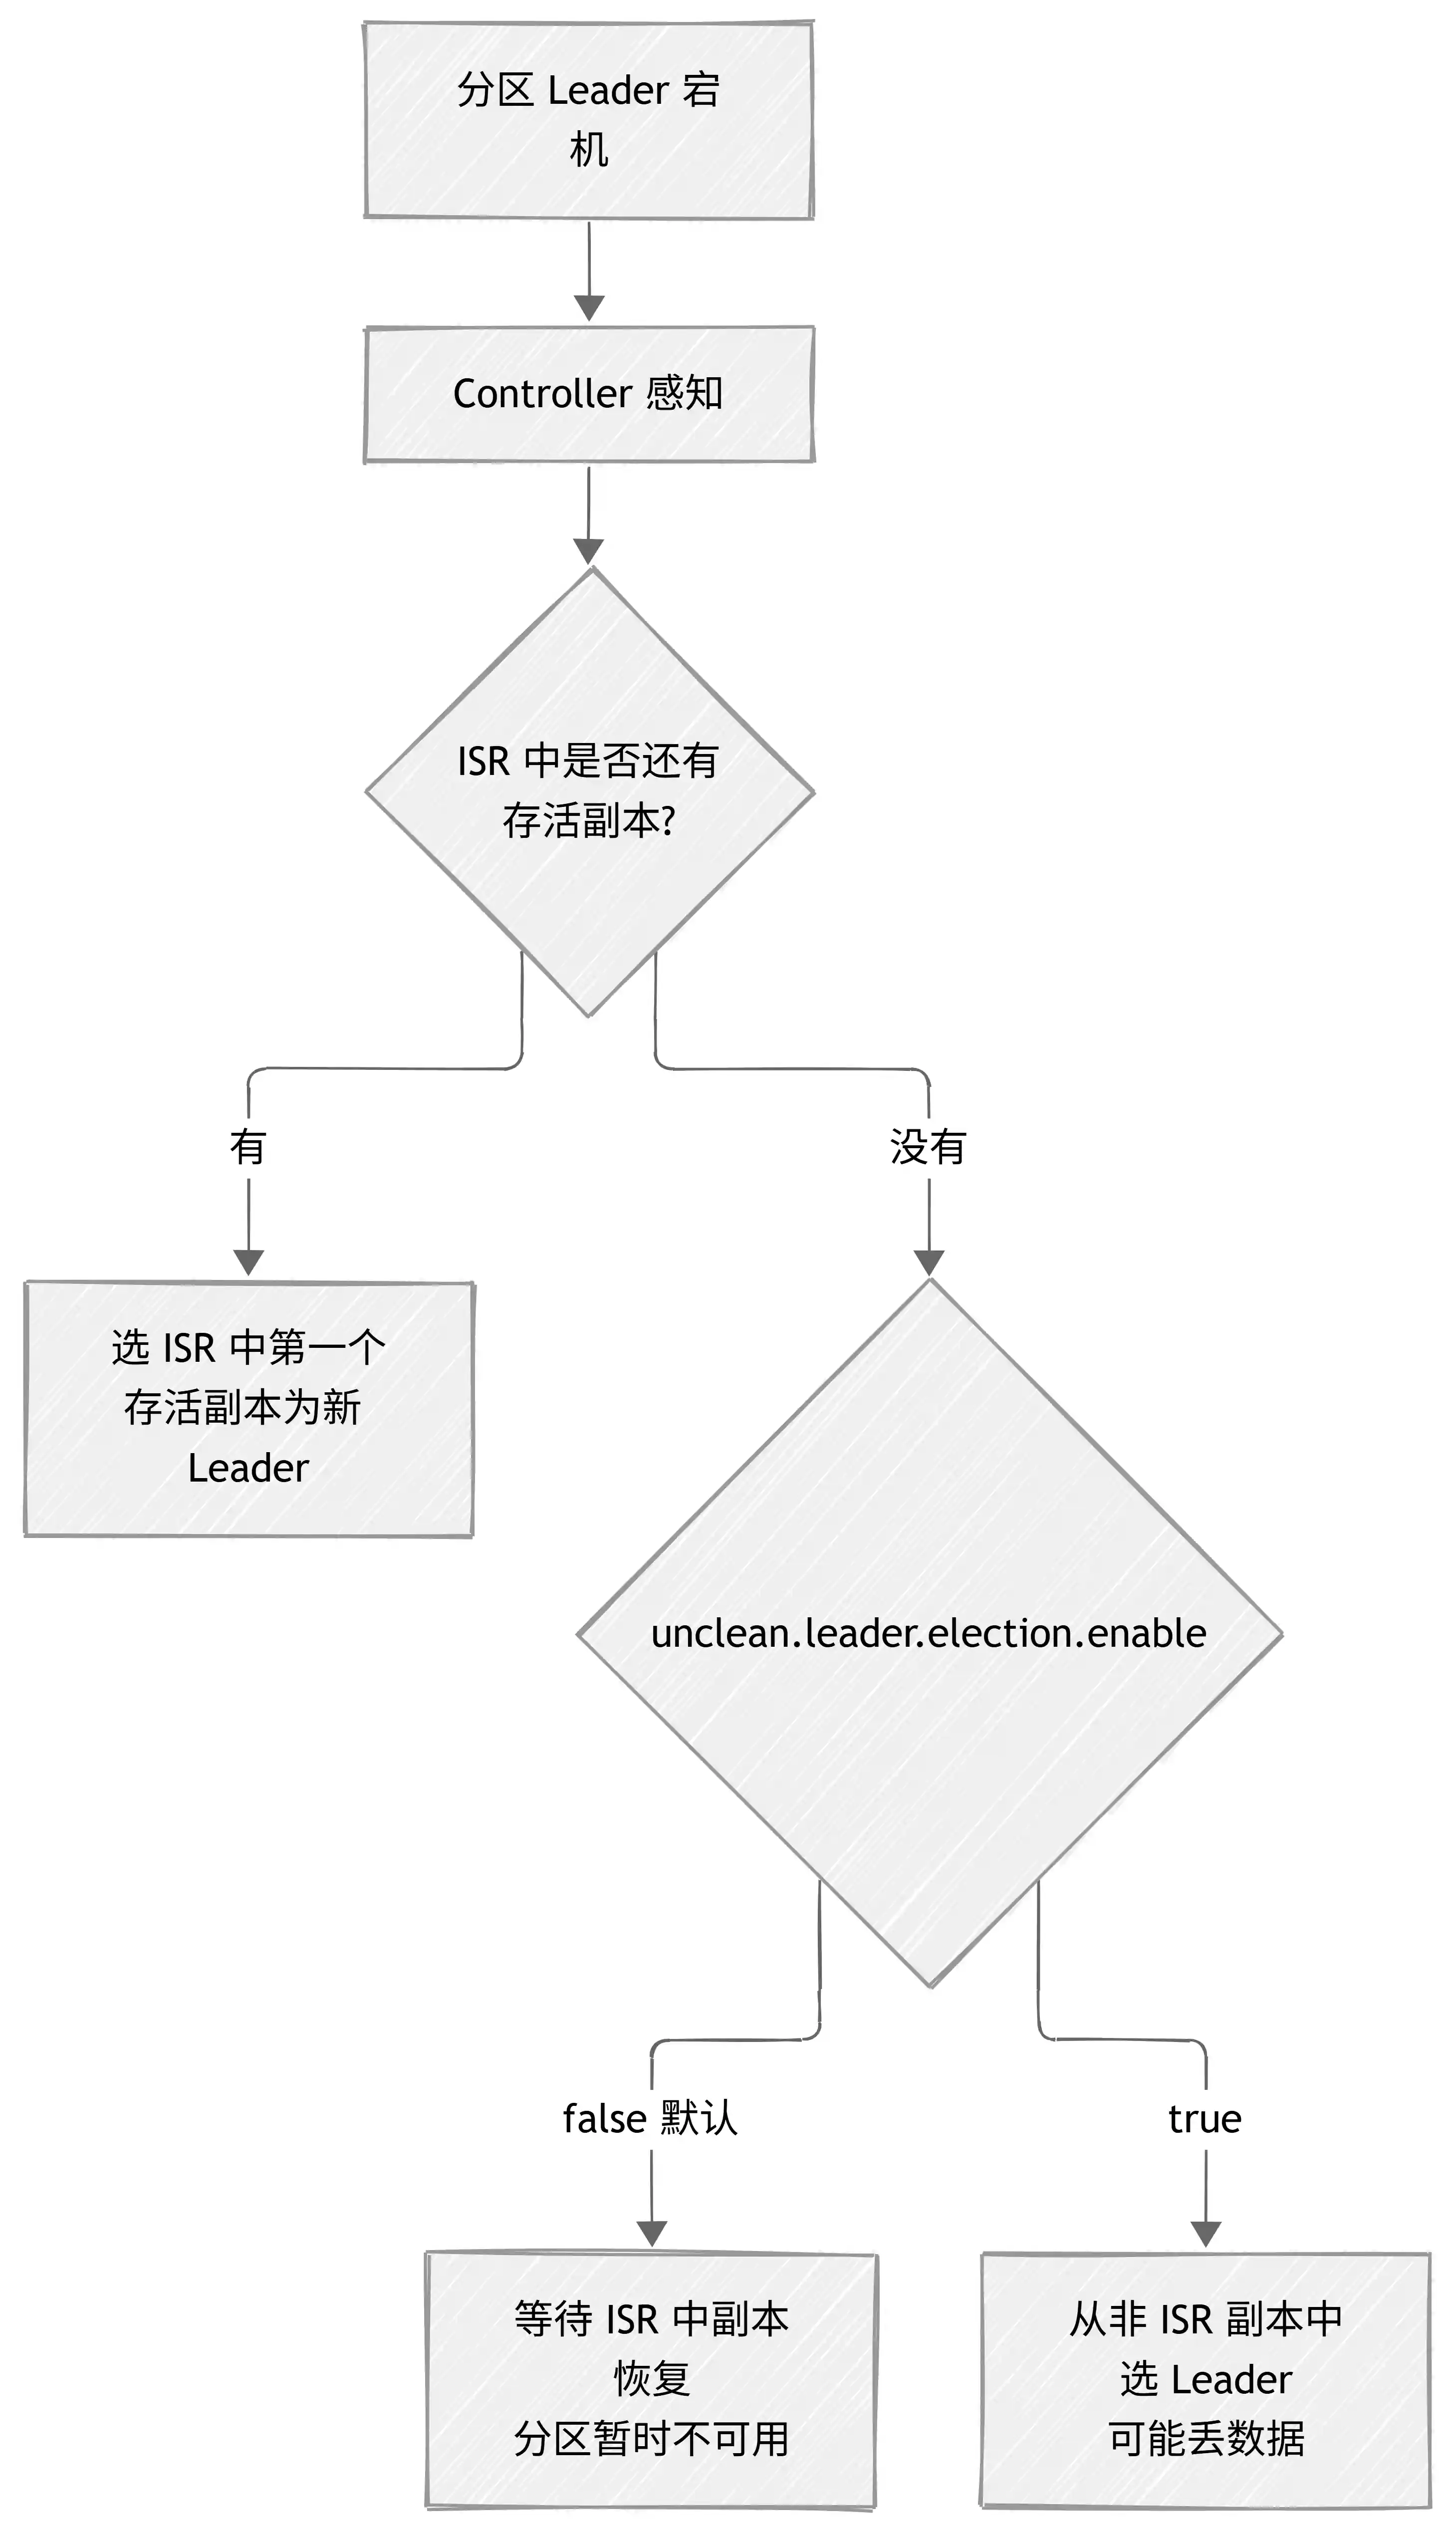
看图说话:
- 正常路径:Leader 挂了,Controller 从 ISR 里挑第一个存活的副本顶上。挑的时候还有个 “优先副本” 的概念——副本分配方案里的第一个副本优先当 Leader,这样集群稳定后各 Broker 的 Leader 数量是均衡的
- 极端情况:整个 ISR 全挂了,就看
unclean.leader.election.enable这个参数脸色——默认false,宁可分区不可用也不丢数据;设成true则允许落后副本(非 ISR)上位,换来可用性但已确认的消息可能丢 - 这就是经典的 CAP 权衡,Kafka 默认选了一致性
还有个细节:auto.leader.rebalance.enable 默认为 true,Controller 会周期性检查,把 Leader 挪回优先副本,防止 Leader 长期集中在少数 Broker 上。
三、Consumer Leader 选举:组长制定分配方案
这个选举最容易被忽略,但它跟重平衡(Rebalance)强相关,面试聊到消费组基本绕不开。
消费者加入组时,流程是这样的:
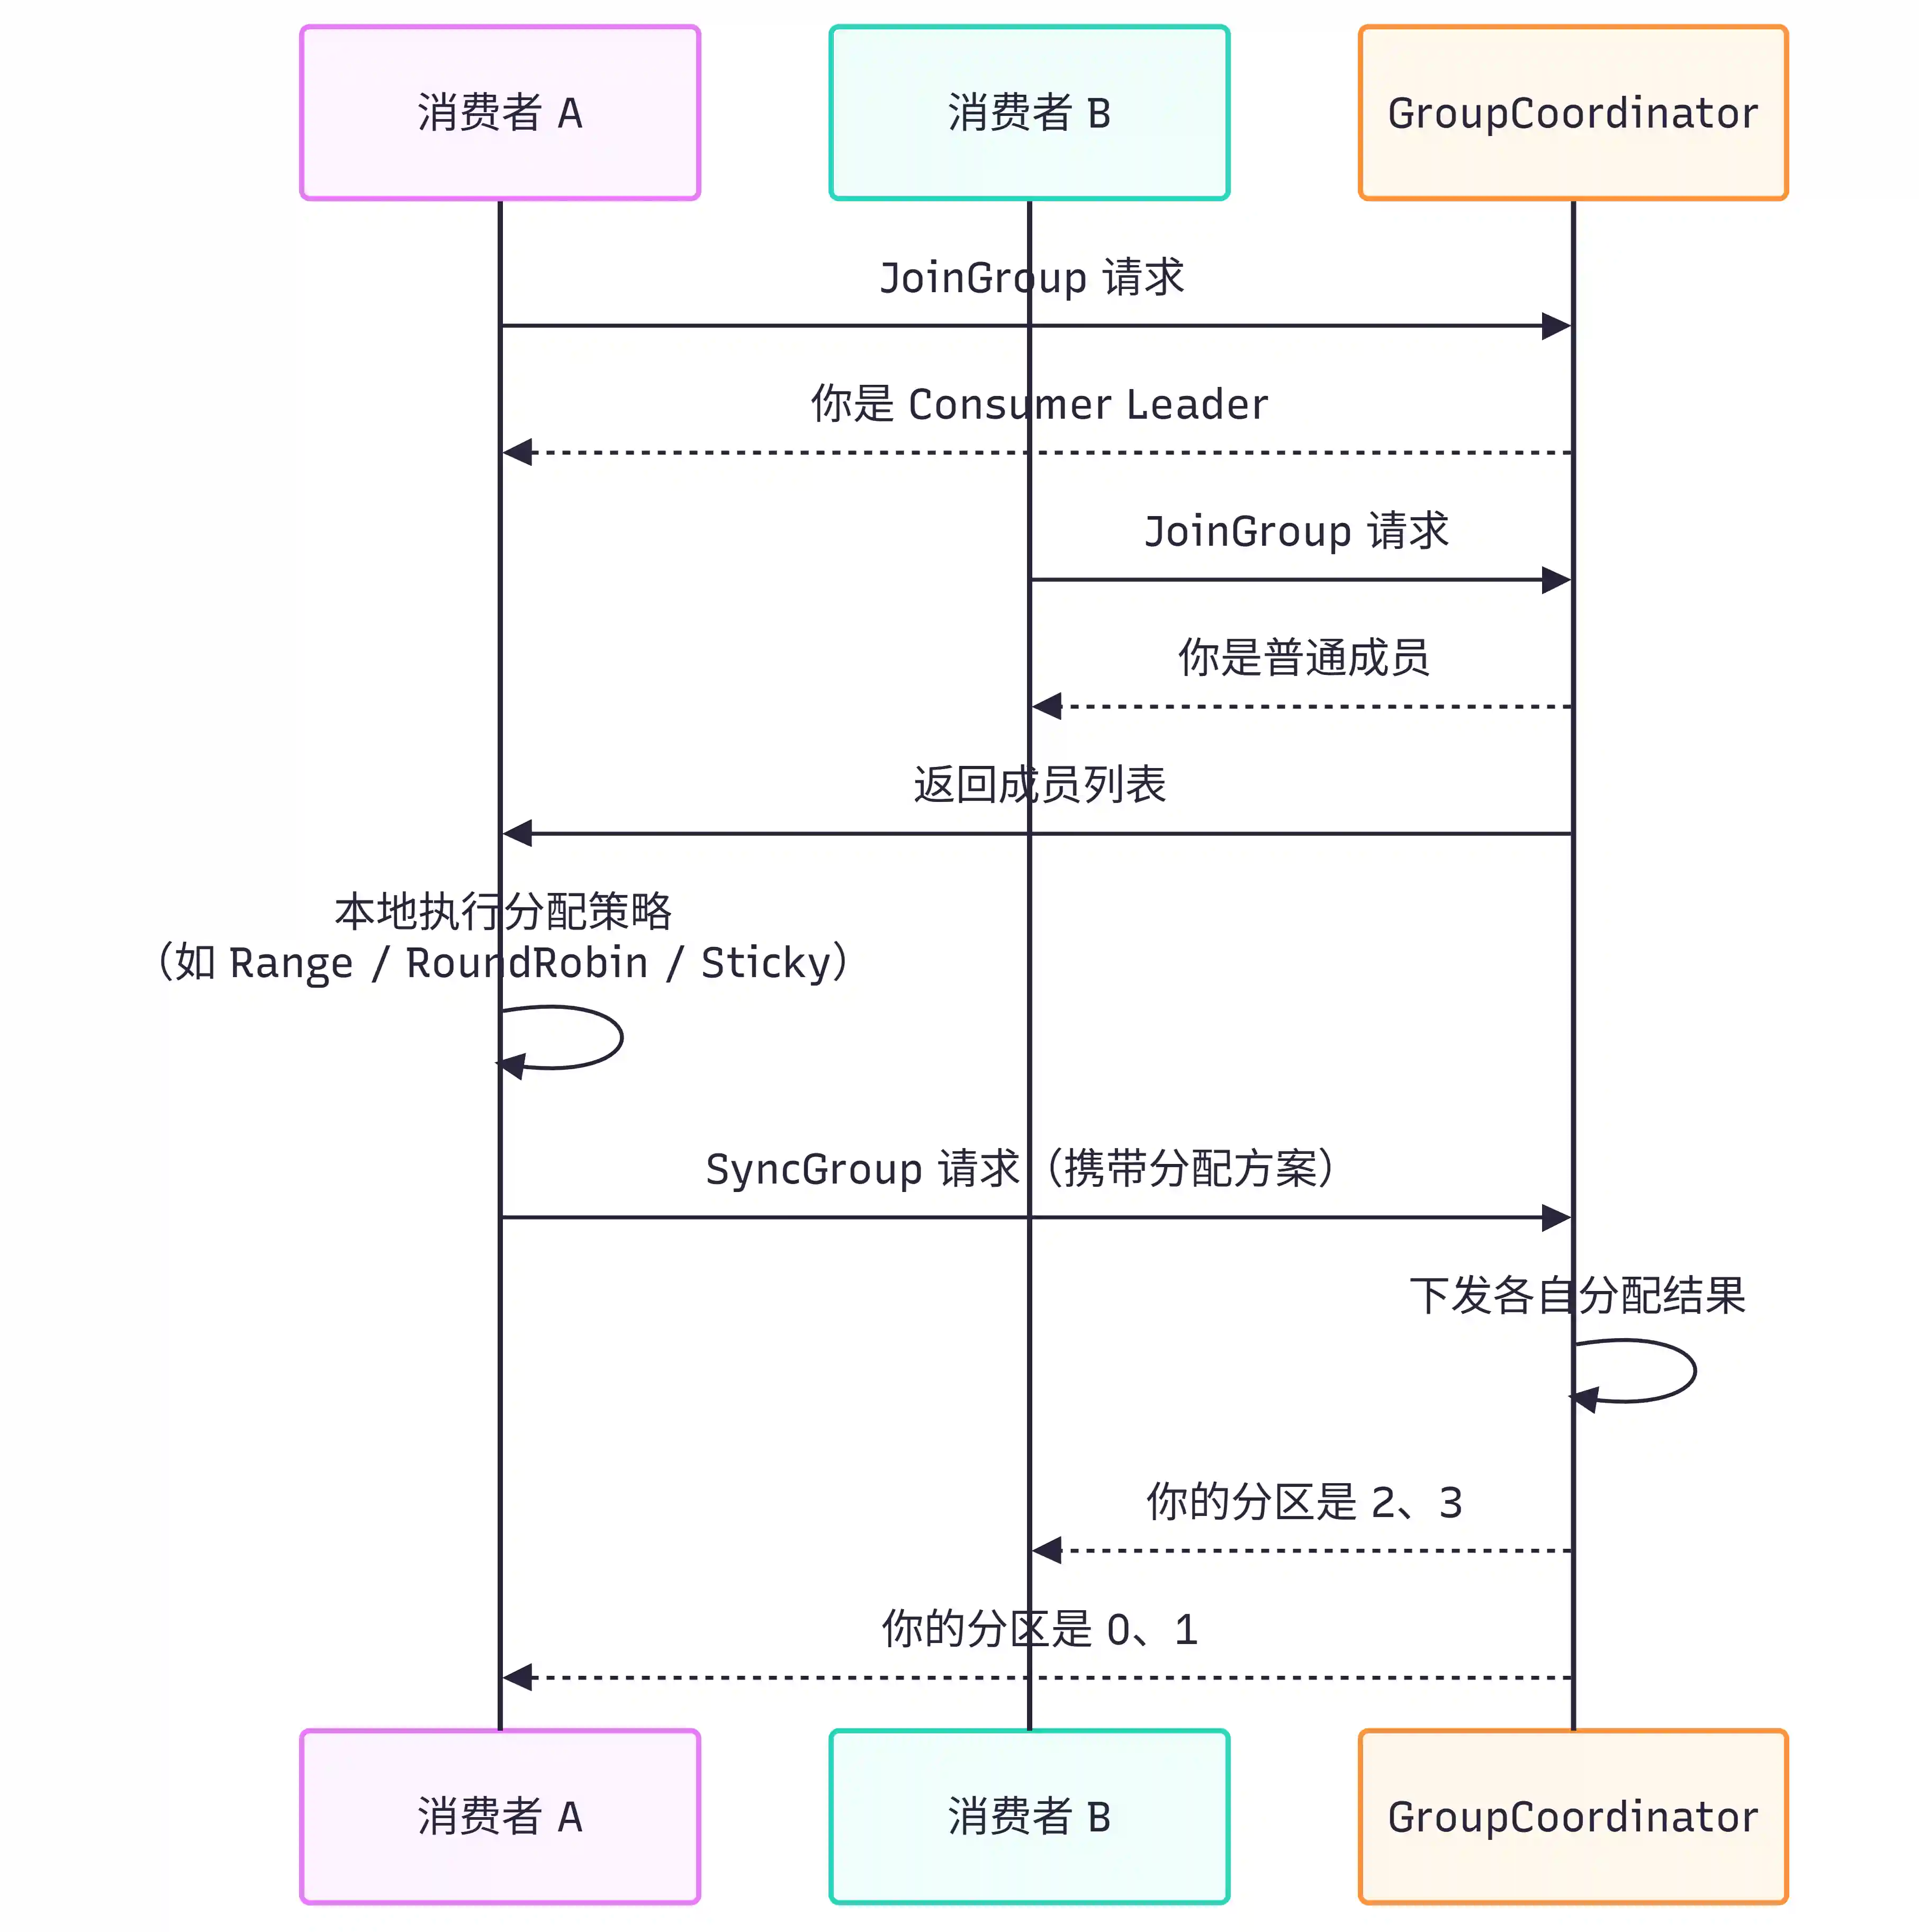
几个关键点:
- GroupCoordinator 是 Broker 侧的协调者,管理消费组的成员和状态
- 第一个成功加入组的消费者成为 Consumer Leader(不是官大的说了算,是来得早的说了算)
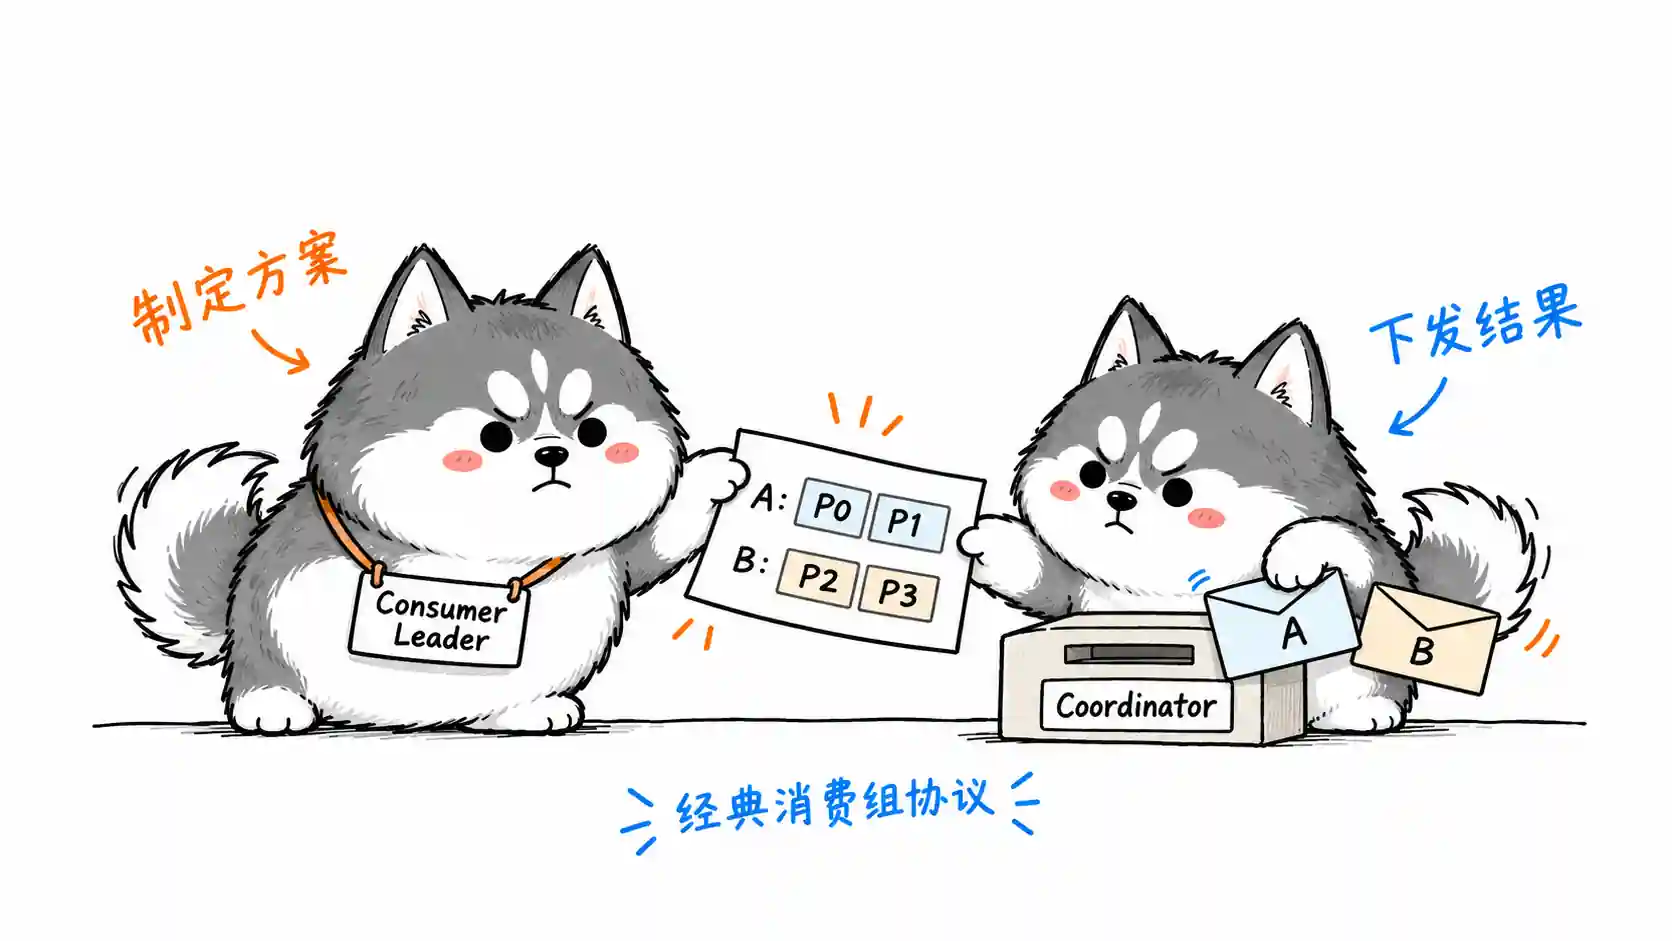
- Consumer Leader 拿到全体成员列表后,在本地 按分配策略算出 “谁消费哪些分区”,再把方案打包通过 SyncGroup 交给 Coordinator
- Coordinator 只是个转发者,自己不算——分配逻辑放在客户端,这设计其实挺聪明,Broker 压力小,还方便客户端自定义分配策略
Consumer Leader 挂了或者有新成员加入,就会触发 Rebalance,整个流程重来一遍。这也是消费组 “消费暂停抖动” 的根源。
面试高频追问
-
ISR 收缩和扩张的时机?
Follower 落后超过
replica.lag.time.max.ms被踢出(收缩);追上 Leader 后被重新拉回(扩张)。注意高版本已经不用 “落后条数” 判断,只用时间阈值。 -
Kafka 怎么防止脑裂?
靠 epoch 机制。Controller 有 controller epoch,分区有 leader epoch,每次换届代数 +1,旧 Leader 收到更大代数的请求会自觉下台,保证同一时刻只有一个权威 Leader。
-
为什么 Kafka 4.0 要移除 ZooKeeper?
ZK 模式下元数据存外部系统,Controller 故障转移要重新拉全量元数据,集群规模大、分区多时恢复贼慢;KRaft 把元数据放进 Kafka 自己的日志里,通过 Raft 复制,故障转移秒级完成,还少运维一套组件。
-
Rebalance 期间消费者能消费吗?
不能,整个消费组会暂停消费。除非用了增量协作式重平衡(cooperative sticky 这类策略),影响范围能小一些。
常见面试变体
- “Kafka 的 Controller 是干什么的?挂了会怎样?”
- “分区 Leader 选举为什么要限定在 ISR 里?”
- “KRaft 模式了解吗?跟 ZooKeeper 模式比好在哪?”
记忆口诀
三大选举一句话:“管家抢椅子,分区挑同步,组员选组长”——Controller 抢注册节点、Partition Leader 从 ISR 挑、Consumer Leader 按加入顺序定。
总结
Kafka 的选举就三块:Controller 选举(ZK 抢节点 / KRaft 多数派投票)、Partition Leader 选举(Controller 从 ISR 里挑,默认不丢数据优先)、Consumer Leader 选举(第一个入组的消费者,负责制定分配方案)。把这三个层次讲清楚,再补一句 KRaft 演进和 unclean 选举的 CAP 权衡,这道题基本就稳了。