为什么 Kafka 没办法 100% 保证消息不丢失?
一则或许对你有用的小广告
欢迎加入小哈的星球,你将获得:专属的实战项目(4个项目都能学) / 1v1 提问 / 简历修改 / Java 学习路线 / 社群讨论 / 学习打卡 / 每月赠书
《Spring AI 项目实战(问答机器人、RAG 智能客服、联网搜索)》已完结,基于
Spring AI + Spring Boot 3.x + JDK 21...,查看介绍《从零手撸:仿小红书(微服务架构)》 已完结,基于
Spring Cloud Alibaba + Spring Boot 3.x + JDK 17...,查看介绍;演示链接:http://116.62.199.48:7070/《从零手撸:前后端分离博客项目(全栈开发)》 2 期已完结,演示链接:http://116.62.199.48/
新开坑项目:《从零手撸:秒杀系统高并发优化实战》 正在更新中...,查看介绍
截止目前,星球内专栏累计输出 150w+ 字,讲解图 5110+ 张,还在持续爆肝中.. 后续还会上新更多项目,已有 4700+ 小伙伴加入学习,欢迎点击围观
面试考察点
-
链路全局观:面试官不仅仅是想知道几个配置参数,更是想看你是否清楚消息从生产到消费的完整链路,能不能指出每个环节的故障点。
-
可靠性原理:考察你对
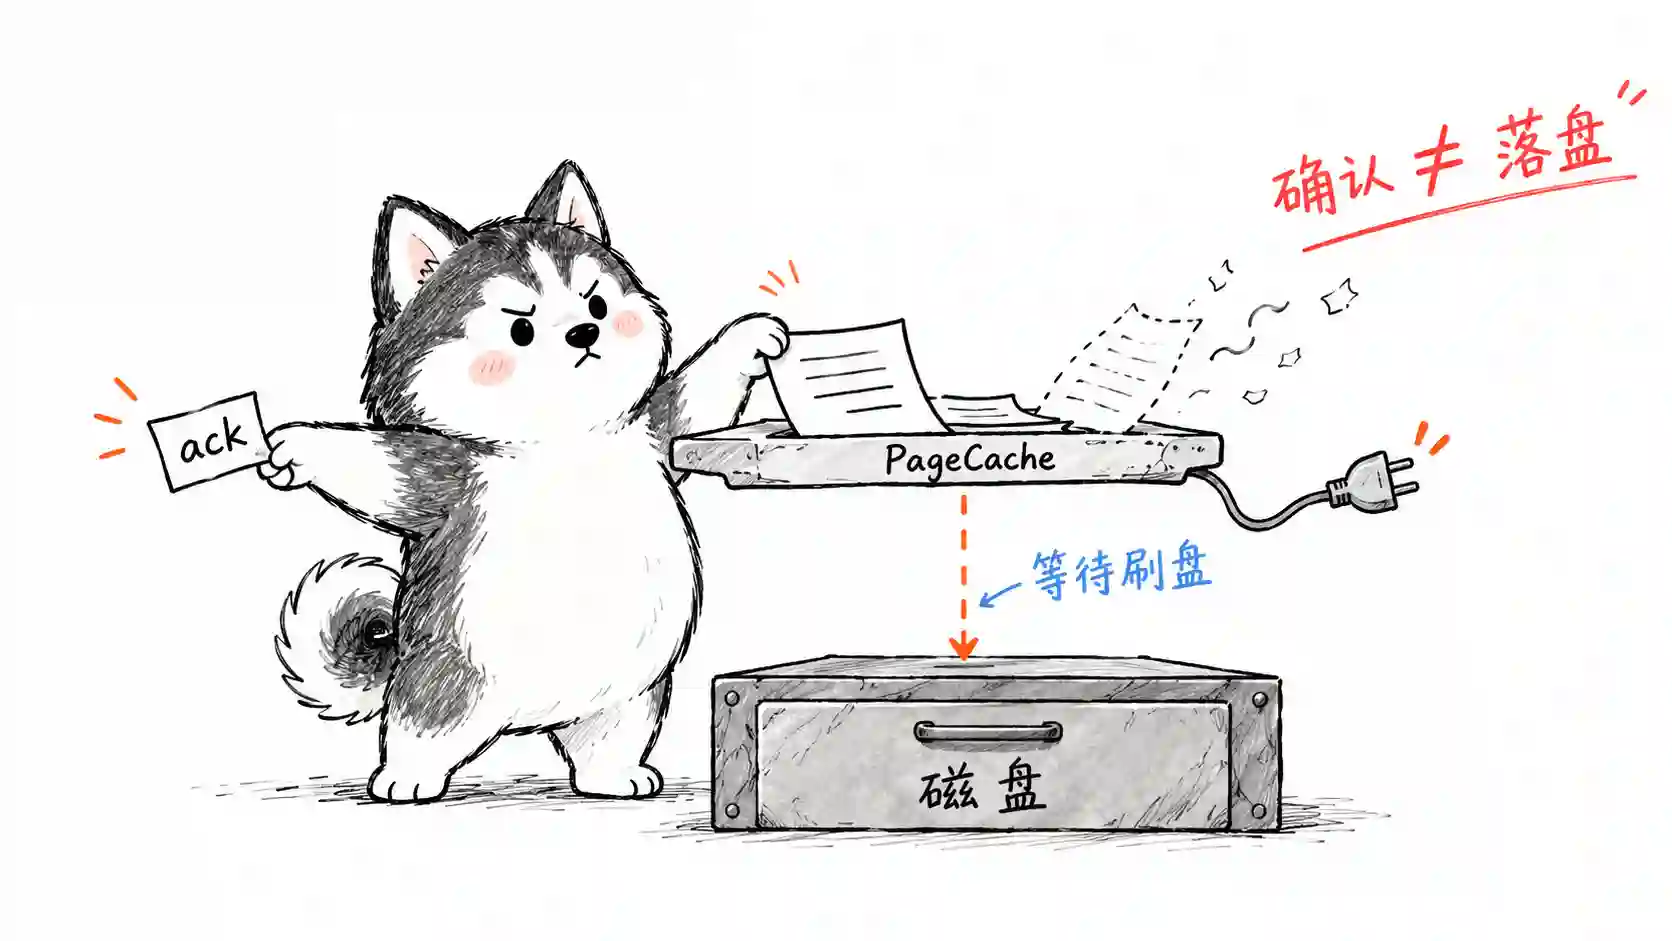
acks机制、ISR 副本同步、PageCache 刷盘这些底层机制的理解,知不知道 “确认” 和 “持久化” 之间的差别。 -
分布式权衡意识:最加分的一点,是你能不能站在 CAP 和性能权衡的角度,讲明白 “100% 可靠” 和 “高吞吐” 天然冲突,Kafka 为什么选择把可靠性做成可配置的。
核心答案
先说结论:消息在整个链路里要经过生产者、Broker、消费者三个阶段,每个阶段都存在故障窗口;而 Kafka 为了高吞吐,采用的是 “异步刷盘 + 副本冗余” 的设计,不是 “同步刷盘 + 同步复制” 的强持久化设计,所以总存在极端场景下丢消息的可能。
| 环节 | 丢失场景 | 根因 |
|---|---|---|
| 生产者 | 缓冲区消息还没发出去,应用崩了 | 发送是异步的 |
| Broker | Leader 写入 PageCache 就返回 ack,还没落盘机器断电 | 刷盘是异步的 |
| Broker | Leader 挂了,Follower 还没同步到最新消息 | 副本同步有延迟 |
| 消费者 | offset 先提交了,消息还没处理完消费者就崩了 | 自动提交 offset |
一句话:Kafka 的 “确认” 大部分时候只代表 “写进了内存(PageCache)”,不代表 “刻在了磁盘上”。想 100% 不丢就得每条消息同步刷盘 + 全副本同步确认,那吞吐量直接没法看,和 Kafka 的设计目标冲突。
深度解析
一、消息在哪些环节会丢
先看消息的完整旅程,我把四个丢失窗口直接标在图上。
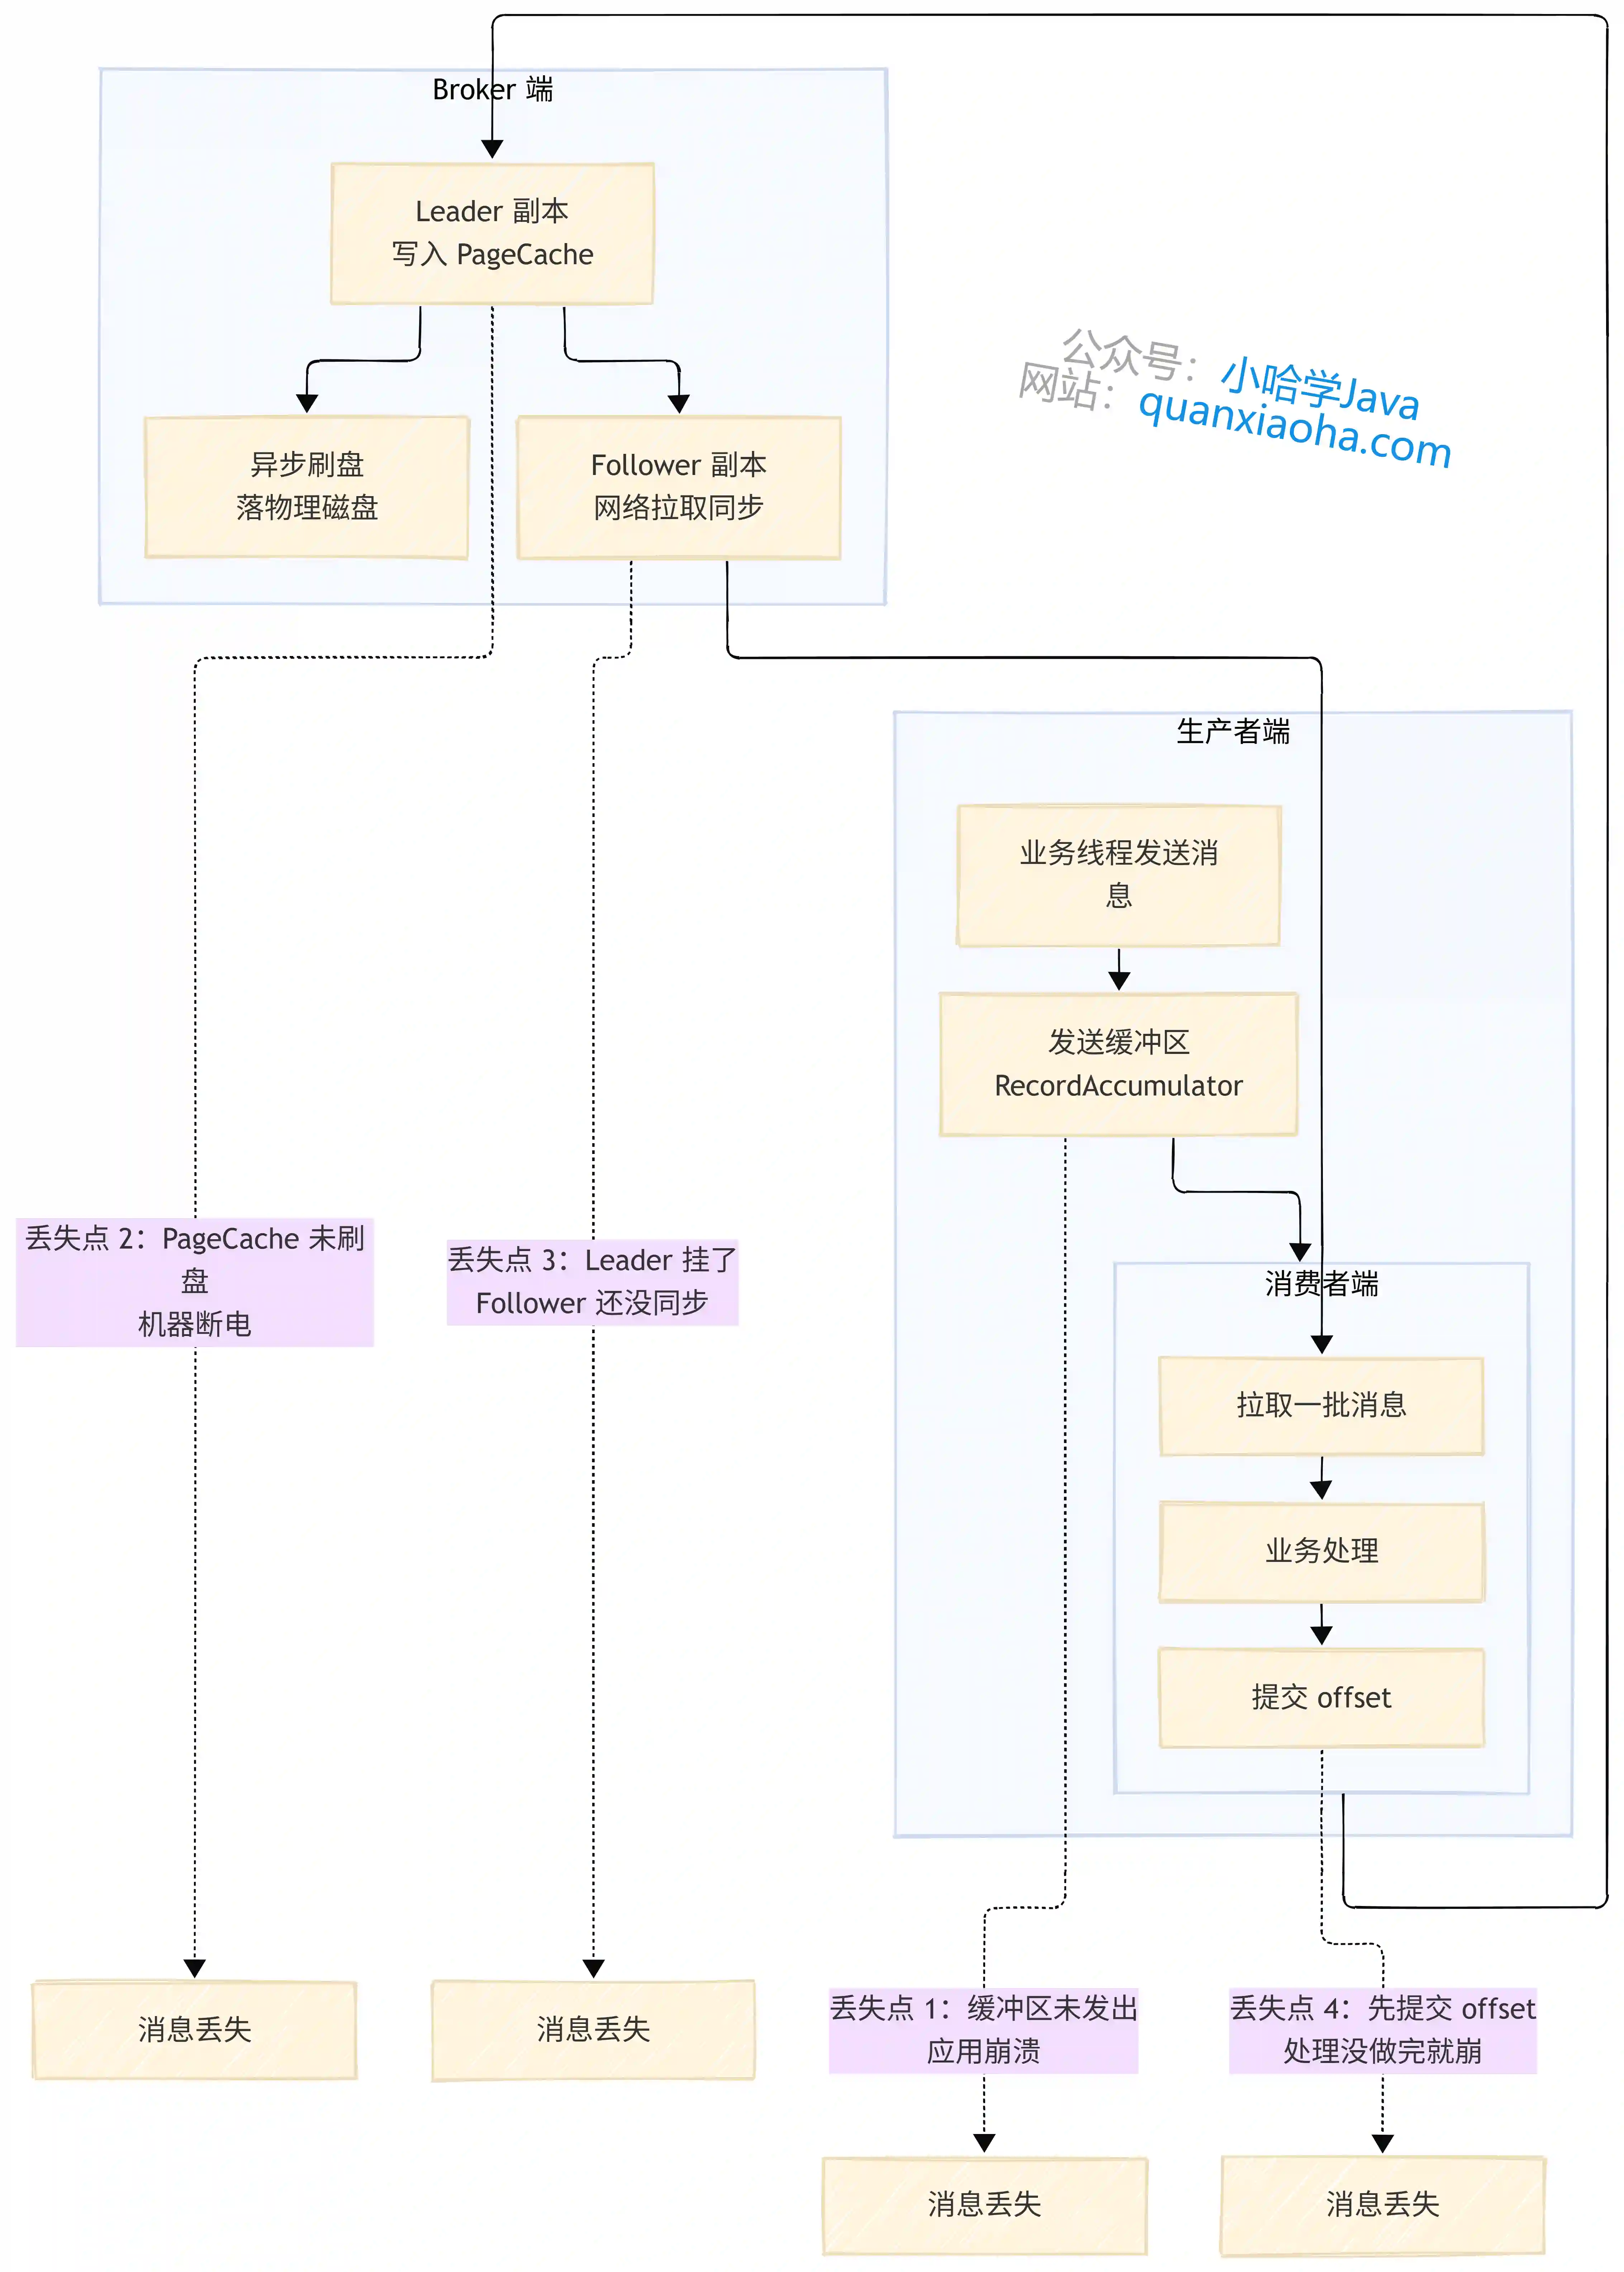
上图把四个丢失窗口画全了,挨个说:
- 丢失点 1(生产者缓冲区):Kafka 生产者发消息不是直接走网络的,先进
RecordAccumulator(本地缓冲区)攒批,由 Sender 线程异步批量发送。如果你的应用在消息还在缓冲区里的时候就崩了,这些消息直接没了,谁都救不回来。 - 丢失点 2(PageCache 未刷盘):消息到了 Broker,Leader 副本把它写进操作系统的 PageCache 就算 “已接收”。真正写到物理磁盘是异步进行的。如果这时候机器断电,PageCache 里还没落盘的消息全部蒸发。注意,副本也在赌同一件事——Follower 拉取的也是 PageCache 里的数据,它自己同样没落盘。极端情况下整个机房断电,所有副本一起丢。
- 丢失点 3(副本同步延迟):这是
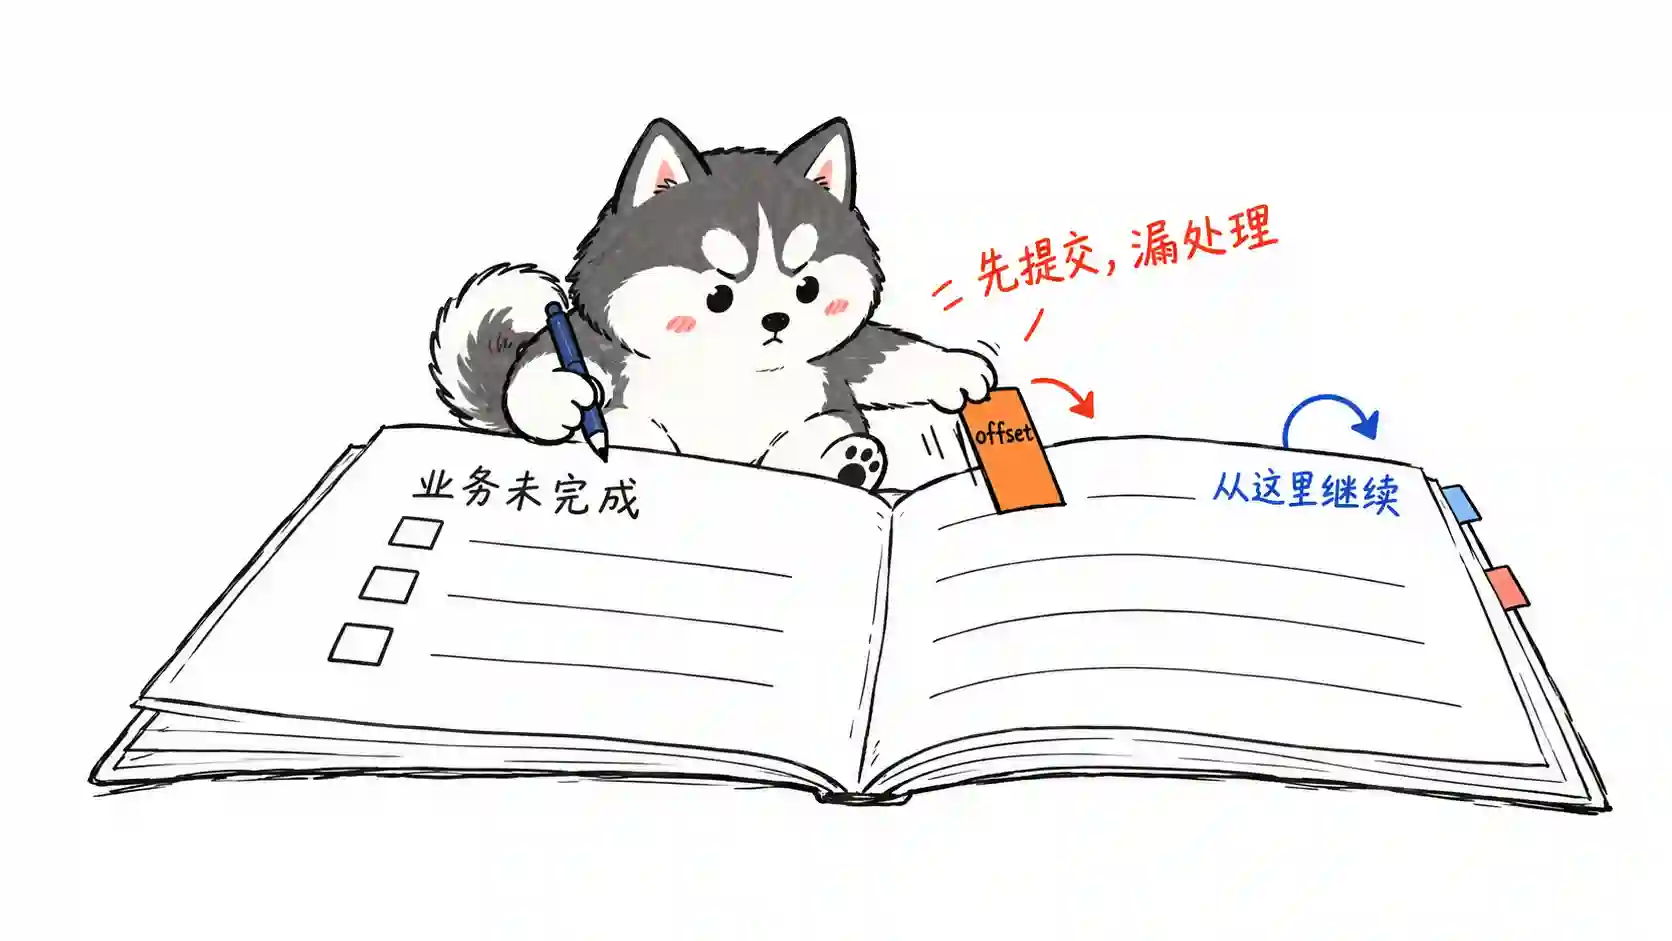
acks=1的经典坑。看下面这个时序图就明白了。 - 丢失点 4(消费者提前提交):自动提交 offset(默认开启,每 5 秒一次)的机制是 “先提交、后处理”。消费者拉了一批消息,offset 提交上去了,但业务处理才做到一半就崩溃,重新上线后从已提交的 offset 继续往前消费。中间没处理的那部分消息,再也没有人会消费它们,等于丢了。
丢失点 3 展开看一下:
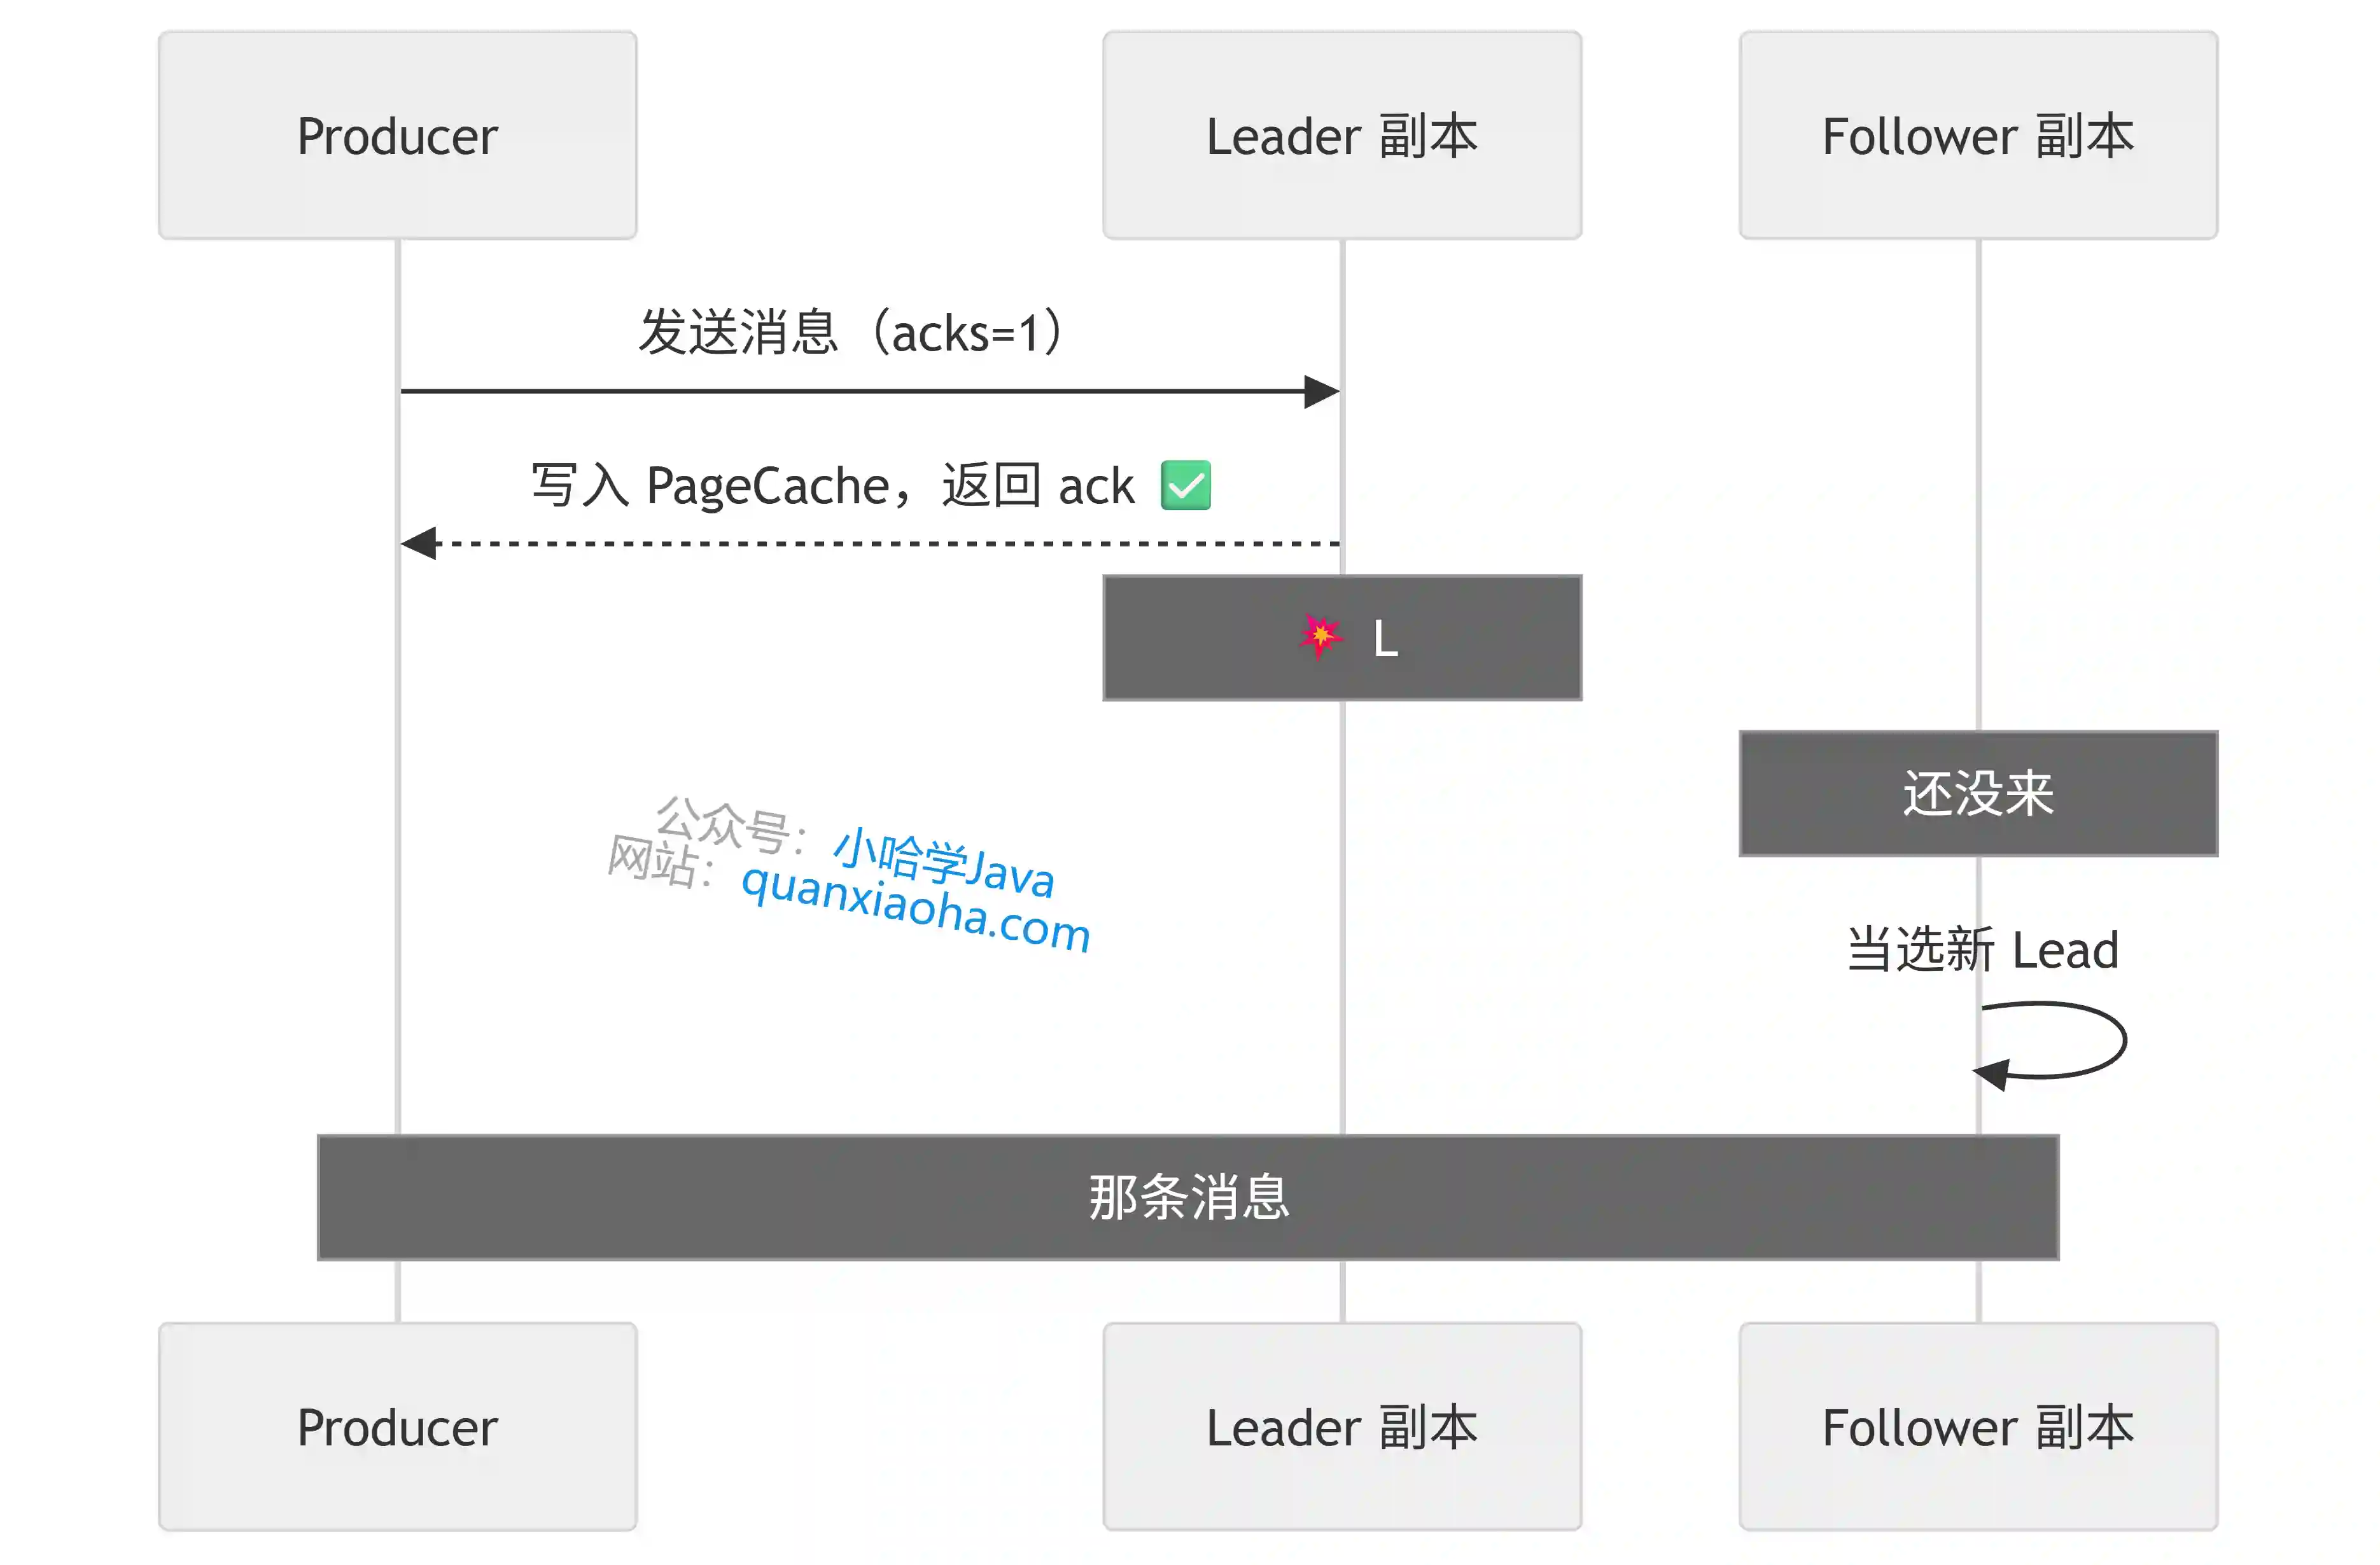
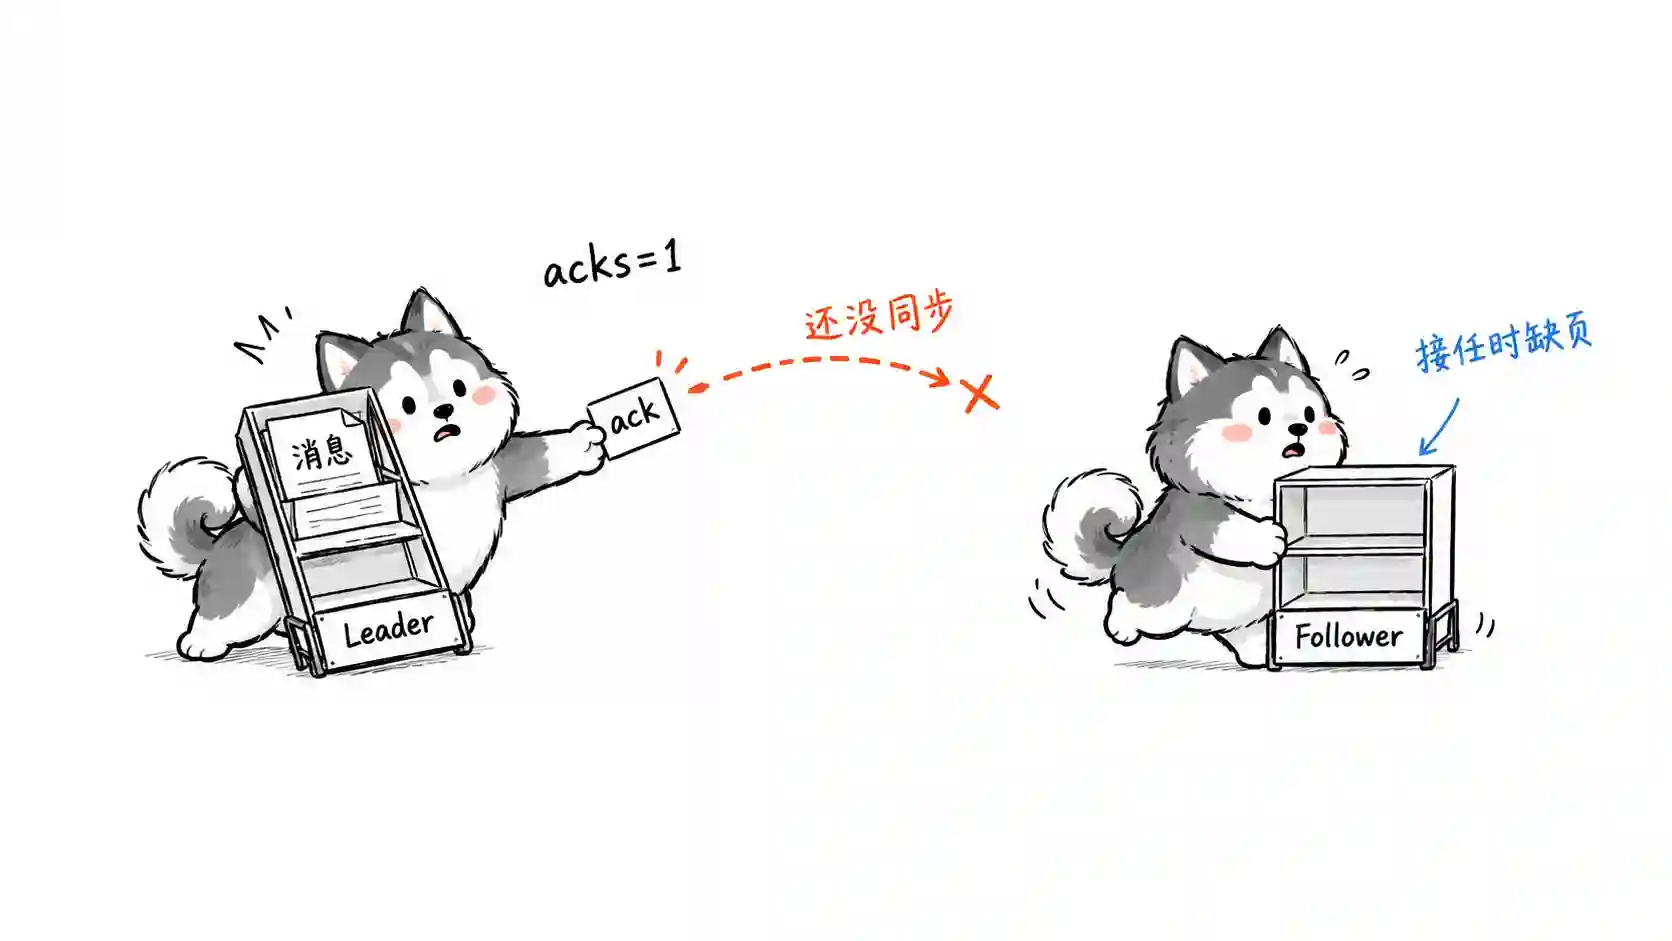
acks=1 的语义是 “Leader 写入本地日志就返回成功”。但 Leader 的 “写入” 只是写进 PageCache,Follower 的同步是异步追赶的。Leader 在 Follower 同步到之前挂掉,新 Leader 的日志里根本没有这条消息——而生产者早就收到 ack 走人了。所以说,acks=1 是个半吊子配置。
二、为什么理论上做不到 100%
配置可以全拉满,但有三个硬限制摆在那儿。
1. PageCache 与物理磁盘之间永远有时间差
Kafka 没有 “每条消息同步刷盘” 的模式。它的持久化思路是:单机磁盘不可靠,靠多副本冗余对抗故障,刷盘交给操作系统异步调度。你可以在 Broker 上配 log.flush.interval.messages、log.flush.interval.ms 强制刷盘,但这两个参数的默认值都是 Long.MAX_VALUE,等于基本不主动触发,而且官方文档明确不建议改。频繁 fsync 会让吞吐量断崖式下跌,Kafka 的高吞吐基本盘就没了。
对比一下:RocketMQ 有 SYNC_FLUSH(同步刷盘)模式,每条消息落盘才返回;Kafka 为了吞吐,选择了另一条路。这是产品定位的取舍,不是缺陷。
2. 同步复制的性能代价高到难以接受
就算把 acks=all、min.insync.replicas 拉满,Kafka 的 “确认” 含义也只是 “所有 ISR 副本的 PageCache 里都有这条消息”,依然不是 “已落盘”。真要逼近 100%,得全副本同步复制 + 同步刷盘,每次写入的延迟等于最慢副本的响应时间加一次磁盘 fsync,吞吐直接掉一个数量级。而且任何一个副本抖动,整个分区写入就会被拖住——可靠性和可用性在这里也是打架的。
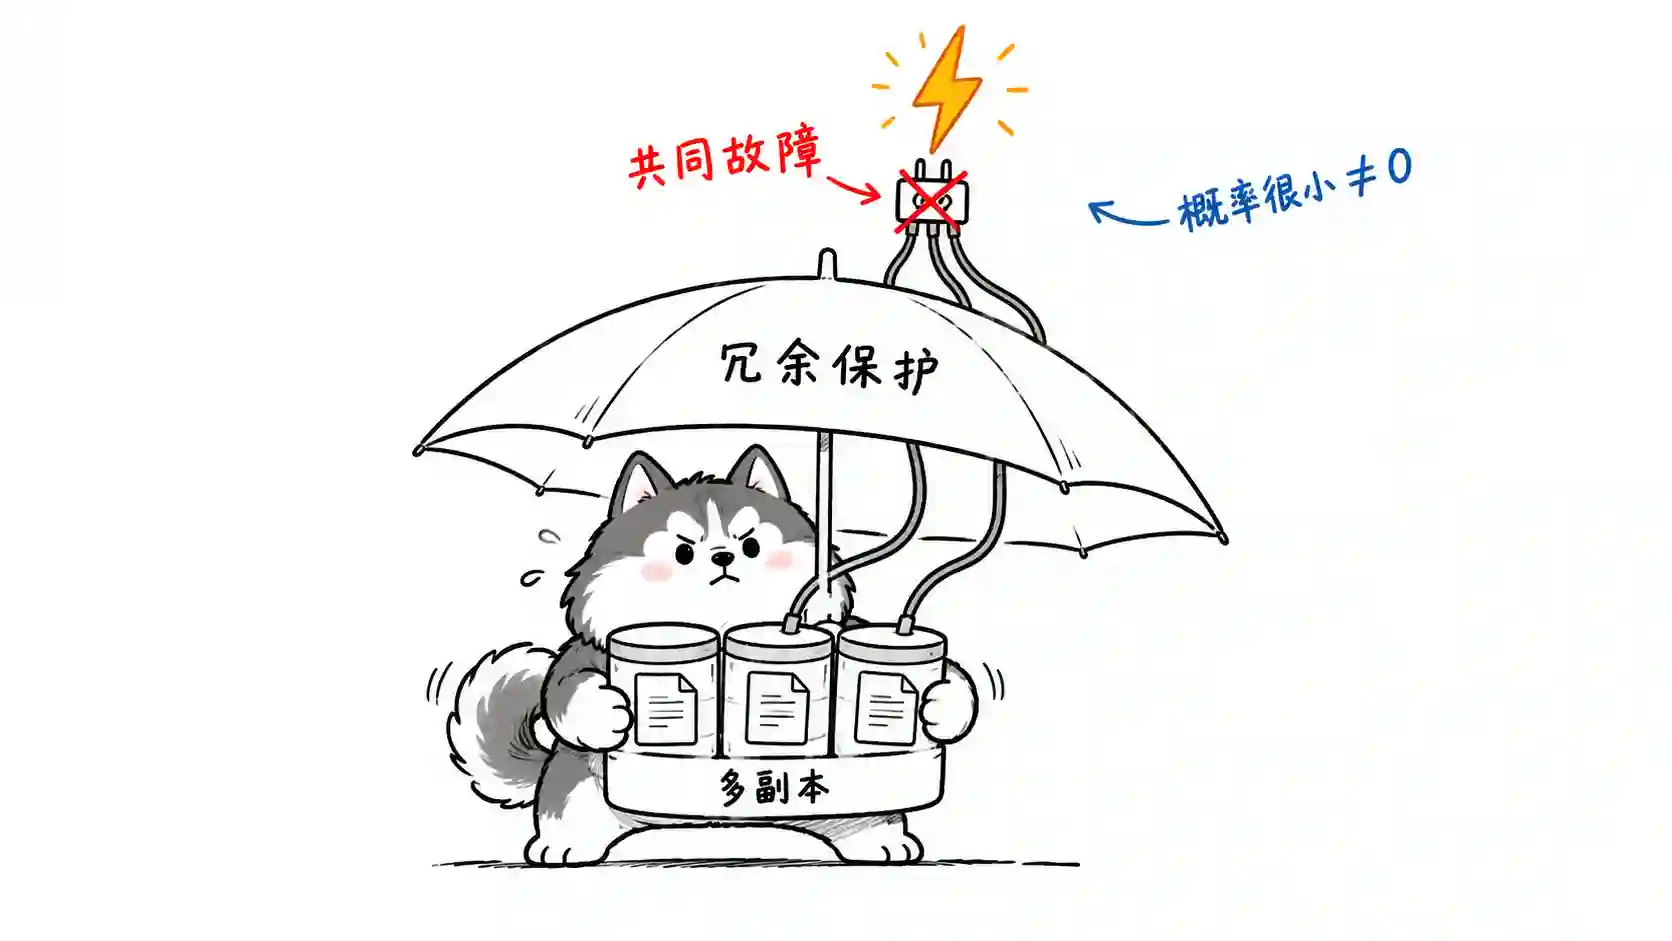
3. 分布式系统对抗不了所有故障的组合
机房级断电、磁盘物理损坏、文件系统损坏……多副本能扛住单点故障,扛不住所有副本同时失效。数学上讲,丢失概率能压到极小(比如每年 10⁻⁹ 的量级),但永远不是 0。这是分布式系统的物理现实,不是 Kafka 一家的问题。
所以 Kafka 官方给出的承诺是 “可配置的可靠性等级”,从 at-most-once 到 at-least-once 再到事务级的 exactly-once,按业务对可靠性和吞吐的要求来选就行。“绝对不丢” 并不在它的承诺列表里。
三、生产环境怎么把丢失概率压到最低
虽然做不到 100%,但三个环节的配置拉满,能把概率压到工程上可以忽略的程度。
生产者配置:
# 所有 ISR 副本确认才算发送成功
acks=all
# 失败重试,配合 delivery.timeout.ms 兜底
retries=2147483647
delivery.timeout.ms=120000
# 幂等发送,防止重试导致消息重复(Kafka 3.0 起默认开启)
enable.idempotence=true
Broker 端配置:
# 每个分区至少 3 个副本
default.replication.factor=3
# ISR 里至少 2 个副本同步才算写入成功
min.insync.replicas=2
# 禁止落后太多的副本(非 ISR)竞选 Leader
unclean.leader.election.enable=false
消费者配置:
// 关闭自动提交
props.put("enable.auto.commit", "false");

// 处理完一批,手动提交 offset
try {
    for (ConsumerRecord<String, String> record : records) {
        handle(record); // 业务处理
    }
    consumer.commitSync(); // 处理成功才提交
} catch (Exception e) {
    // 处理失败不提交,下次 poll 会重新拉取这批消息
    log.error("处理失败,等待重新消费", e);
}
这套配置的组合拳是:acks=all + min.insync.replicas=2 + replication.factor=3,意思是 3 个副本里至少 2 个收到了才算成功,单台机器挂了集群照样可用,数据也不会丢。加上幂等生产者防重复,整体达到 at-least-once 语义。
面试高频追问
-
追问一:
acks=all就一定不丢吗?- 不一定。如果
min.insync.replicas=1,acks=all会退化成和acks=1差不多;如果开启了 unclean leader election,落后副本上位也会丢已提交的消息;还有 PageCache 未刷盘的极端断电场景。
- 不一定。如果
-
追问二:怎么保证消息不重复?不丢和重复能同时保证吗?
- 生产端开幂等(
enable.idempotence=true)解决单分区会话内的重复,跨分区跨事务用 Kafka 事务;消费端靠业务侧幂等(唯一键、去重表)。不丢(at-least-once)和恰好一次(exactly-once)的差距就在重复消息的处理上。
- 生产端开幂等(
-
追问三:Kafka 和 RocketMQ 在消息可靠性上有什么区别?
- RocketMQ 支持同步刷盘(
SYNC_FLUSH),消息落盘才返回,单机可靠性更强;Kafka 只能异步刷盘,靠多副本冗余换高吞吐。
- RocketMQ 支持同步刷盘(
-
追问四:既然会丢,为什么大家还用 Kafka?
- 吞吐量高、生态成熟,而且可靠性等级可以配到满足绝大多数业务(支付级场景也能压到工程上可接受的程度)。真正的 100% 可靠本来就不存在,工程上追求的是 “概率足够小 + 出了问题可兜底”。
常见面试变体
- “Kafka 怎么保证消息不丢失?”(正向问法,答三个环节的配置)
- “Kafka 的
acks参数有哪几个值?分别什么含义?” - “什么情况下
acks=all也会丢消息?” - “Kafka 的 ISR 机制是什么?和消息可靠性什么关系?”
记忆口诀
四丢:缓冲区丢、页缓存丢、副本没同步丢、offset 提前提交丢。
配置口诀:acks=all、副本三、最小同步二、禁 unclean、手动提交 offset。
总结
一句话:Kafka 为了高吞吐选择了异步刷盘 + 副本冗余的设计,“确认” 只到内存不到磁盘,链路上每个环节都有故障窗口,极端场景(比如所有副本同时失效)必然丢消息。这是性能与可靠性的架构取舍,不是 bug。面试时把三个环节的丢失场景和配置方案讲清楚,再往上升到 CAP 权衡的角度,这道题就答透了。