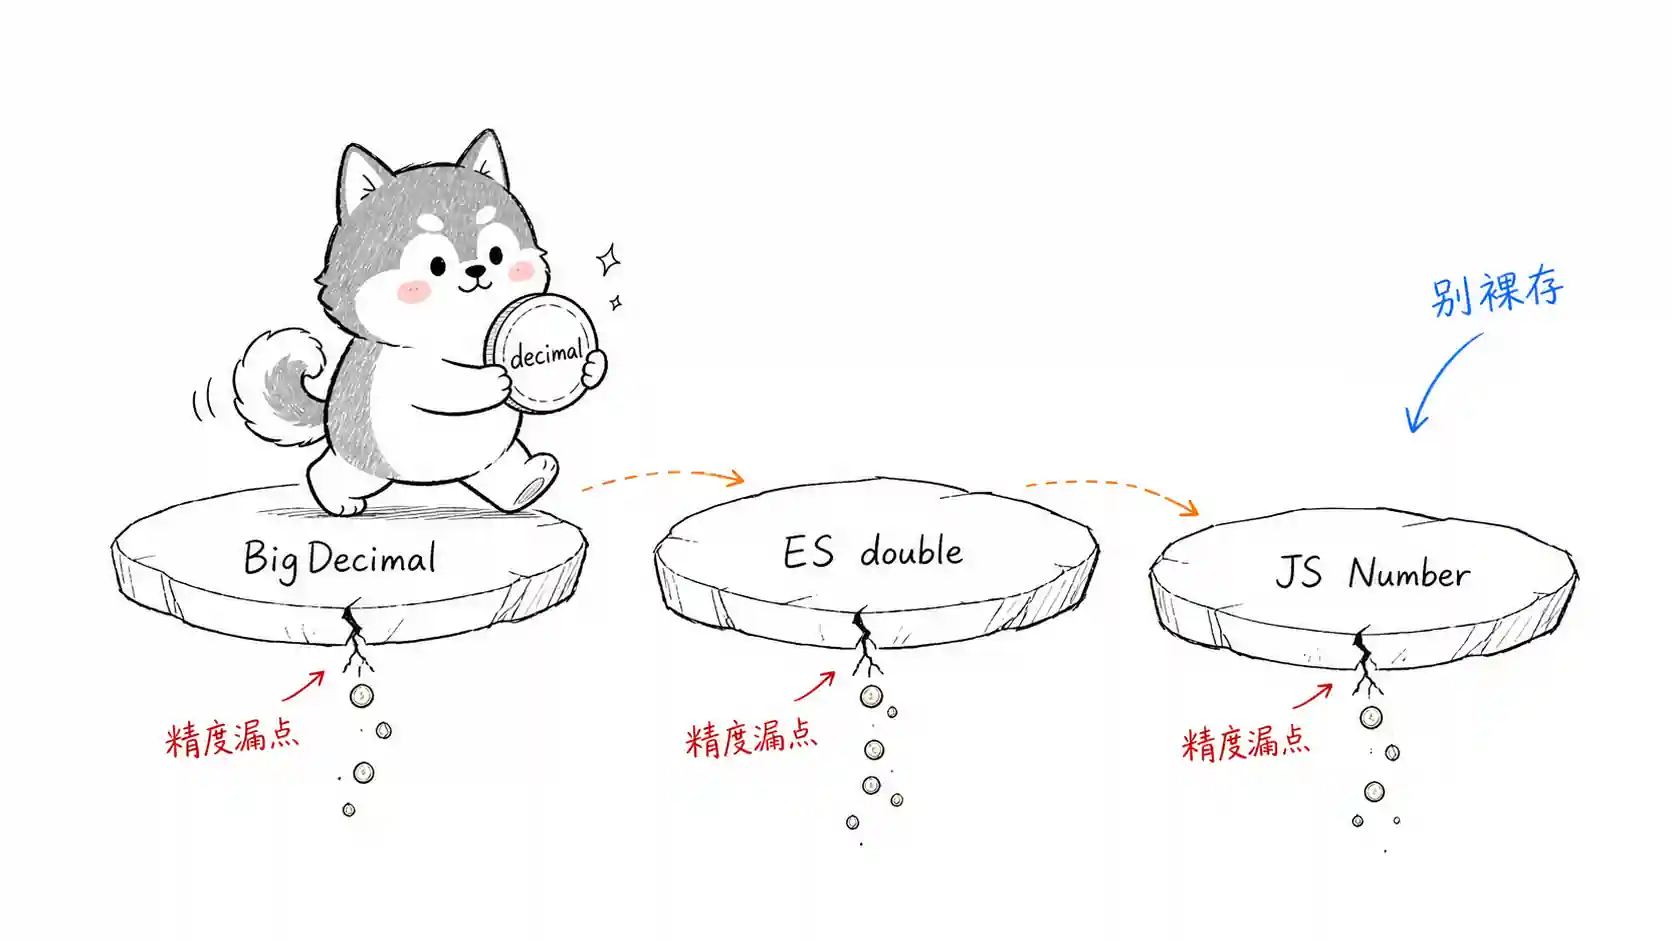
ES 不支持 decimal,如何避免丢失精度?
ES 不支持 decimal,float/double 按 IEEE 754 存储,存金额必丢精度。本文详解三种主流方案:金额转分存 long、scaled_float 缩放存储、keyword 字符串兜底,并覆盖 JSON 序列化、前端 JS 大数、聚合精度暗坑等全链路踩坑点,助你面试与生产双通关。
2026/8/27Java面试八股文
ES 不支持 decimal,float/double 按 IEEE 754 存储,存金额必丢精度。本文详解三种主流方案:金额转分存 long、scaled_float 缩放存储、keyword 字符串兜底,并覆盖 JSON 序列化、前端 JS 大数、聚合精度暗坑等全链路踩坑点,助你面试与生产双通关。
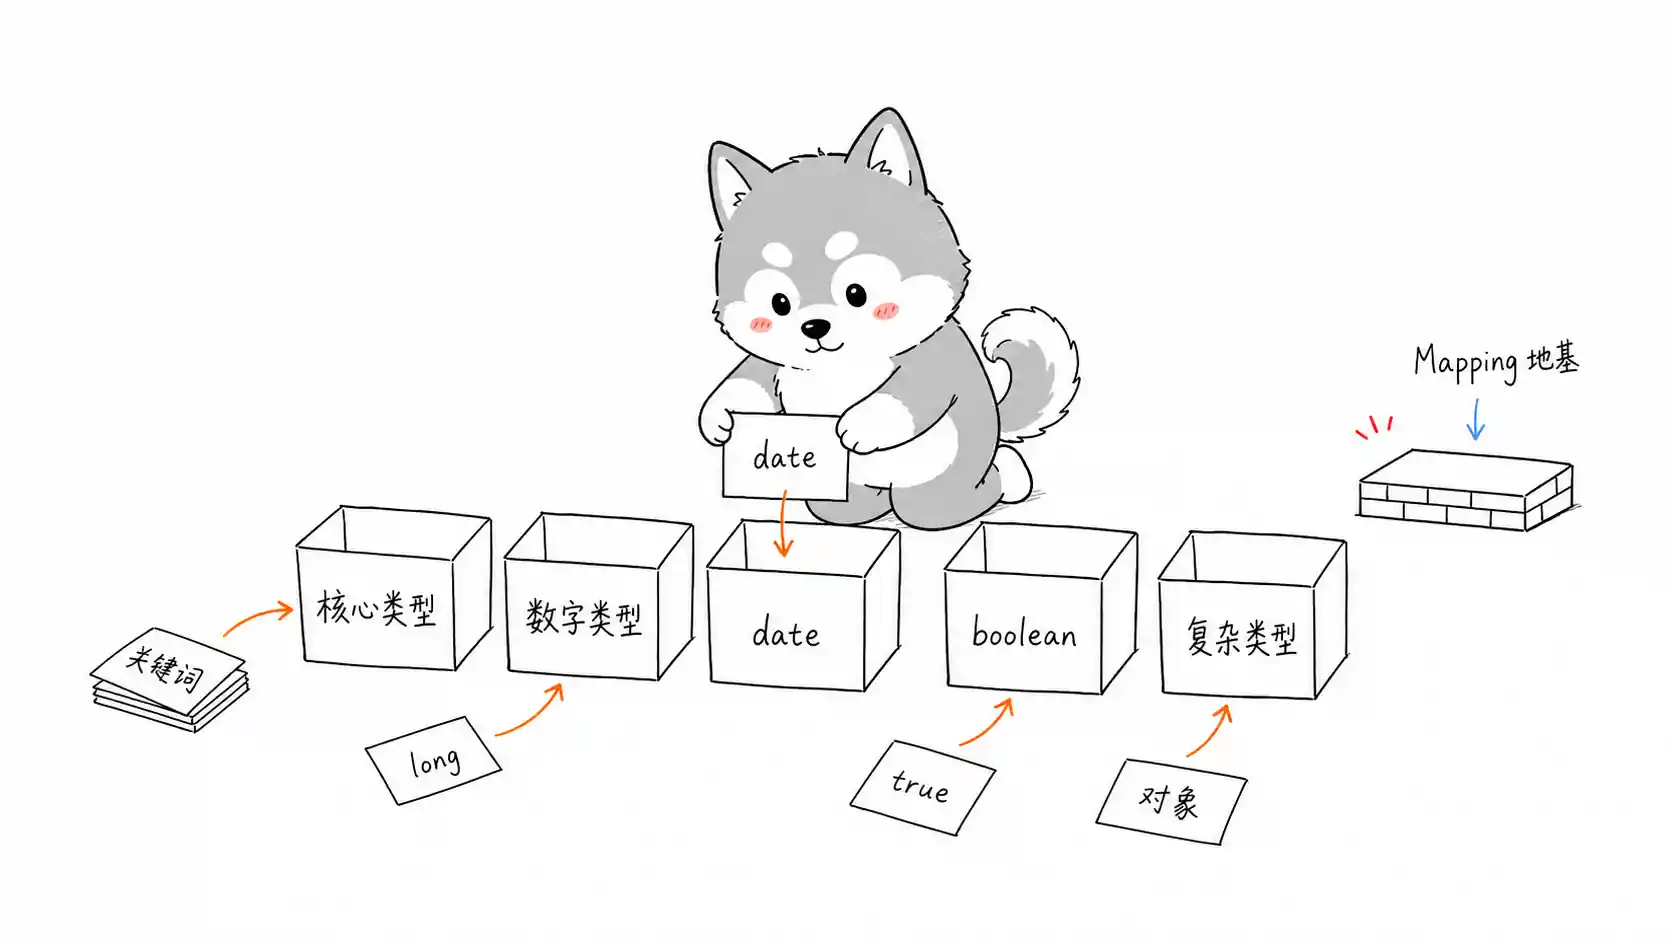
详解 Elasticsearch 支持的数据类型及与 MySQL 的映射关系:text 与 keyword 的区别及组合用法、DECIMAL 用 scaled_float 存金额、nested 与 object 差异、动态映射的坑等生产实践,并附概念映射表与高频面试追问,助你彻底搞懂 MySQL 同步 ES 的类型选型。
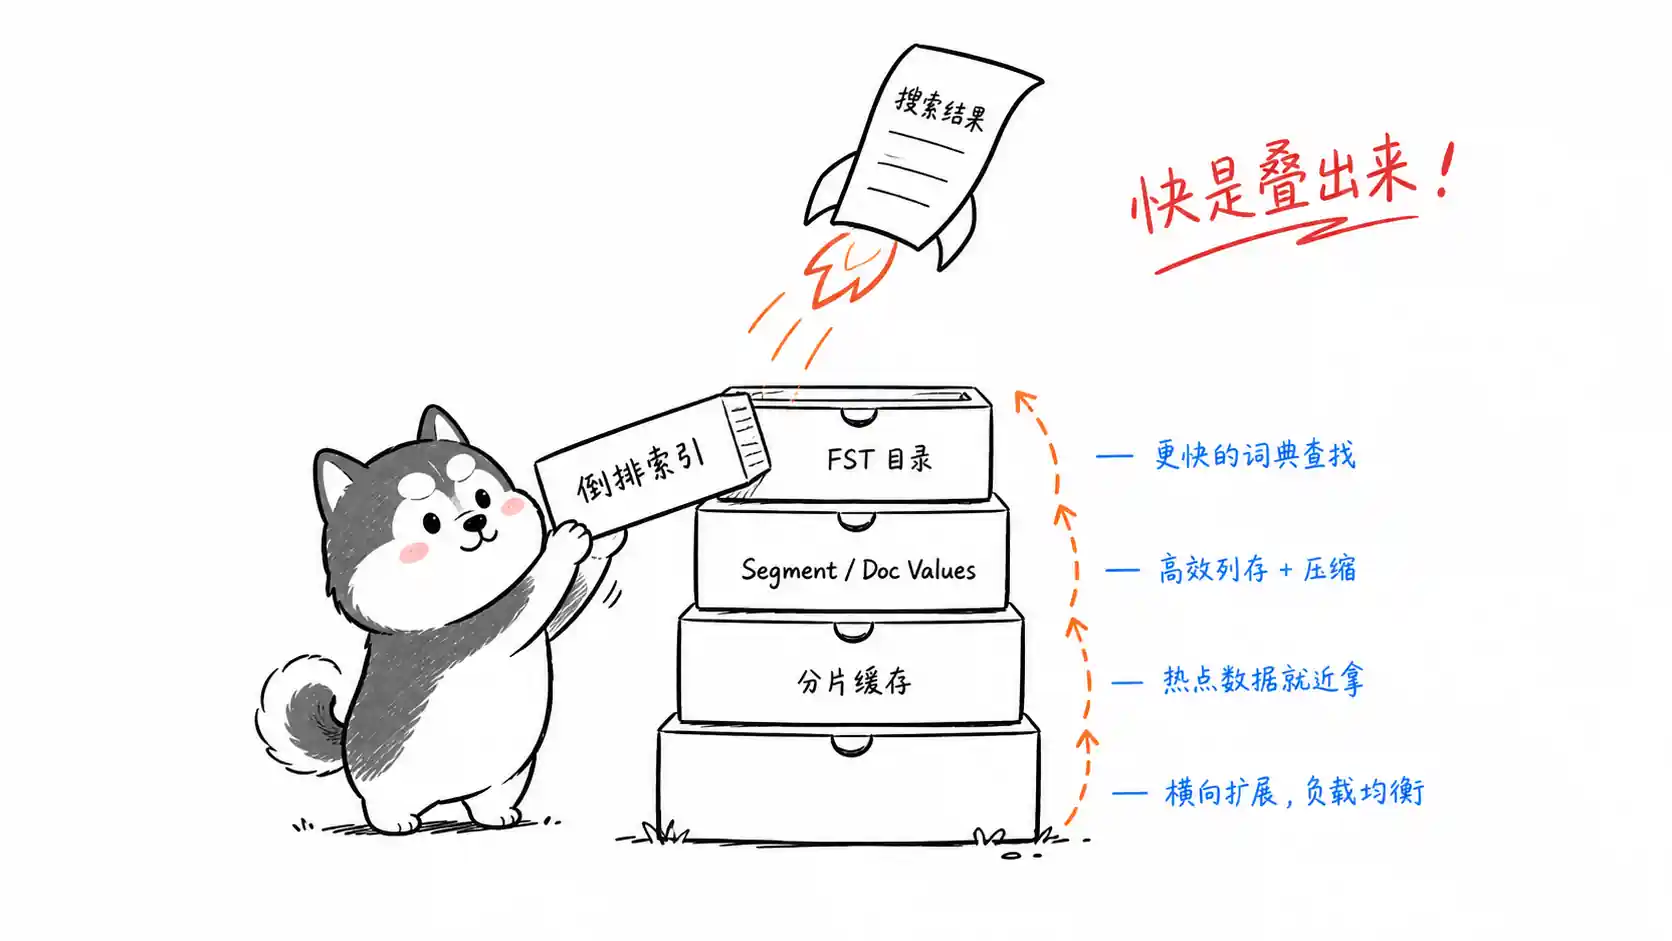
ElasticSearch 为什么快?本文从数据结构、存储、架构三层深入解析:倒排索引跳过全表扫描,FST + Term Index 常驻内存最少一次磁盘寻址,不可变 Segment 与 Doc Values 列式存储吃满缓存,分片并行与缓存体系支撑高并发,NRT 近实时实现 1 秒可见性。附高频追问与面试变体,助你面试通关。
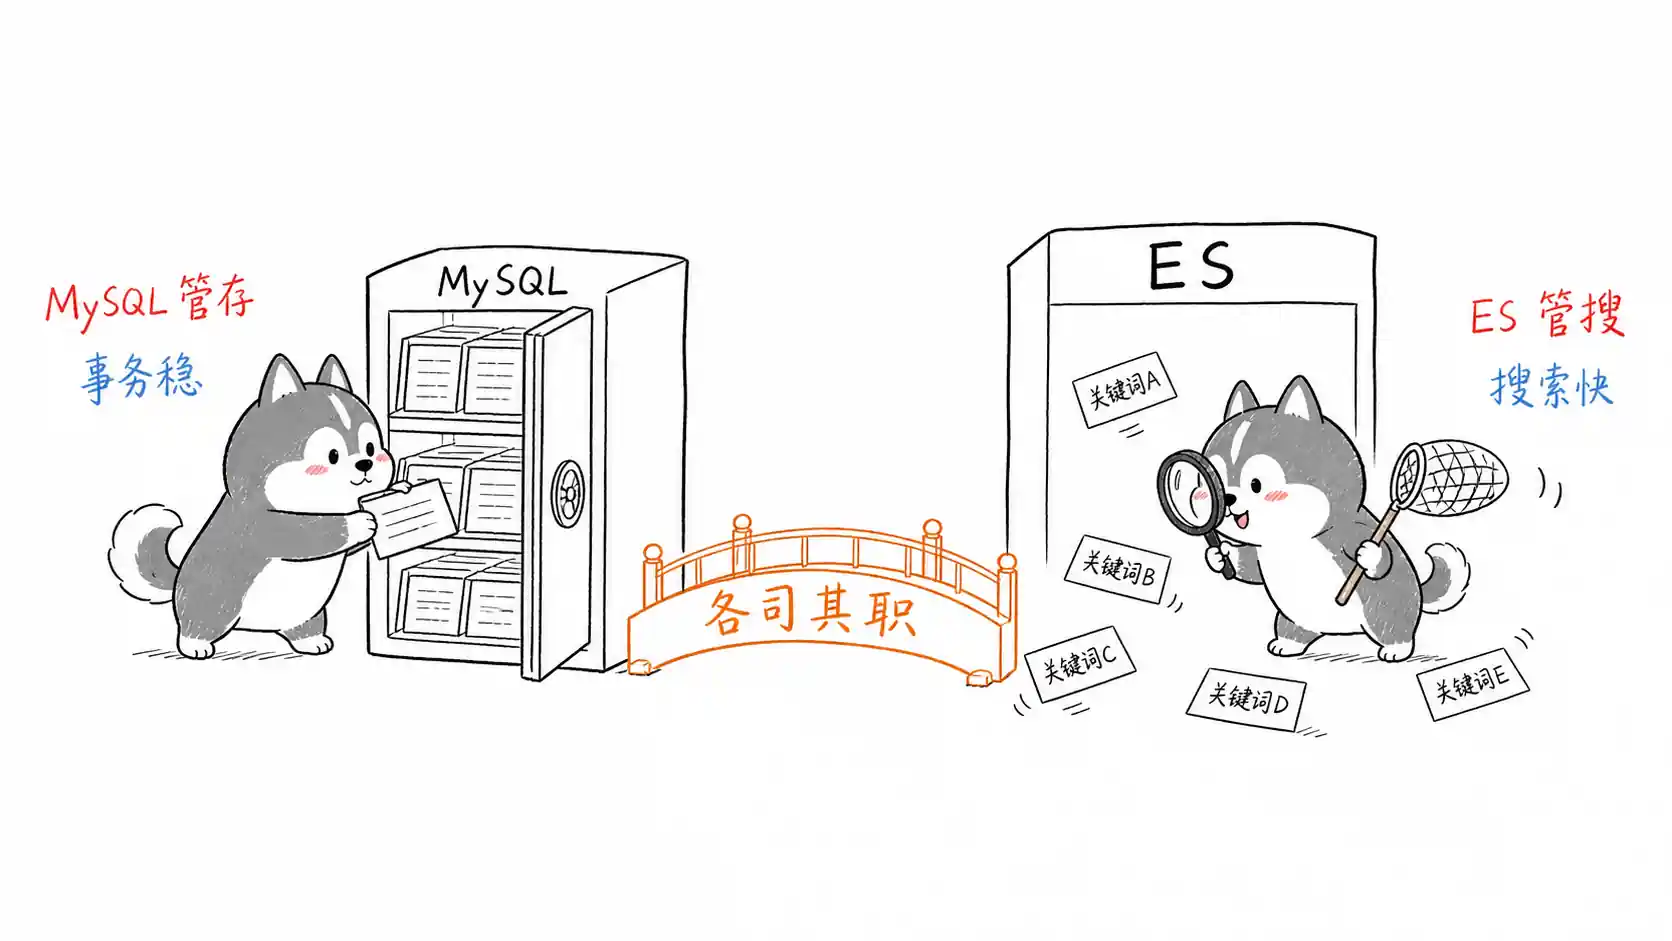
为什么要使用 ElasticSearch?本文详解 ES 与 MySQL 的核心区别:倒排索引对比 B+Tree 索引,模糊搜索 LIKE 索引失效原因,ES 分词、BM25 相关度排序与近实时写入机制,并给出 MySQL 主存储 + ES 搜索引擎的生产架构与 Binlog + Canal 数据同步方案,帮你彻底讲透这道高频面试题。
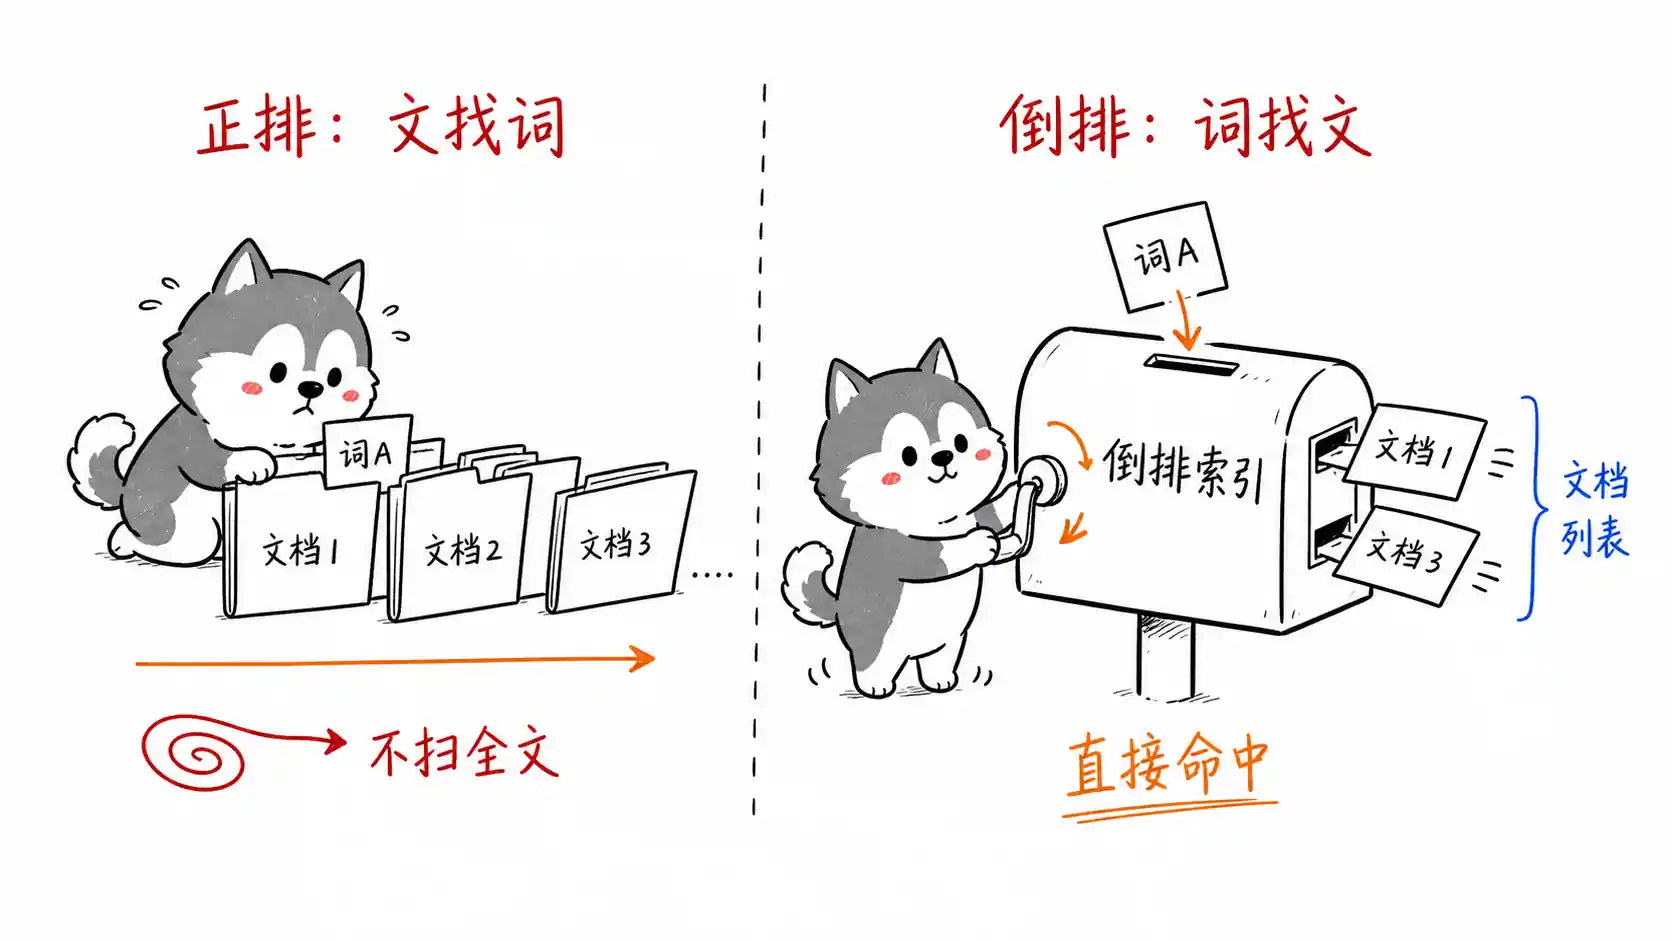
倒排索引是 Elasticsearch 全文检索的核心数据结构,通过“词条→文档列表”的反向映射,实现近乎 O(1) 的关键词查询。本文深入讲解倒排索引与正排索引的区别,剖析 Term Index(FST)、Term Dictionary、Posting List 三层内部结构,以及 FOR 压缩与 Roaring Bitmap 优化原理,并附 Java 实现示例与 ES 面试高频追问,助你彻底搞懂 ES 为什么查询快。
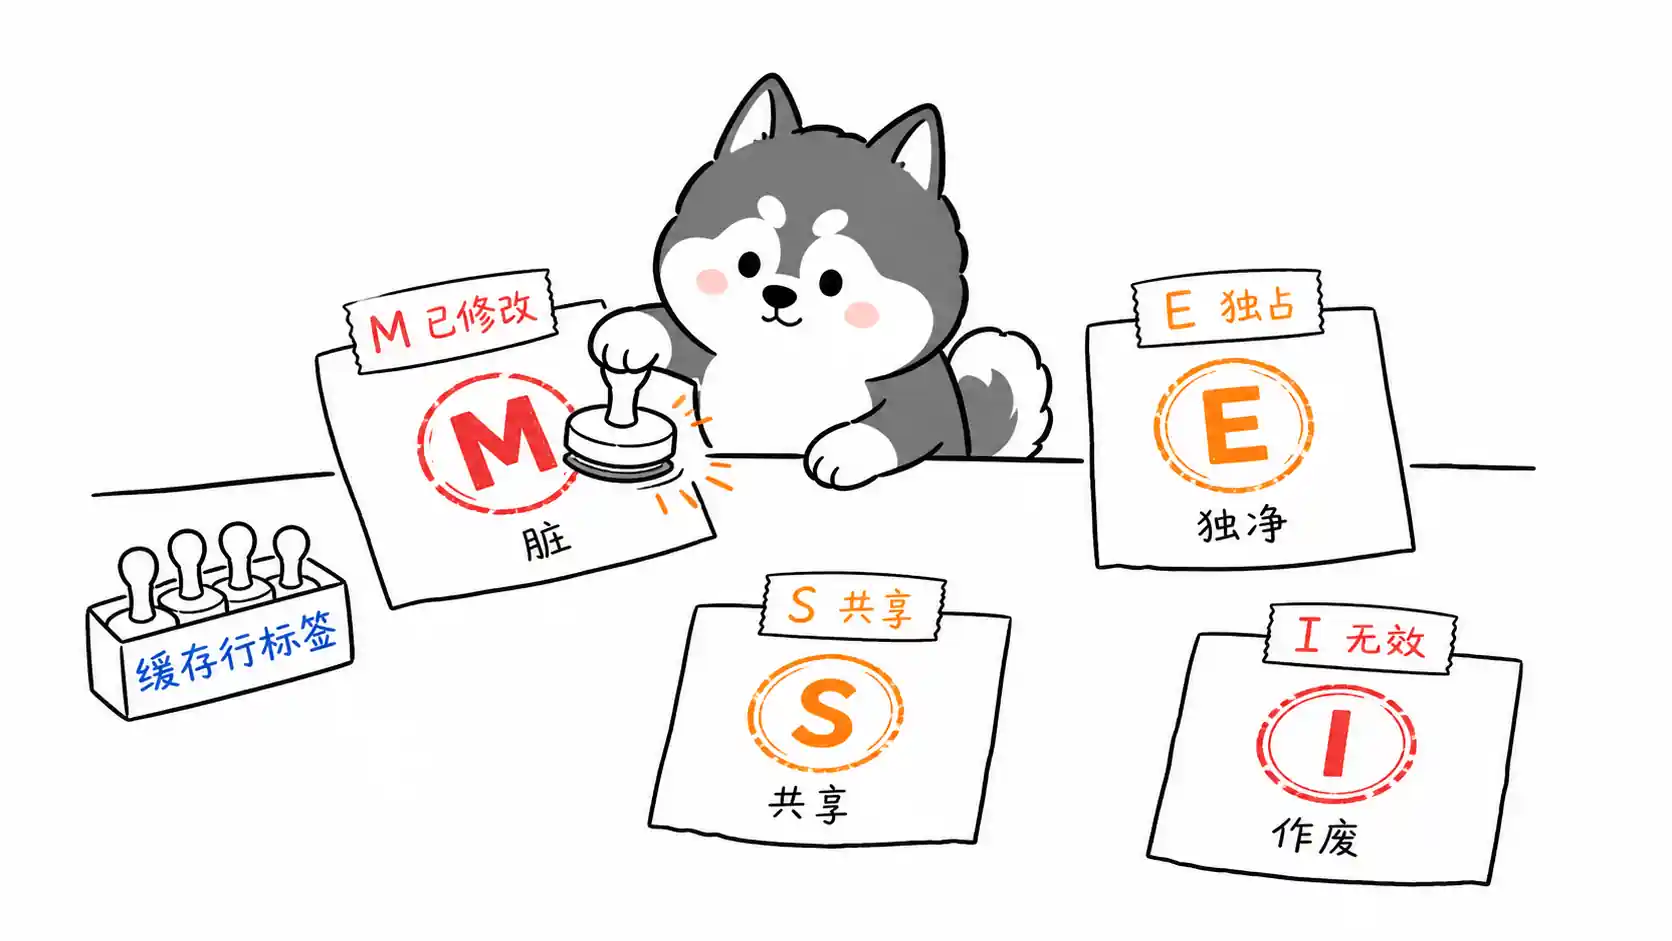
MESI 是主流 CPU 的多核缓存一致性协议,通过 Modified、Exclusive、Shared、Invalid 四种状态配合总线嗅探机制,保证各核心私有缓存中数据副本一致。本文深入讲解缓存不一致问题、状态流转示例、Store Buffer 与内存屏障的关系,并延伸到伪共享、缓存行填充及 volatile 可见性原理,帮你把 Java 并发的硬件底层彻底讲通,面试必备。
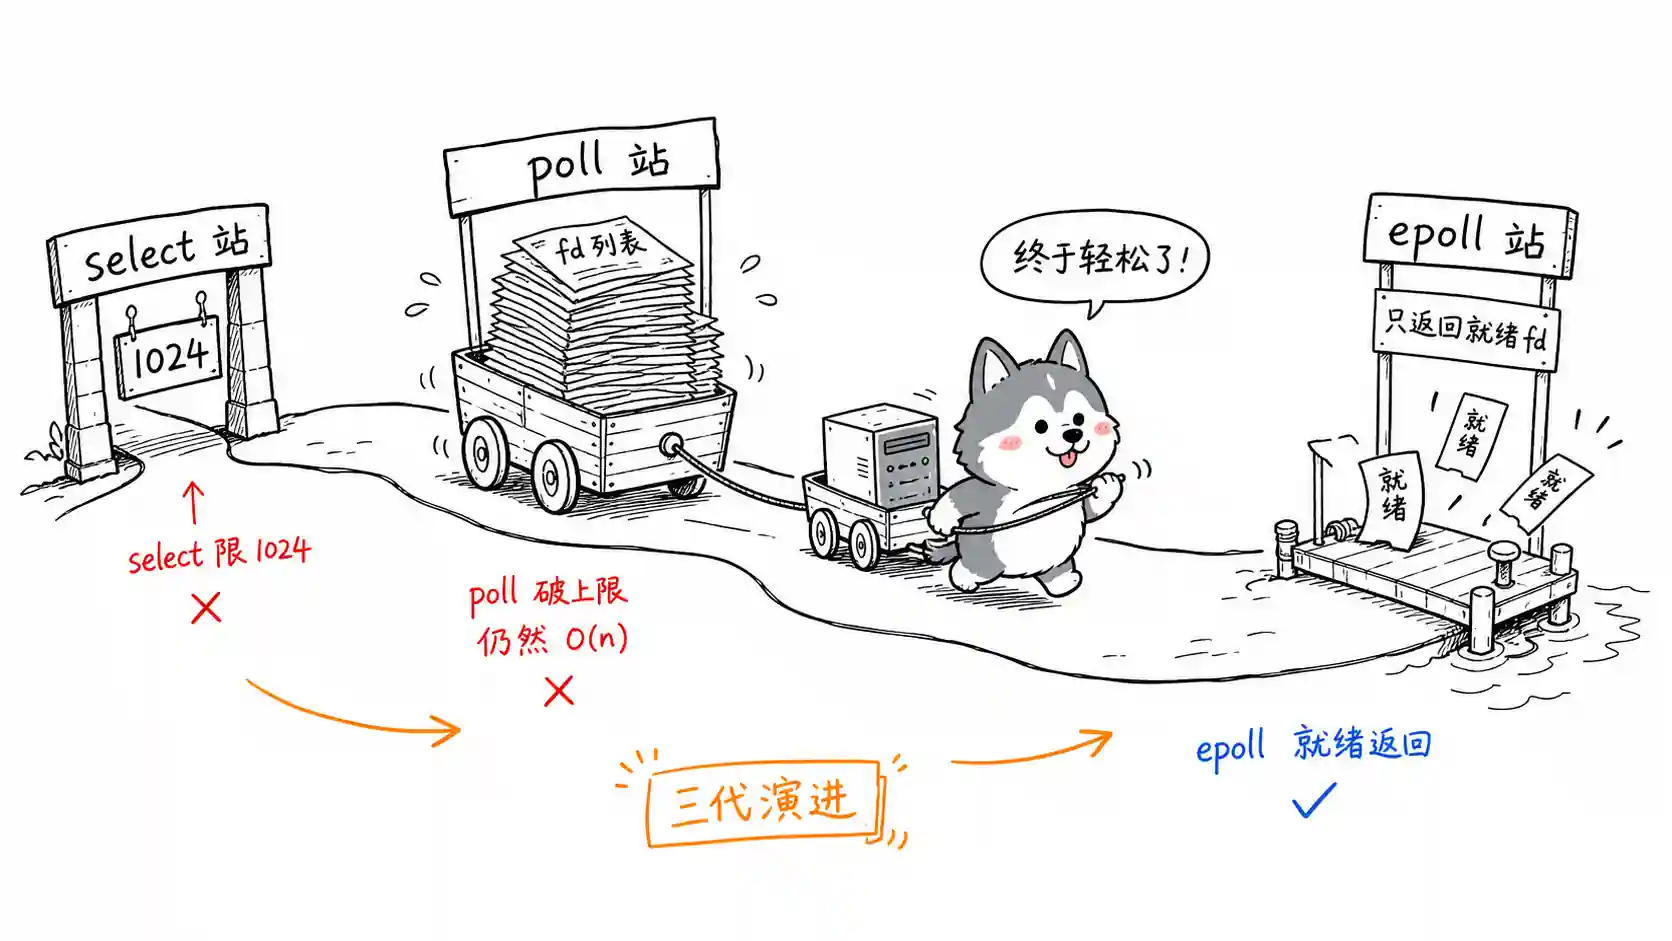
select、poll、epoll 是 IO 多路复用的三大实现方案,核心目标是让单线程监听多个 socket。本文讲清三者演进逻辑:select 有 1024 上限和全量拷贝开销,poll 突破数量限制,epoll 凭红黑树与事件回调解决全量扫描瓶颈,并解析 LT/ET 触发模式,以及 Java NIO、Netty、Redis、Nginx 如何基于 epoll 实现高并发,助你面试从容应对。
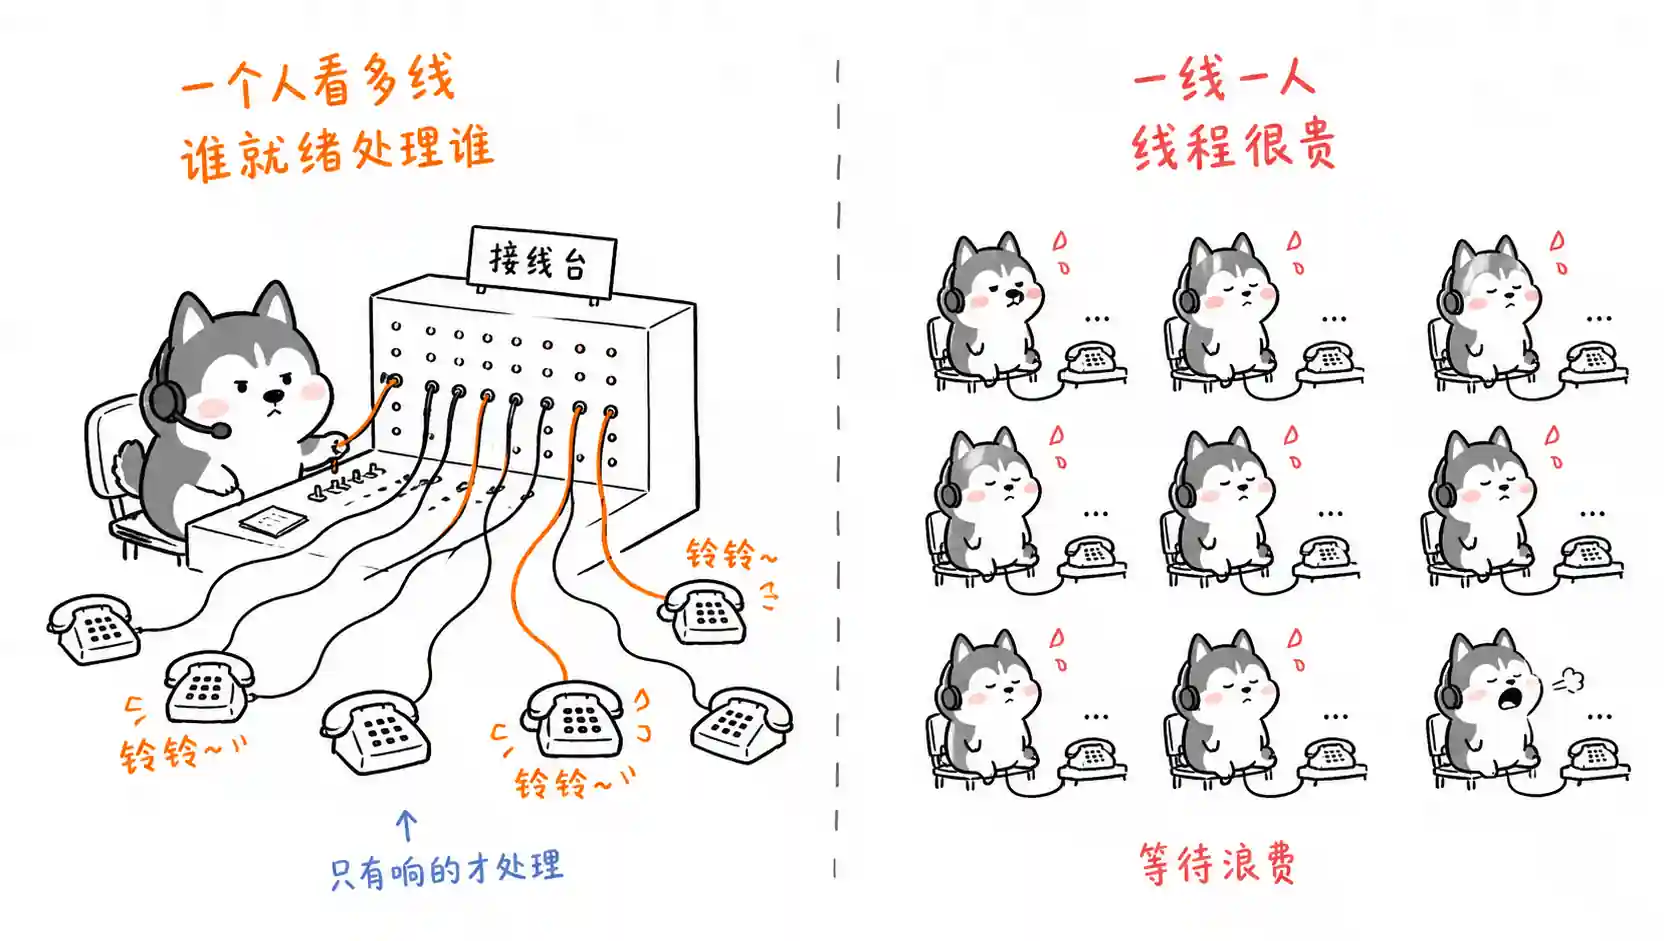
IO 多路复用和多线程有什么区别?本文从面试视角深度解析:多线程解决并发执行、每连接一线程资源消耗大;IO 多路复用(select、poll、epoll)用少量线程高效监听海量连接。涵盖 Java NIO、Reactor 模式、C10K 问题及 Netty、Redis 组合使用实践,帮你彻底搞懂两者的本质区别。
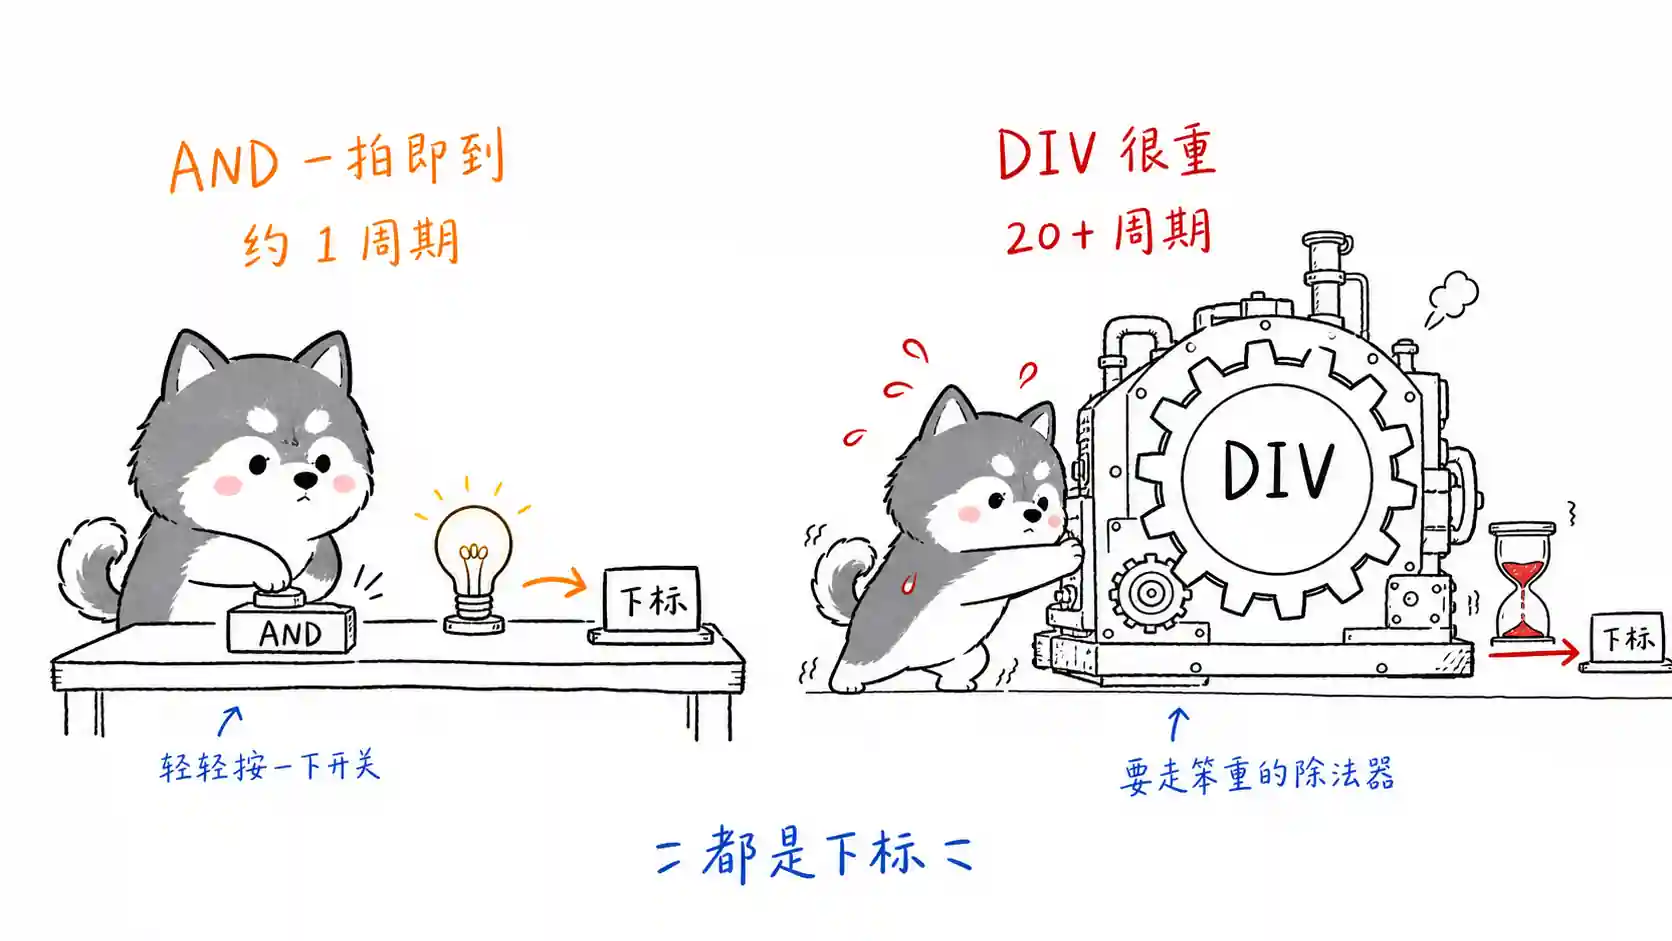
为什么 HashMap 用 (n-1) & hash 而不是 hash % n?核心在 CPU 指令层面:按位与只需一条 AND 指令、约 1 个时钟周期,而取模要走除法器执行 DIV 指令,延迟 20 个周期起步。但等价的前提是容量必须为 2 的幂,这也是 HashMap 强制 2 的幂容量的根本原因。本文从 CPU 指令、数学原理、源码落地与 JIT 优化边界层层拆解,助你面试满分。