如何优化 ElasticSearch 搜索性能?
一则或许对你有用的小广告
欢迎加入小哈的星球,你将获得:专属的实战项目(4个项目都能学) / 1v1 提问 / 简历修改 / Java 学习路线 / 社群讨论 / 学习打卡 / 每月赠书
《Spring AI 项目实战(问答机器人、RAG 智能客服、联网搜索)》已完结,基于
Spring AI + Spring Boot 3.x + JDK 21...,查看介绍《从零手撸:仿小红书(微服务架构)》 已完结,基于
Spring Cloud Alibaba + Spring Boot 3.x + JDK 17...,查看介绍;演示链接:http://116.62.199.48:7070/《从零手撸:前后端分离博客项目(全栈开发)》 2 期已完结,演示链接:http://116.62.199.48/
新开坑项目:《从零手撸:秒杀系统高并发优化实战》 正在更新中...,查看介绍
截止目前,星球内专栏累计输出 150w+ 字,讲解图 5110+ 张,还在持续爆肝中.. 后续还会上新更多项目,已有 4700+ 小伙伴加入学习,欢迎点击围观
面试考察点
-
生产实践意识:背几个调优参数谁都会,面试官真正想确认的,是你有没有在生产环境踩过坑。ES 的坑大多藏在真实流量里,没运维过集群的人很难答出细节。
-
体系化思维:搜索性能涉及硬件、JVM、分片设计、Mapping 建模、查询写法五个层面,能不能分层展开、按优先级排序,直接体现你的架构思维。
-
原理 + 权衡:比如 filter 为什么比 query 快、深分页为什么慢、副本数为什么不是越多越好,这些点背后都是 Lucene 的倒排索引原理和分布式查询模型,答得出原理才是真懂。
核心答案
先给结论:ES 搜索性能优化按 “收益从高到低” 排序,主要抓下面这几层。
| 优化层 | 核心手段 | 预期收益 |
|---|---|---|
| 文件系统缓存 | 内存至少留一半给 OS Cache,用 SSD | ⭐⭐⭐⭐⭐ |
| 查询写法 | filter 替代 query、避免左模糊、解决深分页 | ⭐⭐⭐⭐⭐ |
| 分片策略 | 单分片 10~50GB,避免过度分片 | ⭐⭐⭐⭐ |
| Mapping 建模 | 用 keyword 精确匹配、避免 nested、禁用不需要的特性 | ⭐⭐⭐ |
| 写入与合并 | 调大 refresh_interval、只读索引 force merge |
⭐⭐⭐ |
一句话兜底:ES 的搜索本质是 Lucene 段文件加分布式扇出查询,所有优化都是奔着两个目标去的:让数据尽量待在内存里,让每次查询尽量少干活。
深度解析
一、文件系统缓存:最容易被忽视的第一优先级
很多人一上来就聊查询 DSL,其实方向错了。ES 的底层是 Lucene,而 Lucene 的段文件设计就是假设 “大部分热数据在操作系统的文件缓存里”。搜索请求打到磁盘上,性能直接掉一个数量级。
先看一张 ES 搜索的内存结构图:
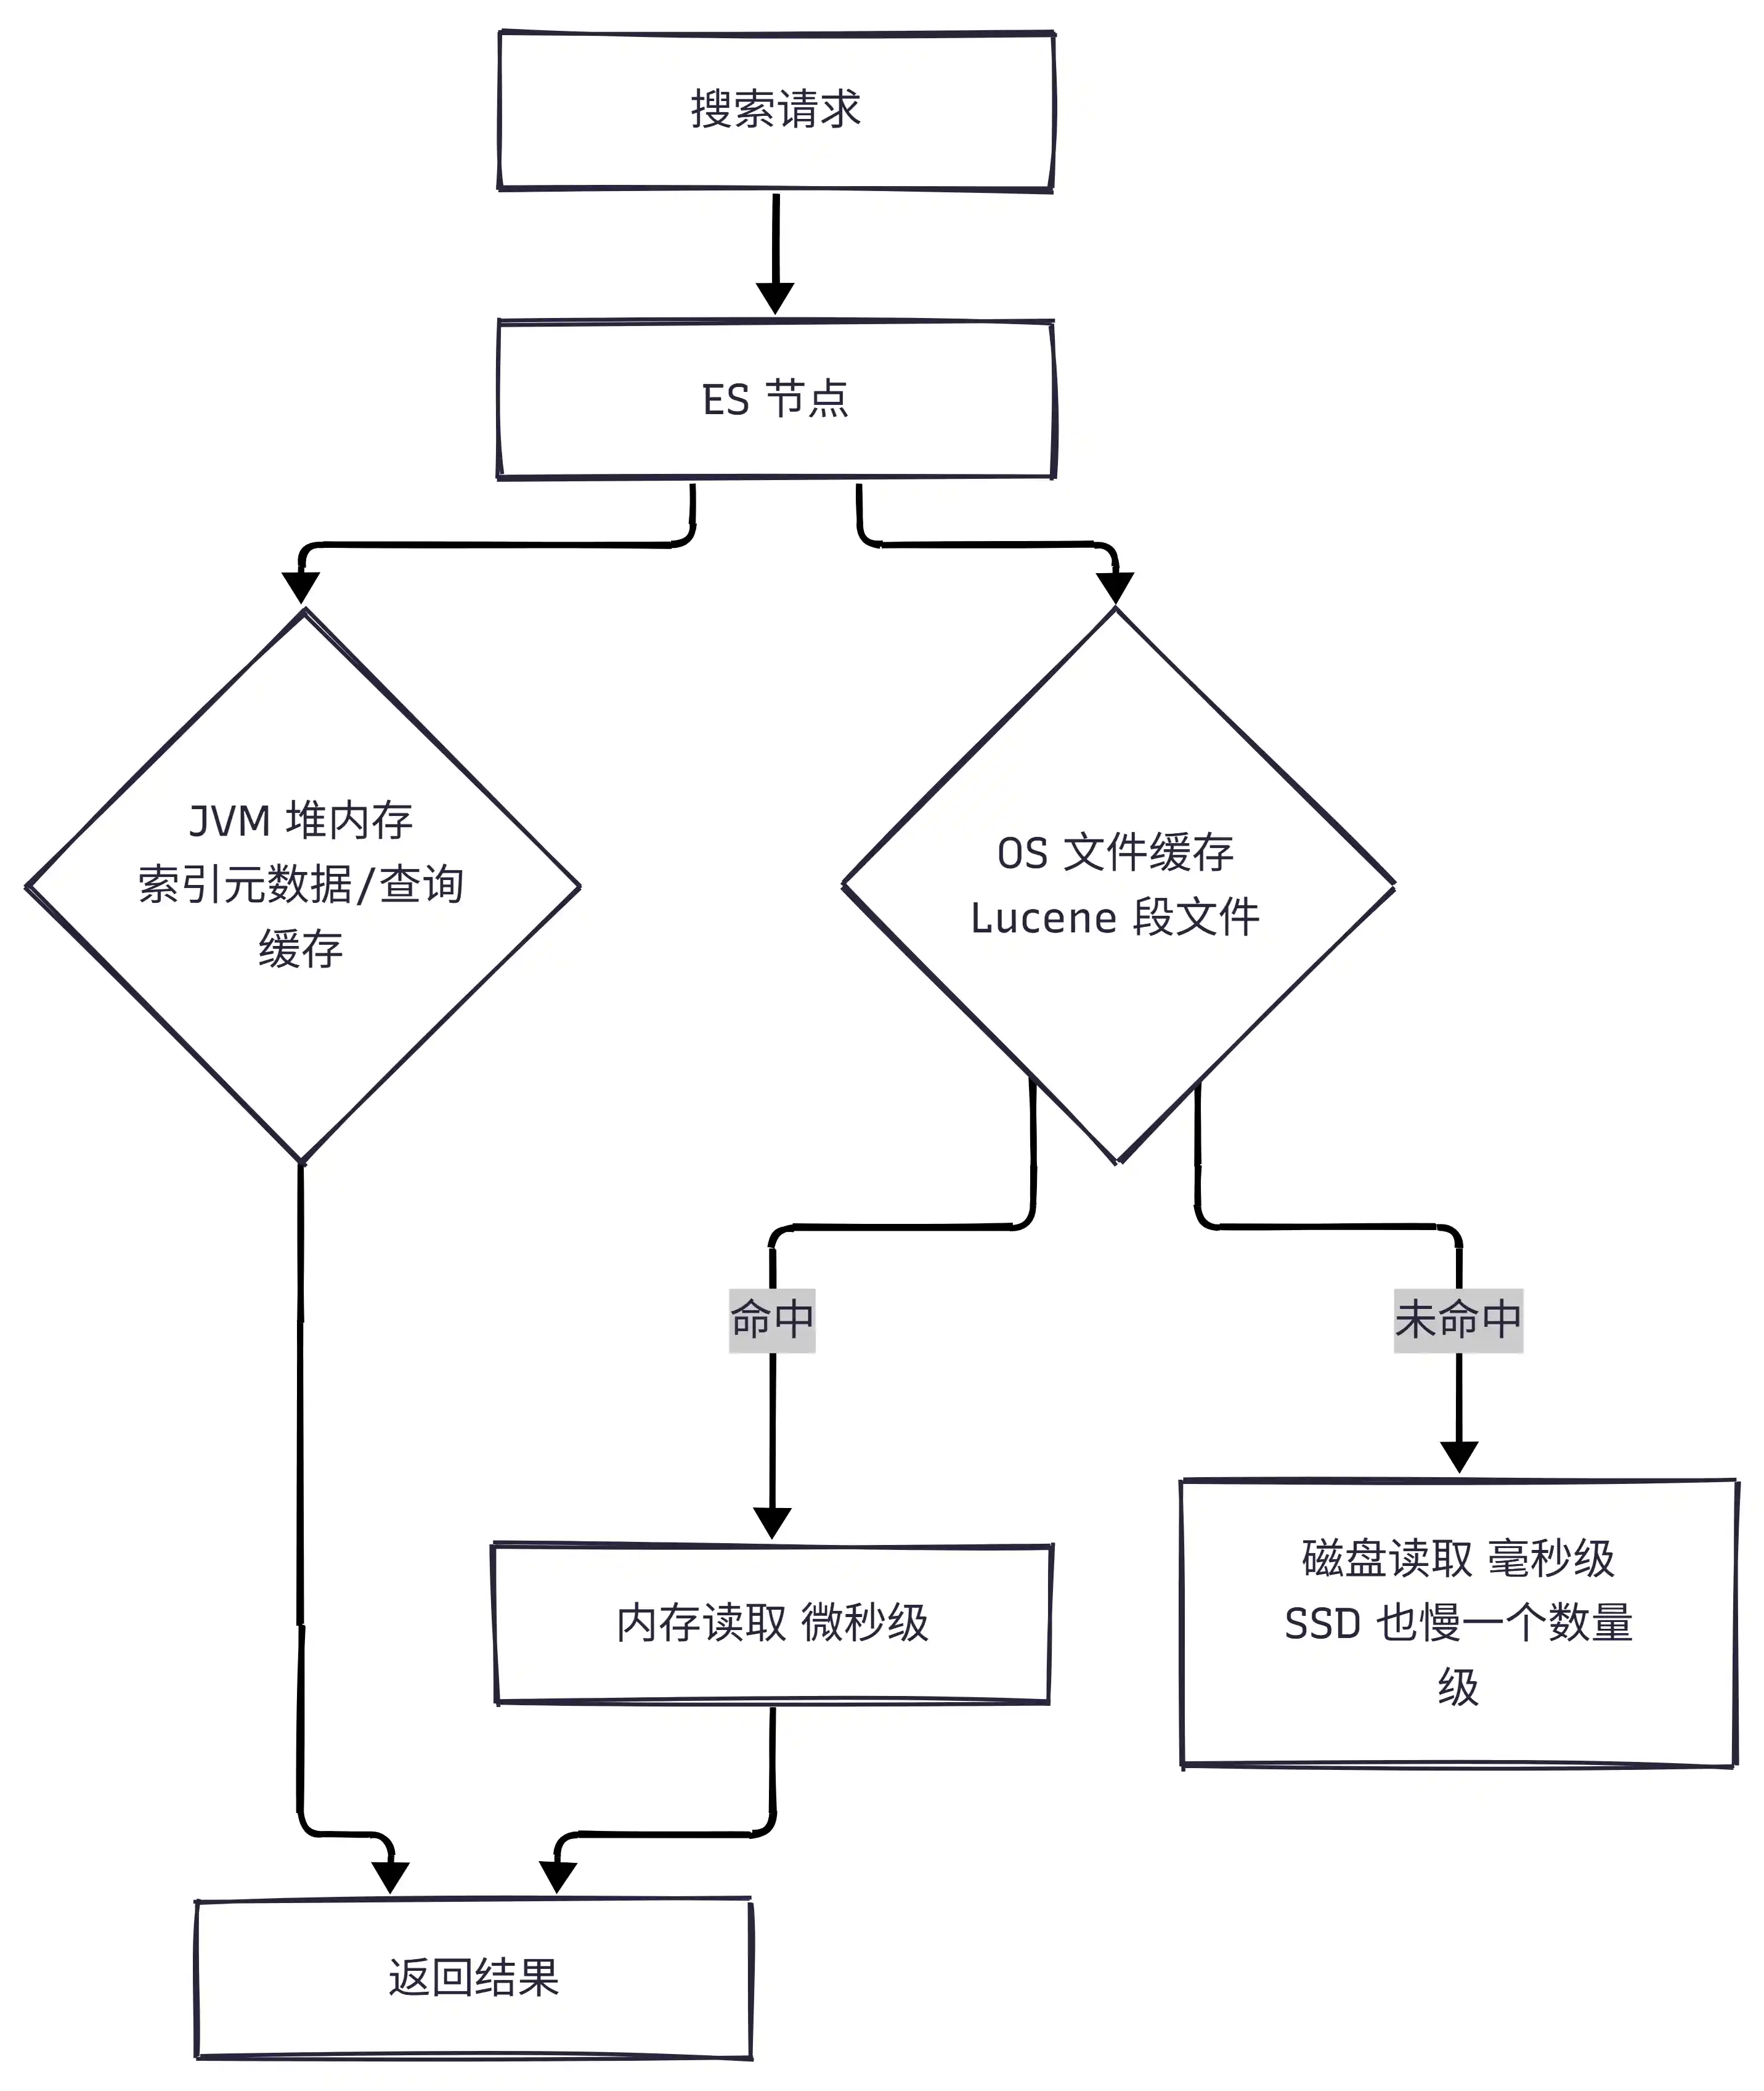
上图说的是 ES 节点上的两层缓存:
- JVM 堆内存:存索引元数据、节点级查询缓存(node query cache)等,空间有限
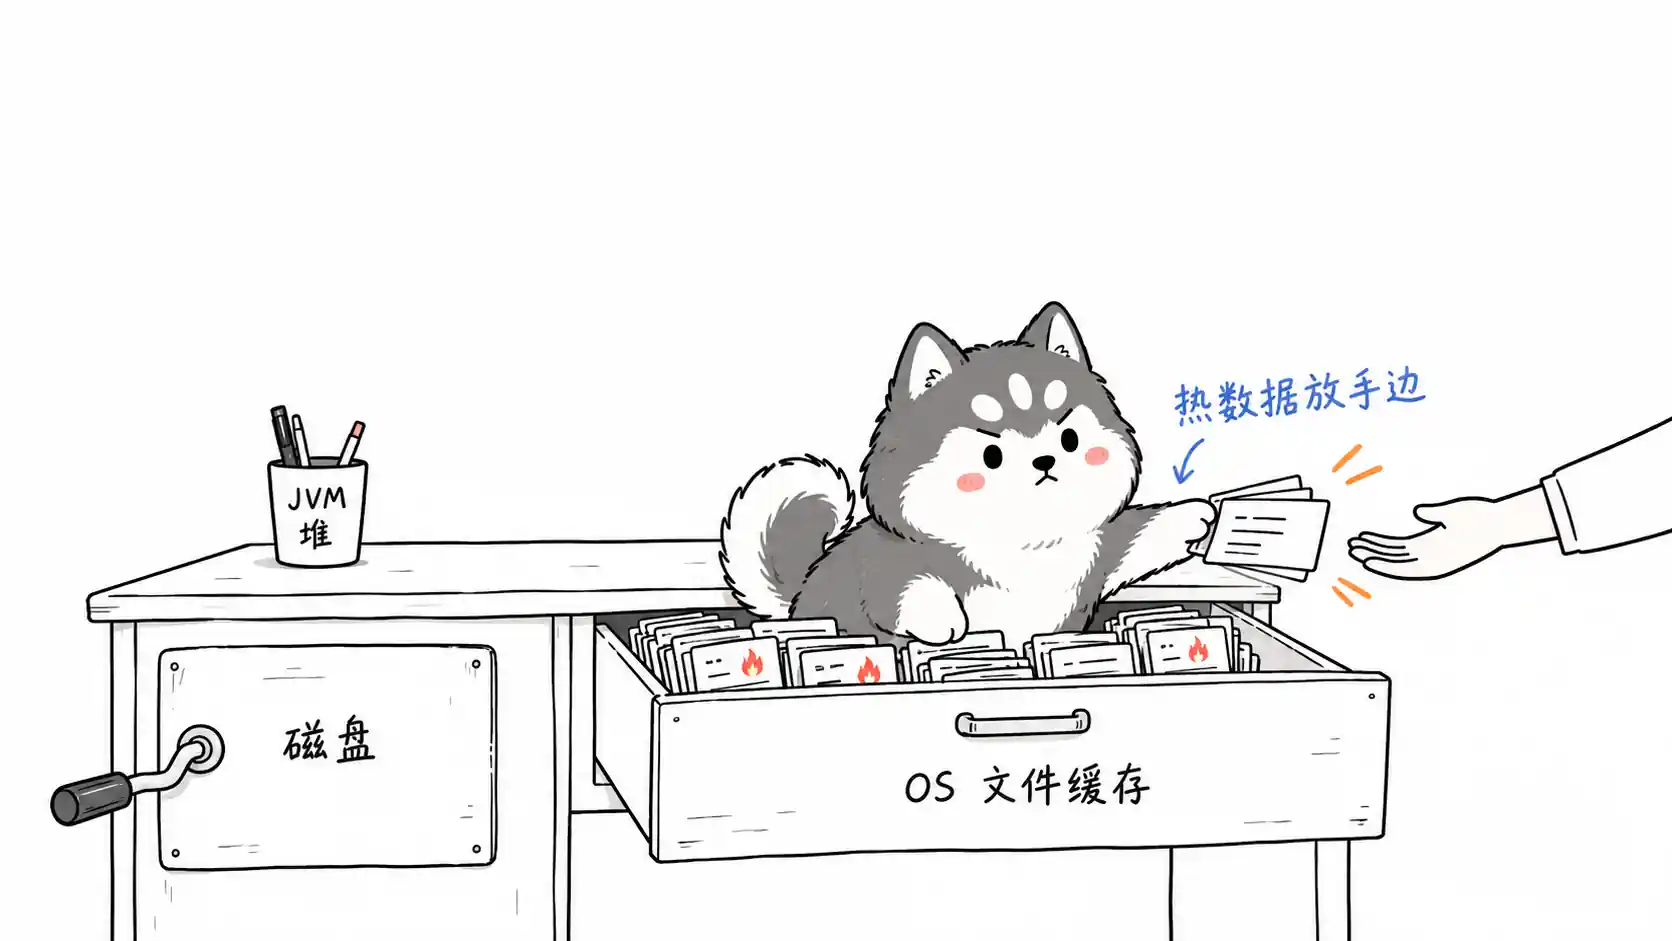
- OS 文件缓存:存 Lucene 段文件的实际数据,这才是搜索的主战场,够不够大直接决定性能
所以官方给的建议很直接:至少把机器一半的内存留给文件系统缓存。假设一台 64GB 的机器,JVM 堆给到 31GB 左右,剩下的全部留给 OS。当年我们有个项目查询 QPS 一上量就抖动,折腾了半天查询写法没效果,最后发现是堆内存给太多,把文件缓存挤没了——这种坑,不踩一次真记不住。
配套动作:用 SSD、关闭 swap 交换(bootstrap.memory_lock: true 锁住内存)。
二、分片策略:不是越多越好
先理解一个查询的扇出模型:
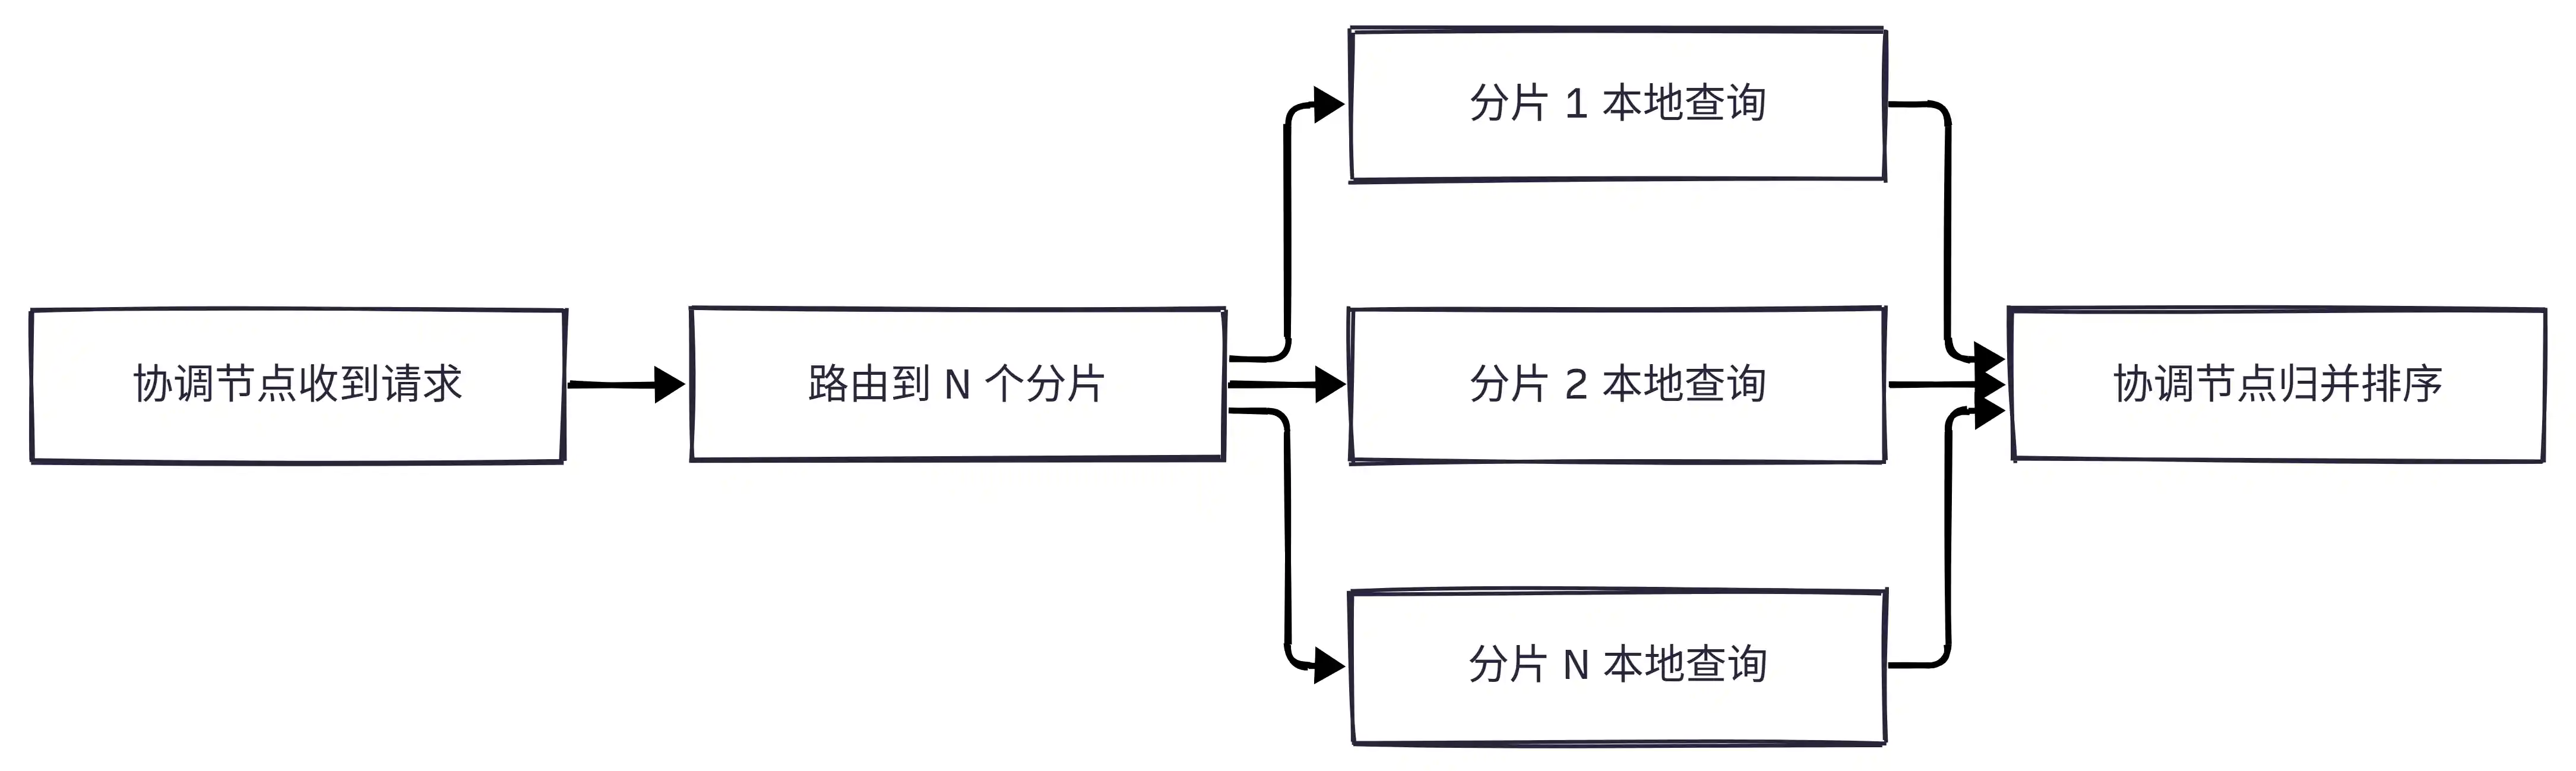
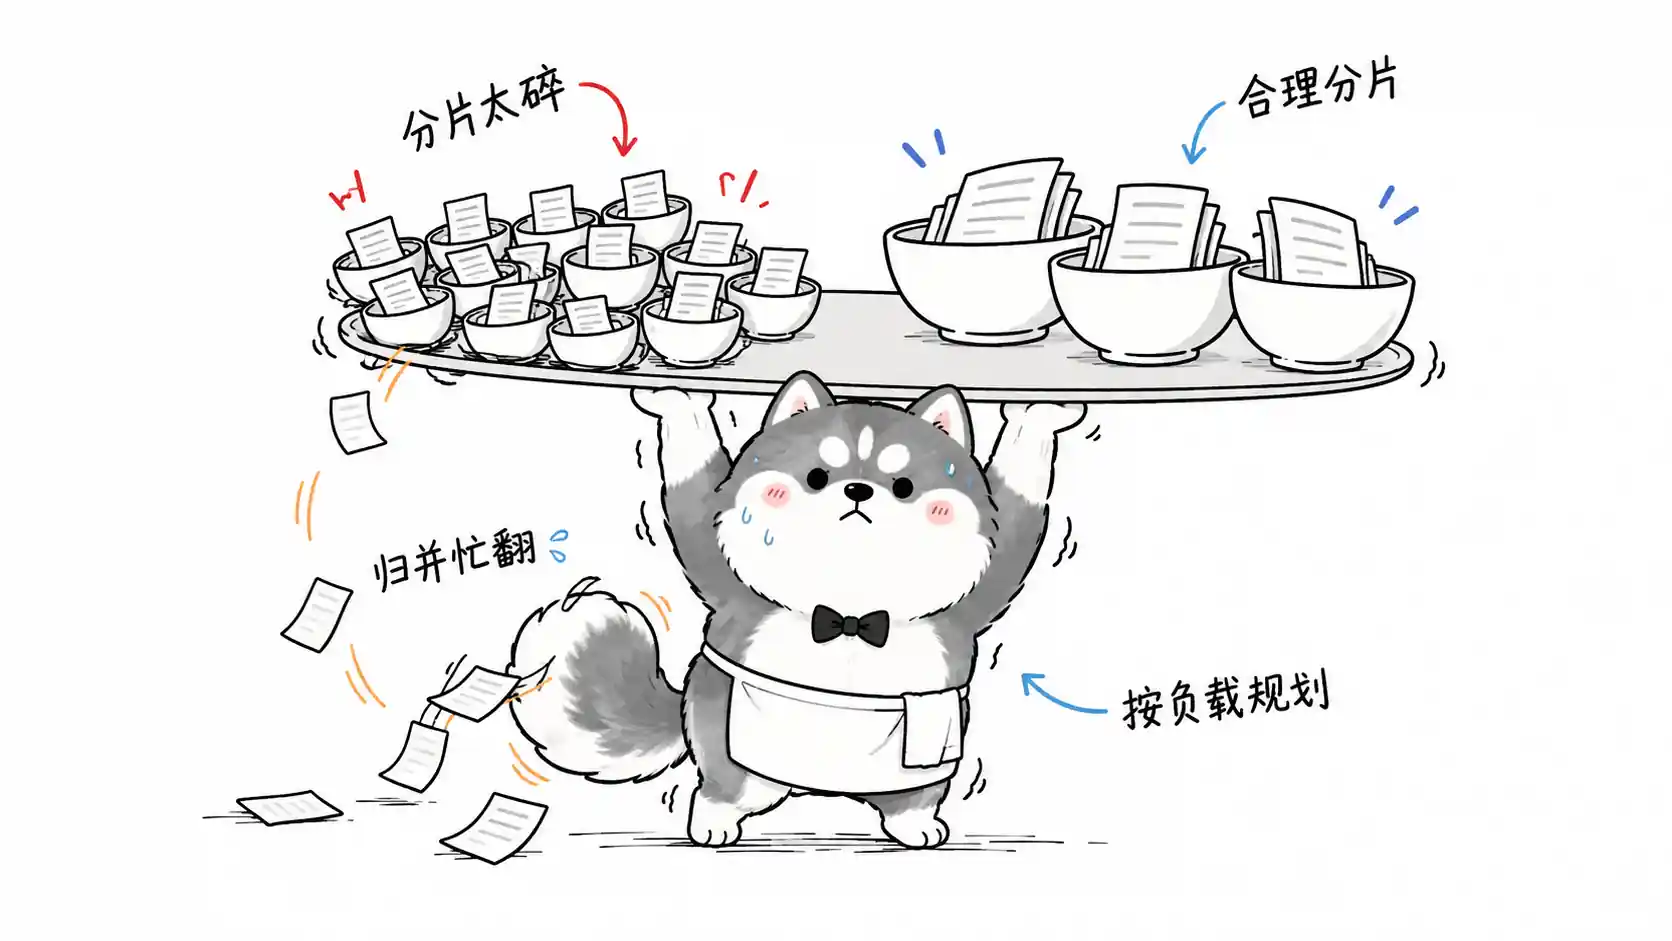
一次搜索会同时打到索引的每个分片上,每个分片本质上是一个独立的 Lucene 实例。这个模型决定了两个铁律:
- 分片数 = 单次查询的并行扇出数,分片太少,单分片过大,查询和恢复都慢
- 分片过多,协调节点的归并开销、每个分片的元数据内存占用都会放大,集群整体会被拖垮
生产经验值:
- 单分片控制在 10~50GB,且单分片文档数别超过 2 亿(Elastic 官方建议)
- 分片数量上限:老版本(8.3 之前)流传 “每 GB 堆内存不超过 20 个分片” 的算法,比如 31GB 堆全集群最多 620 个分片;但这条规则官方在 8.3 已经废弃,现在的建议更简单——单节点分片数控制在 1000 以内,重点盯分片大小
- 分片数在创建索引时就定了(不重建索引改不了),一定要按数据量提前规划
- 副本数不是越多越好:读多写少加副本分担读压力,但每个副本都拖慢写入,一般 1~2 个够了
三、查询写法优化:日常收益最大的部分
1. 不需要算分的条件,全部放进 filter
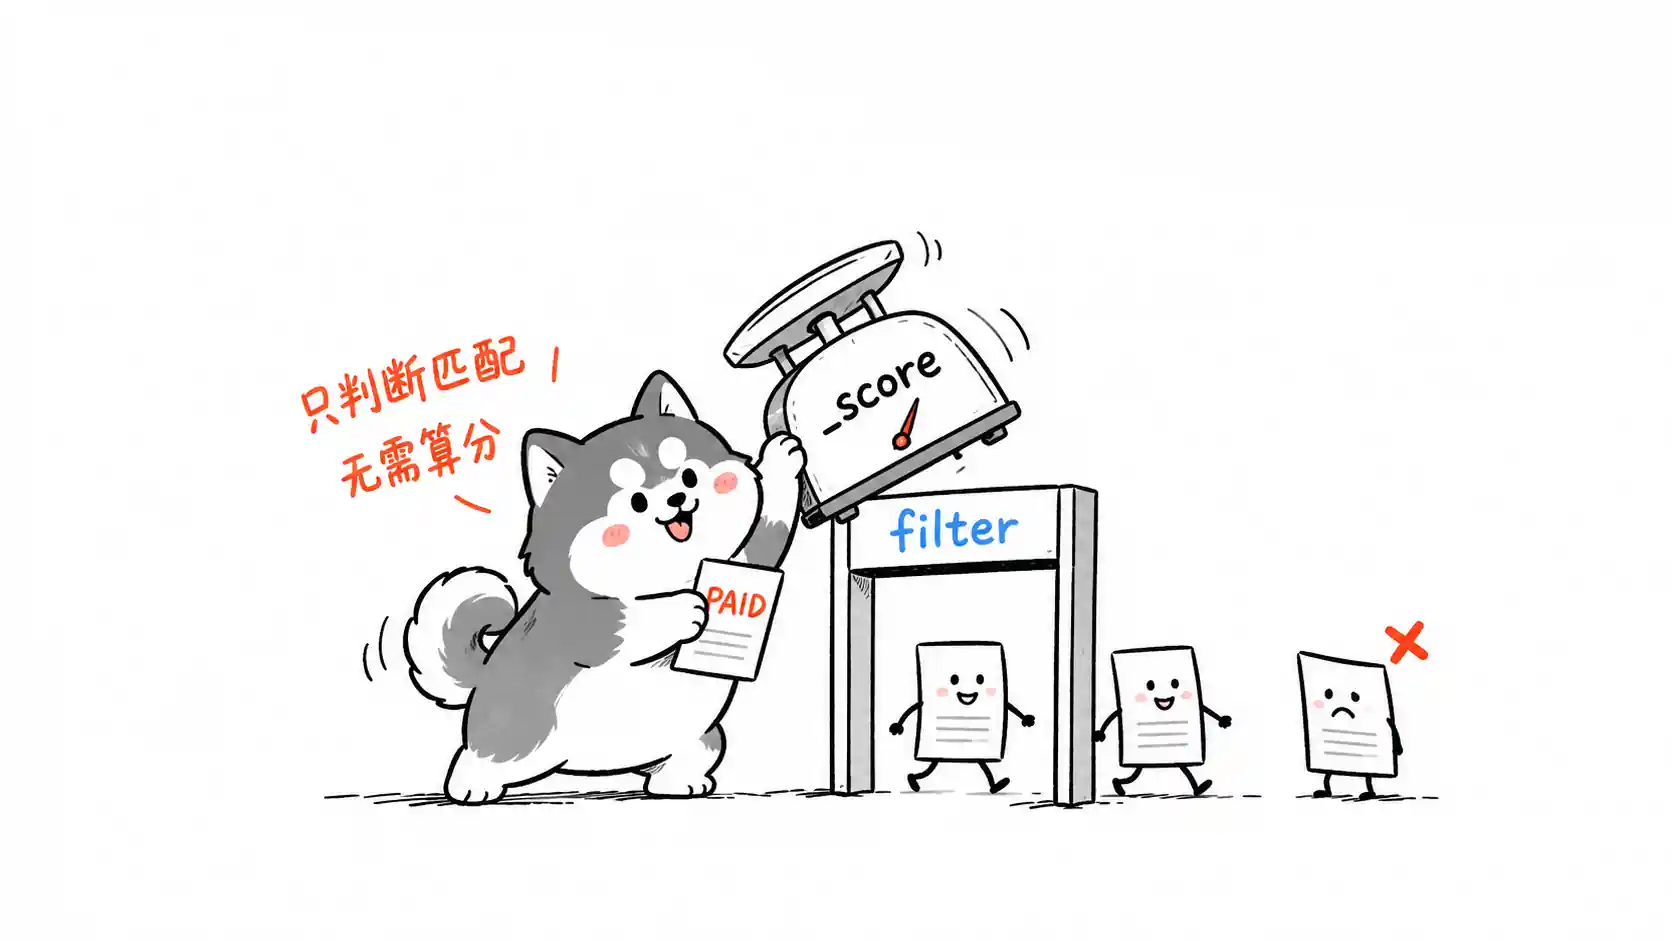
这是我最想安利的一条。query context 的每个条件都要参与相关性算分,而 filter context 只判断 “匹配 / 不匹配”,结果还能被节点级缓存(按段缓存),第二次查询基本白捡。
GET /order/_search
{
  "query": {
    "bool": {
      "must": [
        { "match": { "productName": "手机" } }
      ],
      "filter": [
        { "term": { "status": "PAID" } },
        { "range": { "createTime": { "gte": "2026-01-01" } } }
      ]
    }
  }
}
上面这段 DSL 里,productName 的全文检索放 must 里算分,status、时间范围这种不需要评分的条件全放 filter。很多团队的接口就是把所有条件堆在 must 里,改一行结构,P99 能降一大截。
2. 精确匹配用 keyword,别用 text
text 类型会分词,倒排索引里存的是切出来的词项;keyword 不分词,整串建索引。状态值、订单号、枚举这类字段,用 text 去 match 就是自讨苦吃。常用做法是 multi-field,一个字段两种类型各建一份:
"productName": {
  "type": "text",
  "fields": {
    "raw": { "type": "keyword" }
  }
}
3. 坚决避免左模糊通配
*手机 这种前置通配,Lucene 没法利用倒排索引的词项有序性,只能全量扫词项,数据量一大直接把集群打跪。真有模糊搜索需求,上 wildcard 类型字段(ES 7.9+),或者干脆用 ngram 分词器预处理。同理,match_phrase 比 term 慢、脚本查询(script / script_score)能不用就不用。
4. 深分页:from + size 模式的天花板
默认 index.max_result_window 是 10000,翻到第 500 页时协调节点要从每个分片拉 500×pageSize 条数据回来归并,内存和 CPU 都是灾难。方案对比:
| 方案 | 原理 | 适用场景 |
|---|---|---|
from + size |
各分片取 top N 归并 | 浅分页(前几十页) |
scroll |
快照批次拉取 | 离线全量导出 |
search_after + PIT |
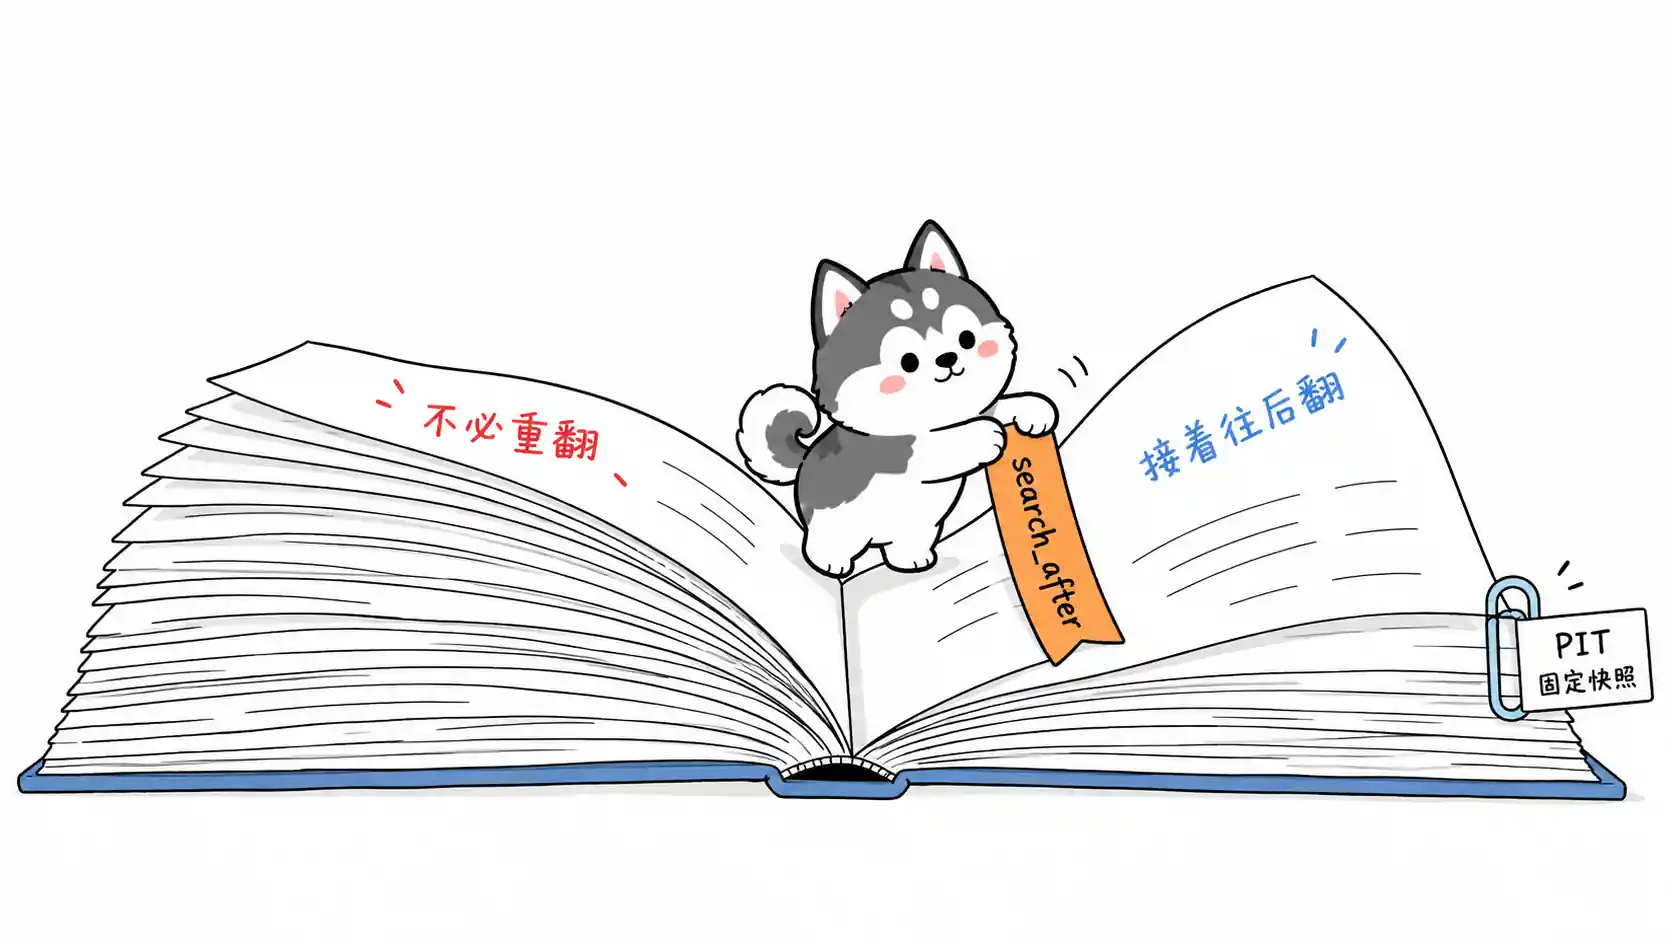
用上一页排序值做游标 | 线上实时深翻页(推荐) |
scroll 是历史快照,数据不实时而且占资源,官方现在也不推荐给用户请求用;线上导出、滚动加载这种场景,search_after 配合 Point In Time(ES 7.10+)才是正解。
5. 其他小动作,个个不亏
- 只取需要的字段:
_source过滤或者fields参数,别把整个文档拖回来,尤其大字段 - 用
_id直查:按文档 ID 取数据走路由直达分片,别写成term查询去扇出 - 索引排序(index sorting):ES 6.0+ 支持按指定字段物理排序,提前终止(early termination)可以让某些查询不用扫完全部文档
四、Mapping 与文档建模:省掉无谓的开销
- 避免 nested 嵌套:nested 查询底层是子文档展开(每个嵌套对象是独立 Lucene 文档),查询成本随嵌套数量指数级上升。能反范式拍平就拍平,ES 是 NoSQL,别拿关系型思维建模
- 索引前想清楚:不需要检索的字段设
"index": false,不需要聚合排序的 text 不开fielddata(这是堆内存杀手) - 控制字段数量:一个索引几百上千个字段,元数据本身就能把查询拖慢
- 避免动态映射失控:
dynamic设成strict或false,防止脏数据随便造字段
五、写入与段合并:从源头减少查询负担
- 调大
refresh_interval:默认 1 秒,近实时搜索的代价是频繁生成小段。小段越多,查询时要打开的文件描述符和合并的候选就越多。日志类场景调到 30s 甚至更长,搜索反而更快 - 批量导入时副本设 0:先
"number_of_replicas": 0灌数据,导完再改回来,写入速度能翻倍 - 只读索引用 force merge:历史索引不再写入,
_forcemerge?max_num_segments=1把段合并成一个,查询时上下文切换开销降到最低,还能释放磁盘
六、JVM 层面:一条红线
堆内存不超过 32GB(准确说压在 31GB 以内)。一旦超过,JVM 会退回未压缩的普通对象指针,指针占用翻倍,可用堆反而变少。这个坑很反直觉。另外堆也别给太满,还是那句话:留给 OS Cache 的内存同样是 ES 的 “半个引擎”。
面试高频追问
-
追问一:filter 比 query 快在哪?
两个层面:一是不算相关性得分,省掉整个打分流程;二是结果可缓存(node query cache,按段缓存),同样的过滤条件第二次查询直接命中。
-
追问二:ES 深分页有哪几种方案?各自的问题是什么?
from + size浅分页;scroll适合离线导出但基于历史快照且占资源;search_after+ PIT 适合线上深翻页,缺点是只能顺序翻不能跳页。 -
追问三:分片数怎么规划?已经建好的索引能改分片数吗?
按数据量和单分片 10~50GB 反推;分片数创建后不可改,只能 Reindex 到新索引(或用
_split/_shrink成倍增减)。 -
追问四:refresh、flush、translog 分别干什么?
refresh是段对搜索可见(默认 1s);flush是把文件缓存里的段刷到磁盘并清空 translog;translog是防止未落盘数据丢失的预写日志。
常见面试变体
- “线上 ES 查询突然变慢,你怎么排查?”(slow log → 看缓存命中率 → 看分片分布 → 看段合并和写入压力)
- “ES 写入性能怎么优化?”(bulk、调
refresh_interval、副本 0、错峰 force merge) - “ES 为什么不适合做深分页?底层原理是什么?”
记忆口诀
缓存给足 SSD 快,分片十到五十 GB;不改分就上 filter,深翻页用 search_after;左模糊是毒药,nested 少碰为妙;只读索引进冷备,force merge 一段到老。
总结
ES 搜索优化就一条主线:数据尽量待在内存里,查询尽量少干活。落到操作上,就是把文件缓存和 SSD 给够,查询写法上 filter、keyword 用对,砍掉左模糊和深分页这些毒瘤;再配上合理的分片、克制的建模和及时的段合并。面试时按这个分层展开,每层带一个踩坑故事,基本能把面试官聊开心。